이 글의 핵심 3줄
- 경사 하강에는 모든 가중치의 기울기(그래디언트)가 필요하다. 가중치를 하나씩 흔들어 재면 10만 개 가중치에 순전파를 20만 번 돌려야 하지만, 역전파는 순전파 한 번과 그와 비슷한 양의 계산 한 번으로 전부 구한다.
- 역전파는 미분의 연쇄 법칙(chain rule)을 손실에서부터 거꾸로 적용하는 것이다. 각 연산은 "받은 그래디언트에 자기 미분을 곱해 넘겨주기"만 하면 된다.
- NumPy로 784-128-10 신경망을 직접 짜서 손글씨 숫자(MNIST)를 학습하면, 맥 M1 Max CPU에서 1.6초 만에 테스트 정확도 97.7%가 나온다.
AI Note 시리즈의 두 번째 글이다. 1편에서 신경망은 뉴런을 층으로 쌓은 함수이고, 학습은 손실을 경사 하강으로 줄이는 일이라고 했다. 그런데 경사 하강을 하려면 모든 가중치에 대해 "이 가중치를 조금 바꾸면 손실이 얼마나 바뀌나", 즉 그래디언트 를 알아야 한다. 이 글은 그것을 효율적으로 구하는 방법인 역전파(backpropagation)를 작은 숫자 예제부터 차근차근 따라간 뒤, 직접 구현해서 실제 데이터로 학습시켜 본다.
1. 왜 역전파가 필요한가
가장 단순한 방법은 가중치를 하나씩 아주 조금 흔들어 보는 것이다(수치 미분).
이 방법은 정확하지만 비싸다. 이 글에서 만들 신경망은 가중치가 101,770개다. 가중치마다 손실을 두 번씩 계산해야 하니, 한 걸음을 옮기는 데 순전파를 약 20만 번 돌려야 한다. 역전파는 같은 결과를 순전파 1번과, 그와 비슷한 양의 역방향 계산 1번으로 얻는다. 차이가 10만 배다. 역전파가 없었다면 지금의 딥러닝은 불가능했다.
2. 출발점: 미분의 연쇄 법칙
역전파는 새로운 수학이 아니라 고등학교에서 배우는 연쇄 법칙을 체계적으로 쓰는 방법이다. 함수가 겹쳐 있으면, 미분은 각 단계의 미분을 곱한 것이다.
예를 들어 을 에서 미분해 보자. 로 두면 이다.
| 단계 | 값 () | 국소 미분 |
|---|---|---|
| 연쇄 법칙 |
전개해서 확인하면 , 로 같다. 여기서 중요한 관찰은 두 가지다. 첫째, 각 단계는 자기 연산의 미분(국소 미분)만 알면 된다. 둘째, 를 계산하려면 순전파 때 구한 가 필요하다. 이 두 가지가 역전파의 전부다.
3. 계산 그래프로 보기
식을 연산 하나하나로 쪼개 화살표로 이은 것을 계산 그래프라고 한다. 를 에서 계산해 보자.
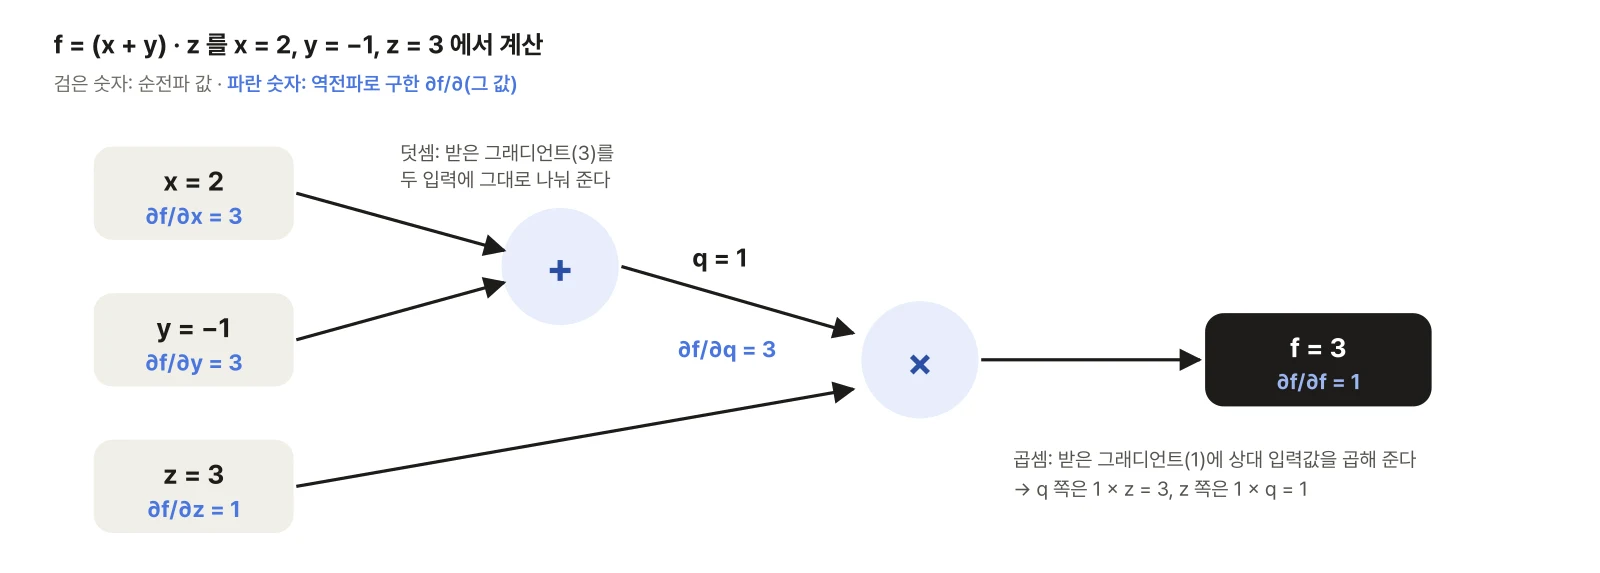
- 순전파 (왼쪽 → 오른쪽): , .
- 역전파 (오른쪽 → 왼쪽): 출발점은 이다.
- 곱셈 : , . 곱셈은 받은 그래디언트에 상대편 입력값을 곱해 넘겨준다.
- 덧셈 : 이므로, 받은 그래디언트 3을 그대로 두 입력에 넘긴다. 그래서 .
검산: 를 2에서 2.01로 바꾸면 으로 0.03 늘어난다. 0.01 바꿨을 때 0.03이니 기울기 3이 맞다.
여기서 얻는 규칙을 기억해 두면 어떤 복잡한 식도 같은 방법으로 풀린다.
| 연산 | 역전파 때 하는 일 |
|---|---|
| 덧셈 | 받은 그래디언트를 모든 입력에 그대로 나눠 준다 |
| 곱셈 | 받은 그래디언트에 상대편 입력값을 곱해 준다 |
| ReLU | 순전파 때 이었으면 그대로 통과, 아니면 0 |
| 같은 값이 여러 곳에 쓰임 | 각 경로에서 돌아온 그래디언트를 더한다 |
4. 뉴런 하나로 학습 한 걸음
이제 진짜 뉴런 하나를 한 걸음 학습시켜 보자. 입력 , 가중치 , 편향 , 활성화는 ReLU, 정답은 이고, 손실은 제곱 오차 로 둔다.
순전파
| 단계 | 계산 | 값 |
|---|---|---|
| 가중합 | 1.5 | |
| 활성화 | 1.5 | |
| 손실 | 2.25 |
역전파 (손실에서 거꾸로)
| 그래디언트 | 계산 | 값 |
|---|---|---|
| −3 | ||
| (이라 ReLU 통과) | −3 | |
| (곱셈: 상대 입력 를 곱함) | −6 | |
| (덧셈: 그대로) | −3 |
업데이트 (학습률 ): , .
다시 순전파하면 , 이다. 한 걸음 만에 정답에 도착했다(이 예제는 숫자가 딱 맞게 고른 것이고, 실제로는 수천 걸음이 필요하다). 그래디언트가 음수였다는 것은 "를 키우면 손실이 준다"는 뜻이고, 그래서 경사 하강이 를 키운 것이다.
5. 층 전체로: 행렬로 쓰기
실제 신경망에서는 뉴런 수백 개를 한꺼번에 다루므로 같은 계산을 행렬로 쓴다. 손글씨 숫자(MNIST)는 28×28 = 784칸 그림이고, 은닉층 128개, 출력 10개(숫자 0~9)인 신경망은 다음과 같다. 는 한 번에 넣는 샘플 수(배치 크기)다.
| 값 | 모양 | 뜻 |
|---|---|---|
| 입력 그림 | ||
| 첫 번째 층 가중치 | ||
| 은닉층 출력 | ||
| 두 번째 층 가중치 | ||
| 숫자별 점수와 확률 |
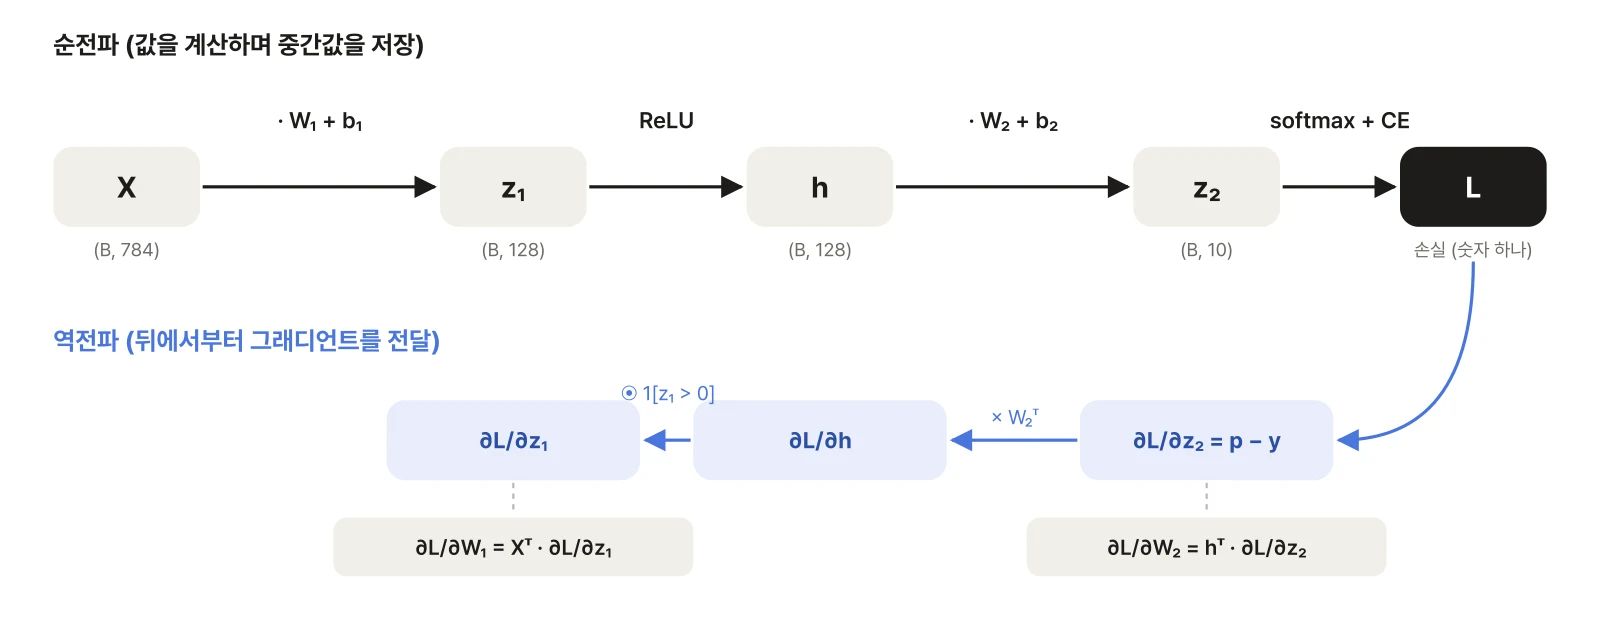
역전파는 4절과 똑같이 손실에서부터 거꾸로 간다.
① softmax + 교차 엔트로피. 1편에서 본 두 함수를 합쳐 미분하면 놀랄 만큼 단순해진다. 샘플 하나에서 이고 이므로, 이다. 이것을 로 미분하면
즉 확률에서 정답 칸만 1을 뺀 것 이다. 1편의 예(확률 0.659, 0.242, 0.099, 정답 0)라면 그래디언트는 다. 정답 점수는 올리고 나머지는 내리라는 신호다. 배치 평균을 쓰므로 로 나눈다.
② 두 번째 층. 는 곱셈과 덧셈이다. 3절의 규칙 그대로, 의 그래디언트는 상대편 입력 를 곱하고, 의 그래디언트는 상대편 를 곱한다.
전치()가 어디에 붙는지 헷갈리면 모양을 맞춰 보면 된다. 는 와 같은 이어야 한다. 가진 재료는 와 뿐이니, 즉 말고는 방법이 없다. 이 곱은 배치의 개 샘플이 각자 낸 그래디언트를 자동으로 더해 준다.
③ ReLU. 순전파 때 음수였던 칸은 0으로 막혔으니 그래디언트도 0이다(는 칸끼리 곱하기).
④ 첫 번째 층. ②와 같은 꼴이다. 입력 의 그래디언트는 필요 없으므로 구하지 않는다.
역전파에 쓰인 , , 는 모두 순전파 때 계산한 값 이다. 2절에서 에 가 필요했던 것과 같다. 그래서 학습할 때는 순전파의 중간값을 역전파가 끝날 때까지 메모리에 들고 있어야 한다. 추론만 할 때보다 학습이 메모리를 훨씬 많이 쓰는 이유다.
6. NumPy로 직접 구현하기
5절의 식을 그대로 코드로 옮겼다. PyTorch 같은 프레임워크 없이 NumPy만 쓴다.
import numpy as np

def forward(p, X):
    z1 = X @ p['W1'] + p['b1']          # (B,128)
    h = np.maximum(z1, 0)               # ReLU
    z2 = h @ p['W2'] + p['b2']          # (B,10) 점수
    z2 = z2 - z2.max(1, keepdims=True)  # 지수가 넘치지 않게 가장 큰 점수를 빼 둔다(결과는 같다)
    prob = np.exp(z2) / np.exp(z2).sum(1, keepdims=True)
    return prob, (X, z1, h)             # 역전파에 쓸 중간값을 남겨 둔다

def backward(p, prob, cache, y):
    X, z1, h = cache
    B = len(y)
    dz2 = prob.copy(); dz2[np.arange(B), y] -= 1; dz2 /= B   # ① 확률에서 정답 칸만 1을 뺀다
    g = {'W2': h.T @ dz2, 'b2': dz2.sum(0)}                   # ② 두 번째 층
    dh = dz2 @ p['W2'].T
    dz1 = dh * (z1 > 0)                                       # ③ ReLU: 음수였던 칸은 0
    g['W1'] = X.T @ dz1; g['b1'] = dz1.sum(0)                 # ④ 첫 번째 층
    return g

# 미니배치 경사 하강: 배치 64, 학습률 0.1, 10 에폭 (배치 나누기는 줄여서 적음)
for epoch in range(10):
    for idx in batches(len(X_train), 64):
        prob, cache = forward(p, X_train[idx])
        for k, v in backward(p, prob, cache, y_train[idx]).items():
            p[k] -= 0.1 * v
편향의 그래디언트가 .sum(0)인 이유는 3절의 마지막 규칙 때문이다. 같은 편향이 배치의 모든 샘플에 더해졌으니(여러 곳에 쓰임), 각 샘플에서 돌아온 그래디언트를 더한다. 가중치는 He 초기화()로 시작했는데, 왜 이렇게 시작하는지는 다음 글에서 다룬다. 전체 코드(데이터 읽기, 측정 포함)는 70줄 남짓이다.
역전파가 맞는지 먼저 검증
역전파 코드는 틀려도 학습이 "어느 정도는" 되기 때문에 버그를 놓치기 쉽다. 그래서 1절의 수치 미분을 검산용으로 쓴다. 작은 모델(20-8-3, 배치 5)에서 모든 가중치에 대해 수치 미분과 역전파 결과를 비교했더니, 가장 크게 어긋난 상대 오차가 였다. 둘이 사실상 같다는 뜻이다. 이 확인을 거친 뒤에 학습을 돌렸다.
학습 결과
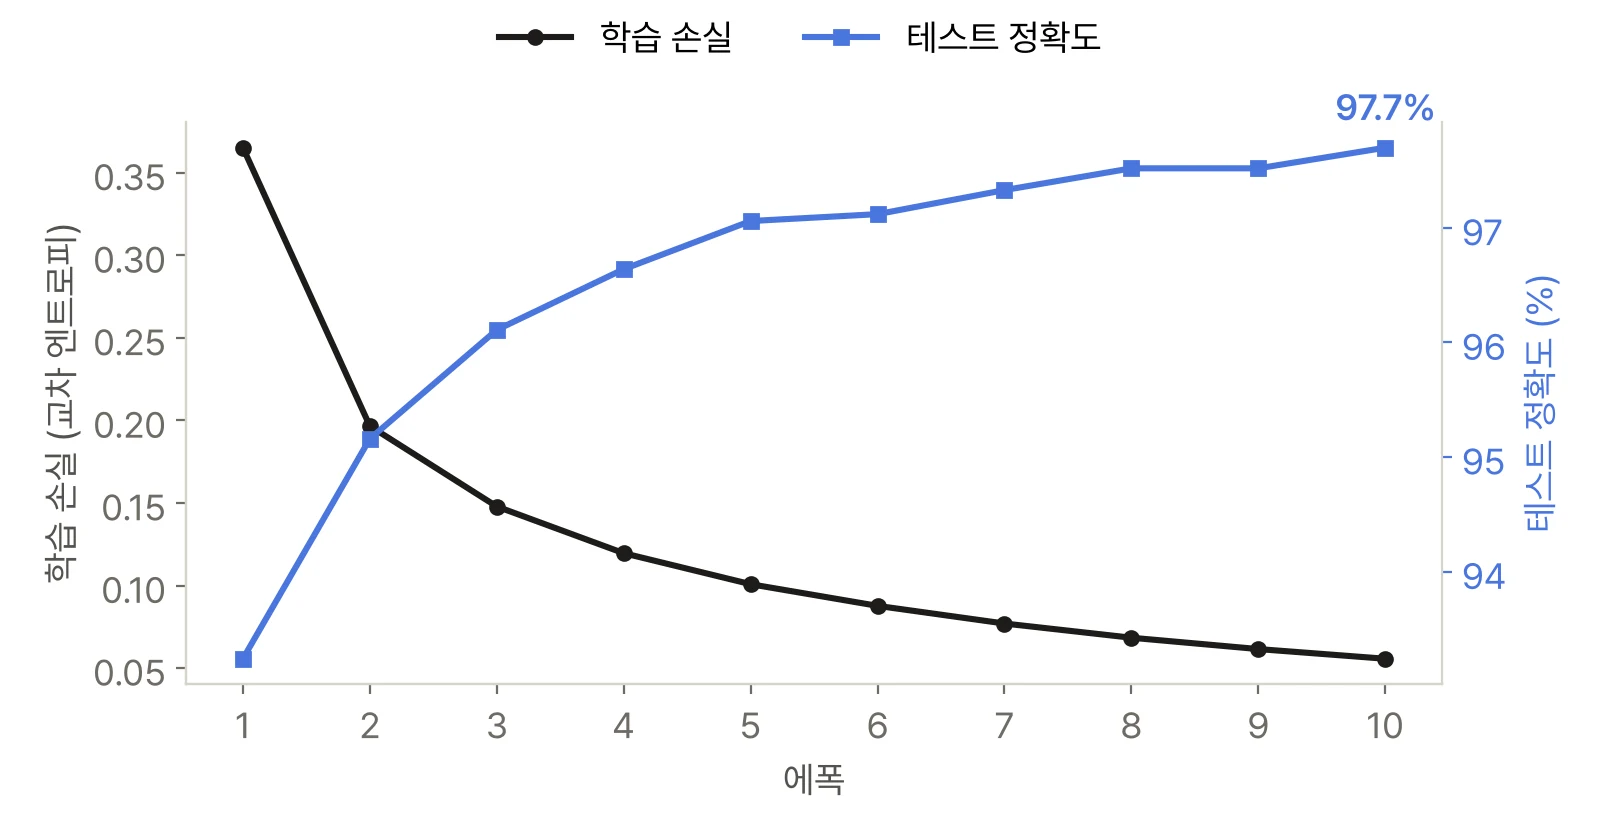
| 에폭 | 1 | 2 | 5 | 10 |
|---|---|---|---|---|
| 학습 손실 | 0.365 | 0.197 | 0.101 | 0.056 |
| 테스트 정확도 | 93.2% | 95.2% | 97.1% | 97.7% |
학습 데이터 6만 장을 10번 도는 데 모두 1.6초(에폭마다 테스트 평가 포함, 에폭당 약 0.16초)가 걸렸다. 장비는 맥북 프로 M1 Max의 CPU다(NumPy 2.5). 첫 에폭에서 이미 93%를 넘고, 이후로는 손실이 천천히 줄며 정확도가 조금씩 오른다. 학습에 쓰지 않은 테스트 그림 1만 장 중 9,770장을 맞힌 것이다. 은닉층 하나짜리 신경망은 98% 언저리에서 더 오르지 않는데, 이 벽을 넘는 것이 4편부터 다룰 CNN이다.
7. 왜 한 장씩이 아니라 미니배치로 학습하나
1편에서 데이터를 64장씩 묶어 한 걸음씩 옮긴다(미니배치)고 했다. 묶는 이유는 두 가지다. 하나는 그래디언트의 질이다. 한 장의 그래디언트는 그 그림 하나에 휘둘려 들쭉날쭉하지만, 여러 장의 평균은 전체 데이터의 방향에 더 가깝다. 다른 하나는 속도다. 같은 코드로 배치 크기만 바꿔 샘플 하나를 처리(순전파+역전파)하는 시간을 재 봤다.
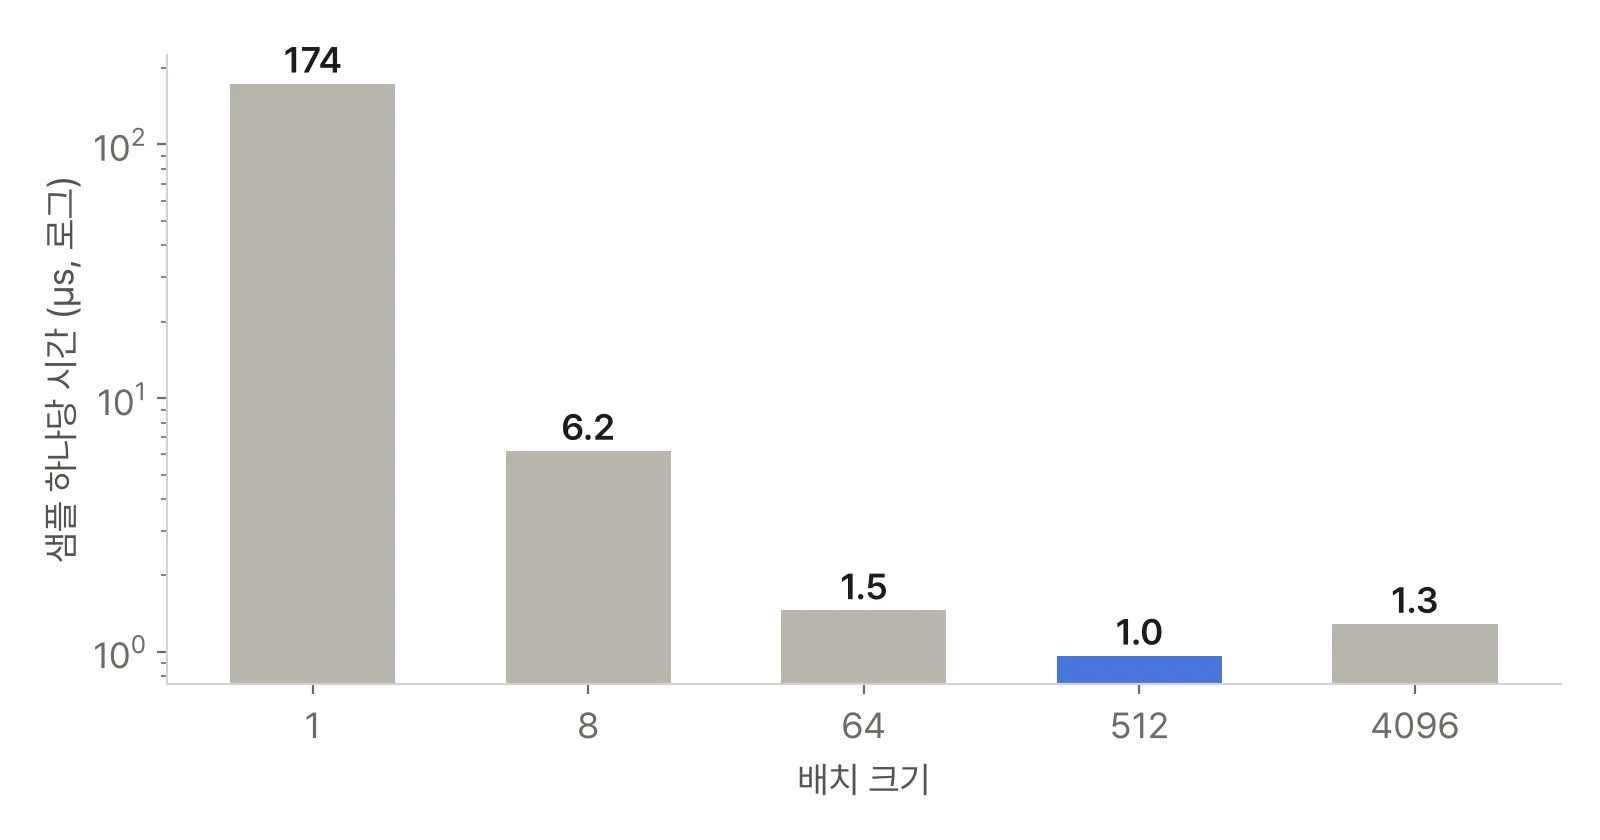
| 배치 크기 | 1 | 8 | 64 | 512 | 4096 |
|---|---|---|---|---|---|
| 샘플당 시간 | 174µs | 6.2µs | 1.5µs | 1.0µs | 1.3µs |
계산량은 샘플당 똑같은데(곱셈·덧셈 약 41만 번), 배치 1과 512 사이에 180배 차이가 난다. 이유는 5절의 행렬곱에 있다. 배치가 1이면 407KB짜리 가중치 을 통째로 메모리에서 읽어 와서 샘플 하나에만 쓰고 버린다. 배치가 512면 한 번 읽은 가중치를 512개 샘플에 재사용한다. 컴퓨터에게는 계산보다 데이터를 가져오는 일이 더 비싸서, 한 번 가져온 데이터를 여러 번 쓸수록 빨라진다. 배치 4096에서 다시 조금 느려진 것은 입력만 12.8MB가 되어 CPU 캐시에 다 들어가지 않았기 때문으로 보인다(추정).
그렇다고 배치를 무작정 키우면 한 에폭에 걷는 걸음 수가 줄어 학습이 오히려 느려질 수 있고, 메모리도 그만큼 더 든다. 그래서 실제로는 수십~수천 사이에서 고른다. GPU는 이런 큰 행렬곱을 한꺼번에 처리하는 데 특화된 장치라, 배치가 클 때 이 차이가 훨씬 커진다.
8. 정리
- 역전파는 연쇄 법칙을 손실에서부터 거꾸로 적용해, 모든 가중치의 그래디언트를 순전파 한 번 정도의 비용으로 구한다. 수치 미분보다 10만 배 싸다.
- 각 연산은 국소 규칙만 알면 된다. 덧셈은 그대로 나눠 주고, 곱셈은 상대 입력값을 곱하고, ReLU는 통과했던 칸만 통과시킨다.
- softmax + 교차 엔트로피의 그래디언트는 "확률 − 정답(원핫)"이다. 행렬 그래디언트의 전치 위치는 모양을 맞추면 저절로 정해진다.
- 역전파는 순전파의 중간값을 다시 쓴다. 그래서 학습은 추론보다 메모리를 많이 쓴다.
- 직접 구현한 2층 신경망으로 MNIST 97.7%. 역전파 코드는 수치 미분으로 먼저 검증한다.
다음 글: 이번에는 He 초기화와 학습률 0.1을 별 설명 없이 썼다. 3편에서는 초기화를 잘못하면 무슨 일이 생기는지, 그리고 SGD·Momentum·Adam 같은 최적화 방법과 정규화가 학습을 어떻게 바꾸는지 같은 실습으로 비교한다.
참고 문헌
- D. E. Rumelhart, G. E. Hinton, R. J. Williams, "Learning representations by back-propagating errors", Nature 323, 1986.
- K. He et al., "Delving Deep into Rectifiers", ICCV 2015 (He 초기화).
- I. Goodfellow, Y. Bengio, A. Courville, Deep Learning, 6.5절 "Back-Propagation and Other Differentiation Algorithms", MIT Press, 2016.
- Stanford CS231n, "Backpropagation, Intuitions" (계산 그래프로 보는 역전파).
- Y. LeCun, C. Cortes, C. J. C. Burges, MNIST 손글씨 숫자 데이터셋.