이 글의 핵심 3줄
- 신경망의 단위인 뉴런은 "입력에 가중치를 곱해 더하고(가중합), 그 값을 활성화 함수에 통과시키는" 아주 단순한 계산이다.
- 뉴런 하나(퍼셉트론)는 직선 하나로 나뉘는 문제만 풀 수 있다. 실제로 돌려 보면 AND·OR은 몇 에폭 만에 100%가 되지만 XOR은 20에폭 내내 실패한다. 층을 하나 더 쌓으면 XOR도 풀린다.
- 학습이란 "틀린 정도(손실)"를 숫자로 정하고, 그 숫자가 줄어드는 쪽으로 가중치를 조금씩 옮기는(경사 하강) 일이다. 이때 한 번에 옮기는 크기(학습률)가 너무 크면 학습이 발산한다.
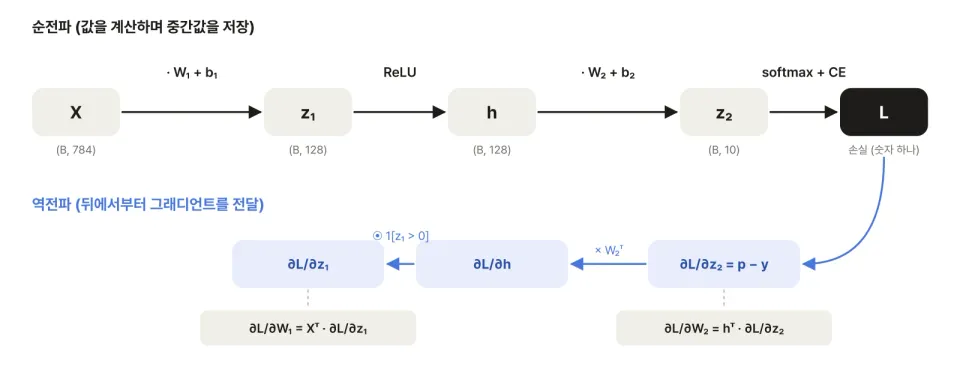
CNN부터 LLM까지 이어지는 AI Note 시리즈의 첫 글이다. 앞으로 나올 모든 모델은 이 글에서 다루는 네 가지 위에 서 있다. 뉴런, 층, 손실, 경사 하강이다. 수식은 고등학교 수학(일차식, 미분의 뜻) 정도면 따라올 수 있게 썼고, 모든 예제는 직접 계산하거나 코드로 돌린 결과다. 다음 글(2편)에서는 여기서 미뤄 둔 "그래디언트를 어떻게 구하느냐", 즉 역전파를 다룬다.
1. 머신러닝은 규칙 대신 데이터로 함수를 맞추는 일
손글씨 숫자 사진을 보고 0~9 중 무엇인지 맞히는 프로그램을 만든다고 하자. 전통적인 방법은 사람이 규칙을 짜는 것이다. "위쪽이 둥글고 아래로 직선이 내려오면 9" 같은 식이다. 하지만 사람마다 글씨가 달라서 규칙은 끝없이 늘어나고 예외는 계속 생긴다.
머신러닝은 방향을 뒤집는다. 규칙을 직접 쓰는 대신, 조절할 수 있는 숫자(가중치)를 잔뜩 가진 함수를 하나 준비하고, 정답이 붙은 예제(데이터)를 보여 주며 그 숫자들을 맞춰 나간다.
신경망은 이 "조절할 수 있는 함수"를 만드는 한 가지 방법이다. 그 가장 작은 단위가 뉴런이다.
2. 뉴런 하나: 가중합과 활성화
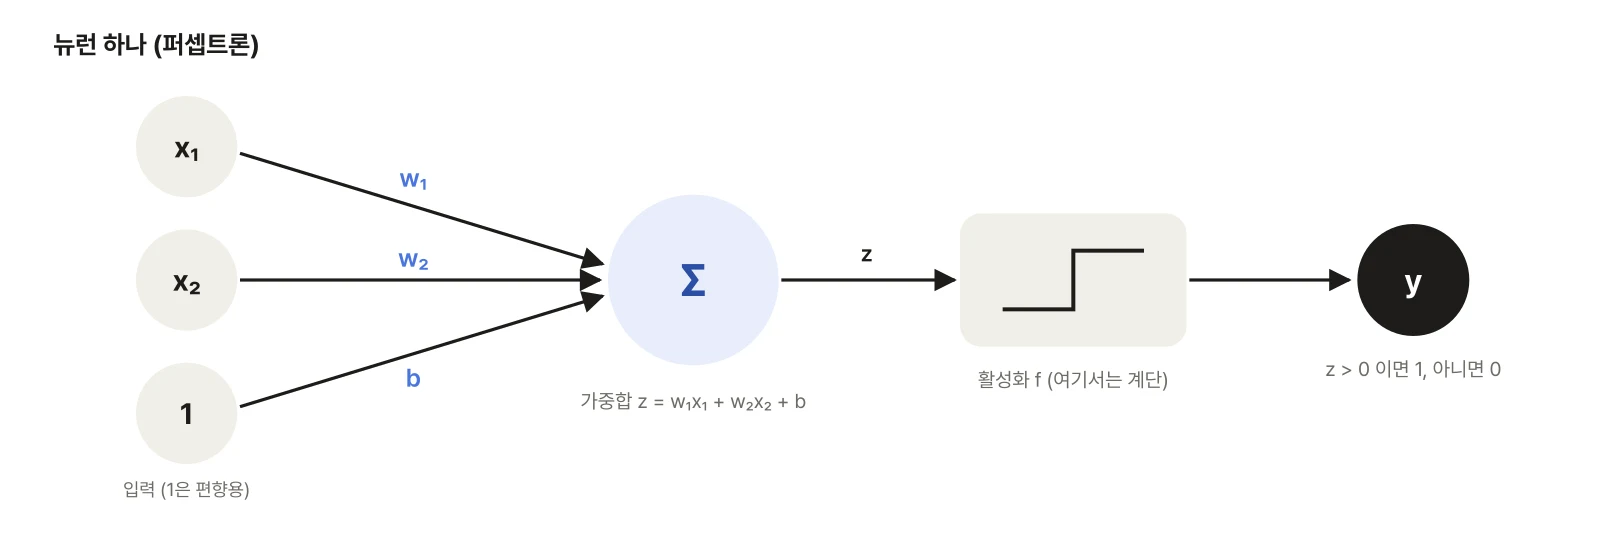
뉴런 하나가 하는 일은 두 단계다.
- 가중합: 입력마다 가중치를 곱해 모두 더하고, 편향(bias) 를 더한다.
- 활성화: 를 활성화 함수 에 넣어 출력을 정한다. 가장 오래된 형태인 퍼셉트론(Rosenblatt, 1958)은 계단 함수를 쓴다. 이면 1, 아니면 0이다.
가중치 는 "이 입력이 얼마나 중요한가", 편향 는 "얼마나 쉽게 1을 내는가(문턱)"라고 생각하면 된다.
손으로 계산해 보기: AND 만들기
가 0 또는 1일 때, 둘 다 1이어야 1을 내는 AND를 뉴런 하나로 만들어 보자. , 로 정하면 된다.
| AND | ||||
|---|---|---|---|---|
| 0 | 0 | −1.5 | 0 | 0 |
| 0 | 1 | −0.5 | 0 | 0 |
| 1 | 0 | −0.5 | 0 | 0 |
| 1 | 1 | 0.5 | 1 | 1 |
편향을 로 바꾸면 하나만 1이어도 이 되어 OR이 된다. 같은 뉴런이 가중치만 바꿔서 다른 논리를 만든다는 점이 핵심이다.
3. 퍼셉트론은 직선 하나로 나눈다
은 평면 위의 직선이다. 뉴런은 이 직선의 한쪽을 1, 다른 쪽을 0으로 나누는 셈이다. 그렇다면 직선 하나로 나뉘지 않는 문제는 어떻게 될까?
가중치를 사람이 정하지 않고 데이터로 배우게 해 보자. 퍼셉트론 학습 규칙은 단순하다. 샘플을 하나씩 보며, 틀렸을 때만 정답 쪽으로 가중치를 민다(는 한 번에 미는 크기).
작은 무작위 값에서 시작해 로 AND, OR, XOR(둘이 다를 때만 1)을 각각 학습시켰다.
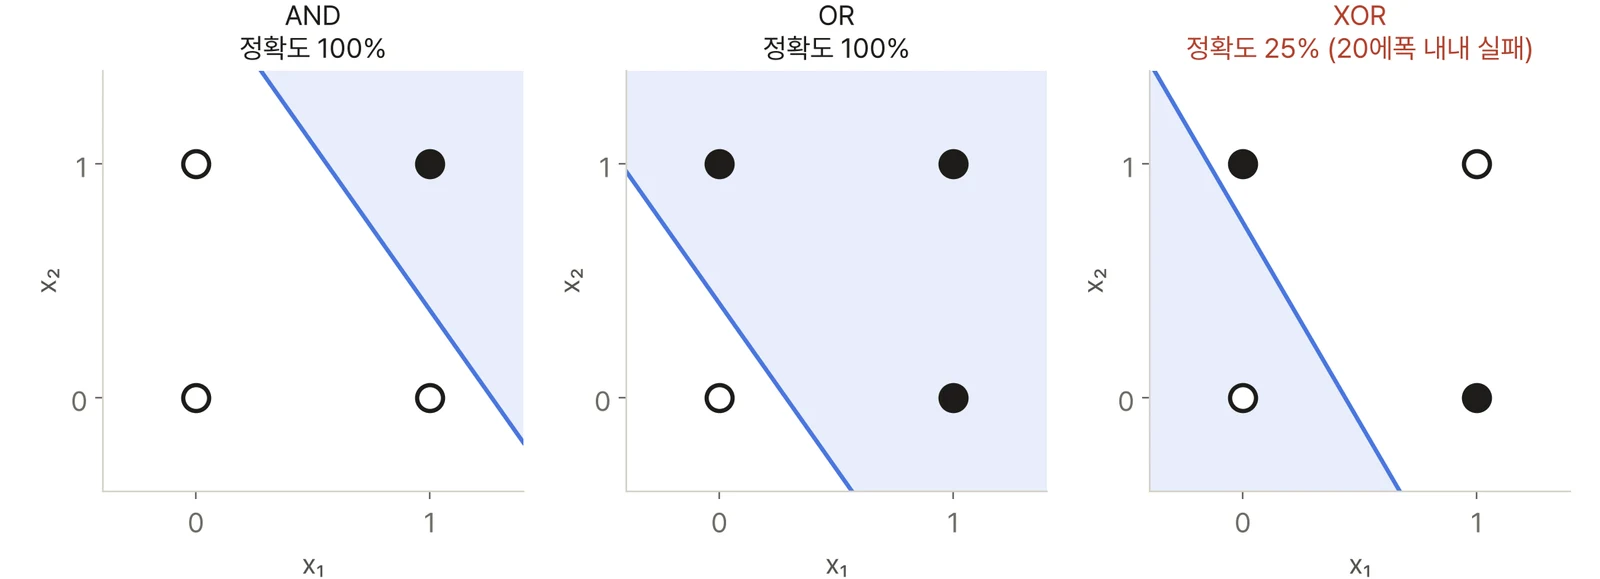
| 문제 | 결과 | 걸린 에폭 | 배운 가중치 |
|---|---|---|---|
| AND | 정확도 100% | 8 | (1.02, 0.72, −1.29) |
| OR | 정확도 100% | 6 | (1.02, 0.72, −0.29) |
| XOR | 20에폭 뒤에도 실패 | − | 에폭마다 틀리는 개수가 3, 1, 3, 1, 3, 3, 4, 4, …로 0이 되지 않음 |
AND와 OR은 그림처럼 직선 하나로 검은 점(1)과 흰 점(0)이 나뉜다. XOR은 1인 점 과 0인 점 이 대각선으로 엇갈려 있어서, 어떤 직선을 그어도 둘을 나눌 수 없다. 퍼셉트론 학습 규칙은 나눌 수 있으면 반드시 답을 찾지만(수렴 정리), 나눌 수 없으면 영원히 흔들린다. 1969년 Minsky와 Papert가 이 한계를 지적한 뒤 신경망 연구는 한동안 침체기를 겪었다.
4. 층을 쌓으면 XOR이 풀린다
해결책은 뉴런을 층으로 쌓는 것이다. XOR은 말로 풀면 "둘 중 하나라도 1(OR)이면서, 둘 다 1(AND)은 아님"이다. 2절에서 OR과 AND는 뉴런 하나로 만들 수 있었다. 그러니 첫 층에 OR 뉴런과 AND 뉴런을 두고, 둘째 층에서 "OR이고 AND가 아님"을 계산하면 된다.
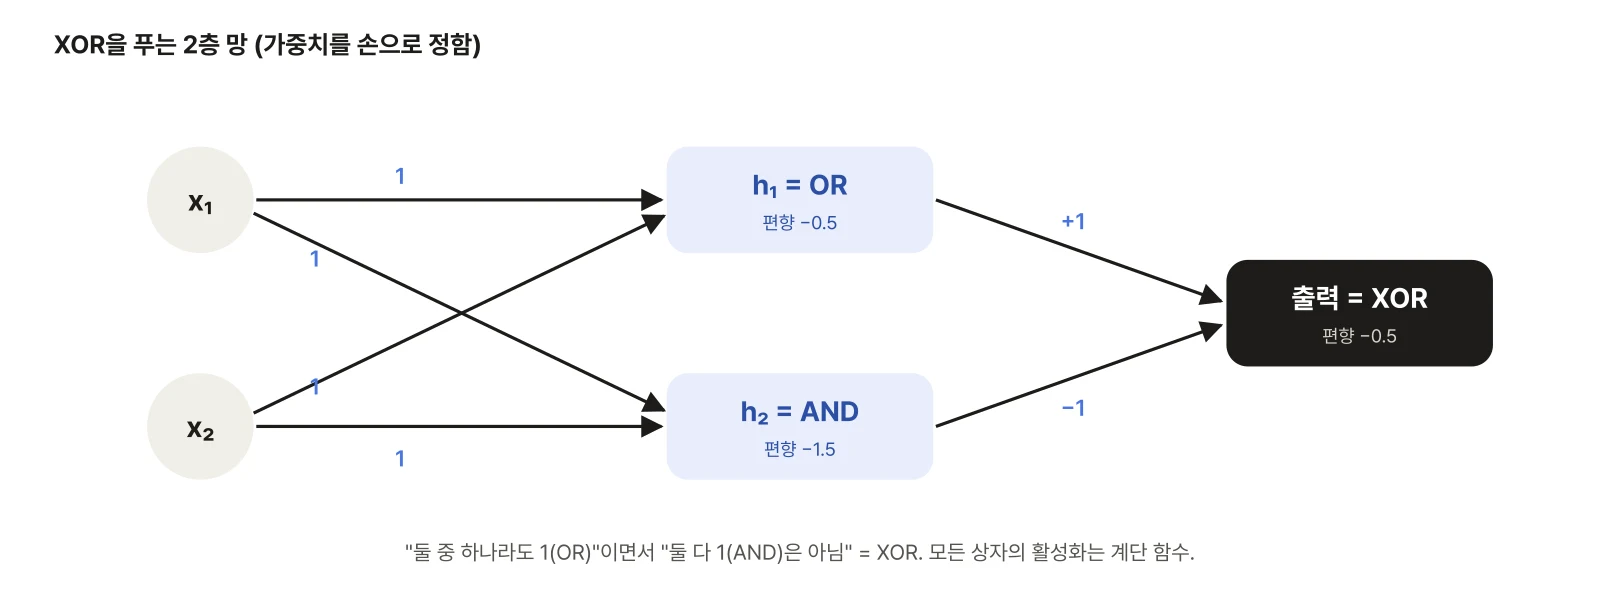
네 입력을 모두 넣어 손으로 따라가 보면 정말 XOR이 나온다. 출력 뉴런은 다.
| (OR) | (AND) | 출력 | XOR | |||
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | −0.5 | 0 | 0 |
| 0 | 1 | 1 | 0 | 0.5 | 1 | 1 |
| 1 | 0 | 1 | 0 | 0.5 | 1 | 1 |
| 1 | 1 | 1 | 1 | −0.5 | 0 | 0 |
첫 층이 입력을 새로운 표현 로 바꿔 주자, 둘째 층 입장에서는 직선 하나로 나뉘는 쉬운 문제가 되었다. 이것이 다층 신경망(MLP) 의 핵심 아이디어다. 층을 지날 때마다 문제를 풀기 쉬운 표현으로 바꿔 나간다. 실제 신경망은 이 표현(가중치)을 사람이 정하지 않고 데이터로 배운다. 그 방법이 다음 글의 역전파다.
5. 활성화 함수: 왜 비선형이어야 하나
층을 쌓을 때 활성화 함수는 반드시 비선형이어야 한다. 만약 처럼 아무것도 하지 않으면, 두 층은 하나로 합쳐진다.
아무리 많이 쌓아도 결국 직선(평면) 하나와 같아서 XOR을 풀 수 없다. 층 사이의 비선형 함수가 "구부러진 경계"를 만들 수 있게 해 준다.
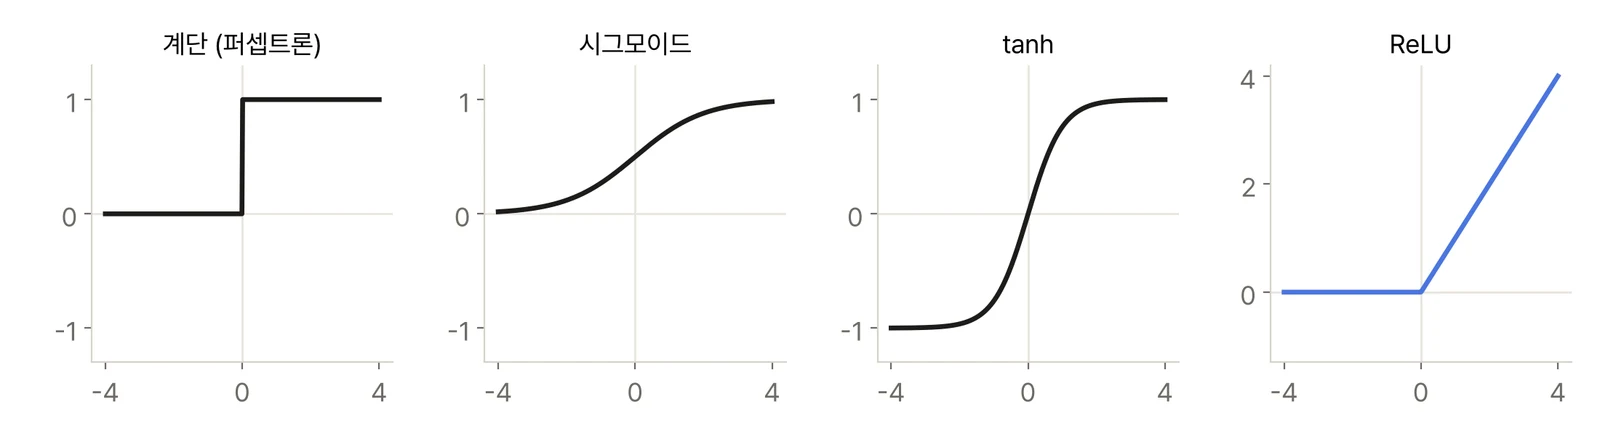
| 함수 | 식 | 특징 |
|---|---|---|
| 계단 | 이면 1 | 퍼셉트론. 기울기가 거의 모든 곳에서 0이라 경사 하강으로 학습할 수 없다 |
| 시그모이드 | 0~1의 부드러운 계단. 확률처럼 해석된다. 가 크면 기울기가 0에 가까워진다 | |
| tanh | −1~1. 출력 평균이 0 근처라 시그모이드보다 학습이 잘 되는 편 | |
| ReLU | 계산이 가장 싸고, 양수 쪽 기울기가 늘 1이다. 지금 가장 널리 쓰인다 |
계단 함수가 학습에 쓰이지 않는 이유가 중요하다. 다음 절의 경사 하강은 "가중치를 조금 바꾸면 출력이 얼마나 바뀌나(기울기)"를 따라 움직이는데, 계단 함수는 거의 모든 곳에서 평평해 기울기가 0이다. 그래서 부드러운 함수(시그모이드, tanh)가 쓰이기 시작했고, 지금은 ReLU가 표준이 되었다.
6. 틀린 정도를 숫자로: 손실 함수
학습하려면 먼저 "지금 얼마나 틀렸나"를 하나의 숫자로 정해야 한다. 이것이 손실(loss) 이다.
분류 문제에서는 마지막 층이 클래스마다 점수를 내고, softmax 가 그 점수를 확률로 바꾼다. 지수 함수를 씌운 뒤 합이 1이 되게 나누는 것이다.
예를 들어 세 클래스의 점수가 이면 확률은 다음과 같다.
| 클래스 | 점수 | 확률 | |
|---|---|---|---|
| 0 | 2.0 | 7.389 | 0.659 |
| 1 | 1.0 | 2.718 | 0.242 |
| 2 | 0.1 | 1.105 | 0.099 |
점수 순서는 그대로이고, 차이는 더 벌어진다. 손실로는 교차 엔트로피 를 쓴다. 정답 클래스의 확률에 를 씌운 값이다.
- 정답이 클래스 0이면 . 정답에 높은 확률을 줬으니 손실이 작다.
- 정답이 클래스 2이면 . 정답에 낮은 확률을 줬으니 손실이 크다.
- 정답 확률이 1이면 , 0에 가까워지면 은 끝없이 커진다.
여러 샘플을 쓸 때는 샘플별 손실의 평균을 쓴다. 이제 학습의 목표는 분명하다. 이 숫자를 최대한 작게 만드는 가중치를 찾는 것 이다.
7. 손실을 줄이는 법: 경사 하강
가중치가 하나뿐인 아주 단순한 경우부터 보자. 손실이 라면 일 때 가장 작다. 하지만 컴퓨터는 이 답을 모른다고 치고, 지금 위치의 기울기 만 보고 내려간다.
- 기울기는 이다. 에서 기울기는 이다. 음수라는 것은 "오른쪽으로 가면 손실이 줄어든다"는 뜻이다.
- 그래서 기울기의 반대 방향 으로 조금 움직인다. 한 번에 움직이는 크기를 정하는 숫자가 학습률 다.
로 손으로 세 번만 계산해 보면 이렇다.
| 반복 | 기울기 | 다음 | |
|---|---|---|---|
| 0 | 0 | −6 | 0.6 |
| 1 | 0.6 | −4.8 | 1.08 |
| 2 | 1.08 | −3.84 | 1.464 |
최솟값에 가까워질수록 기울기가 작아져 걸음도 자연스럽게 줄어든다. 그런데 학습률을 바꾸면 움직임이 완전히 달라진다.
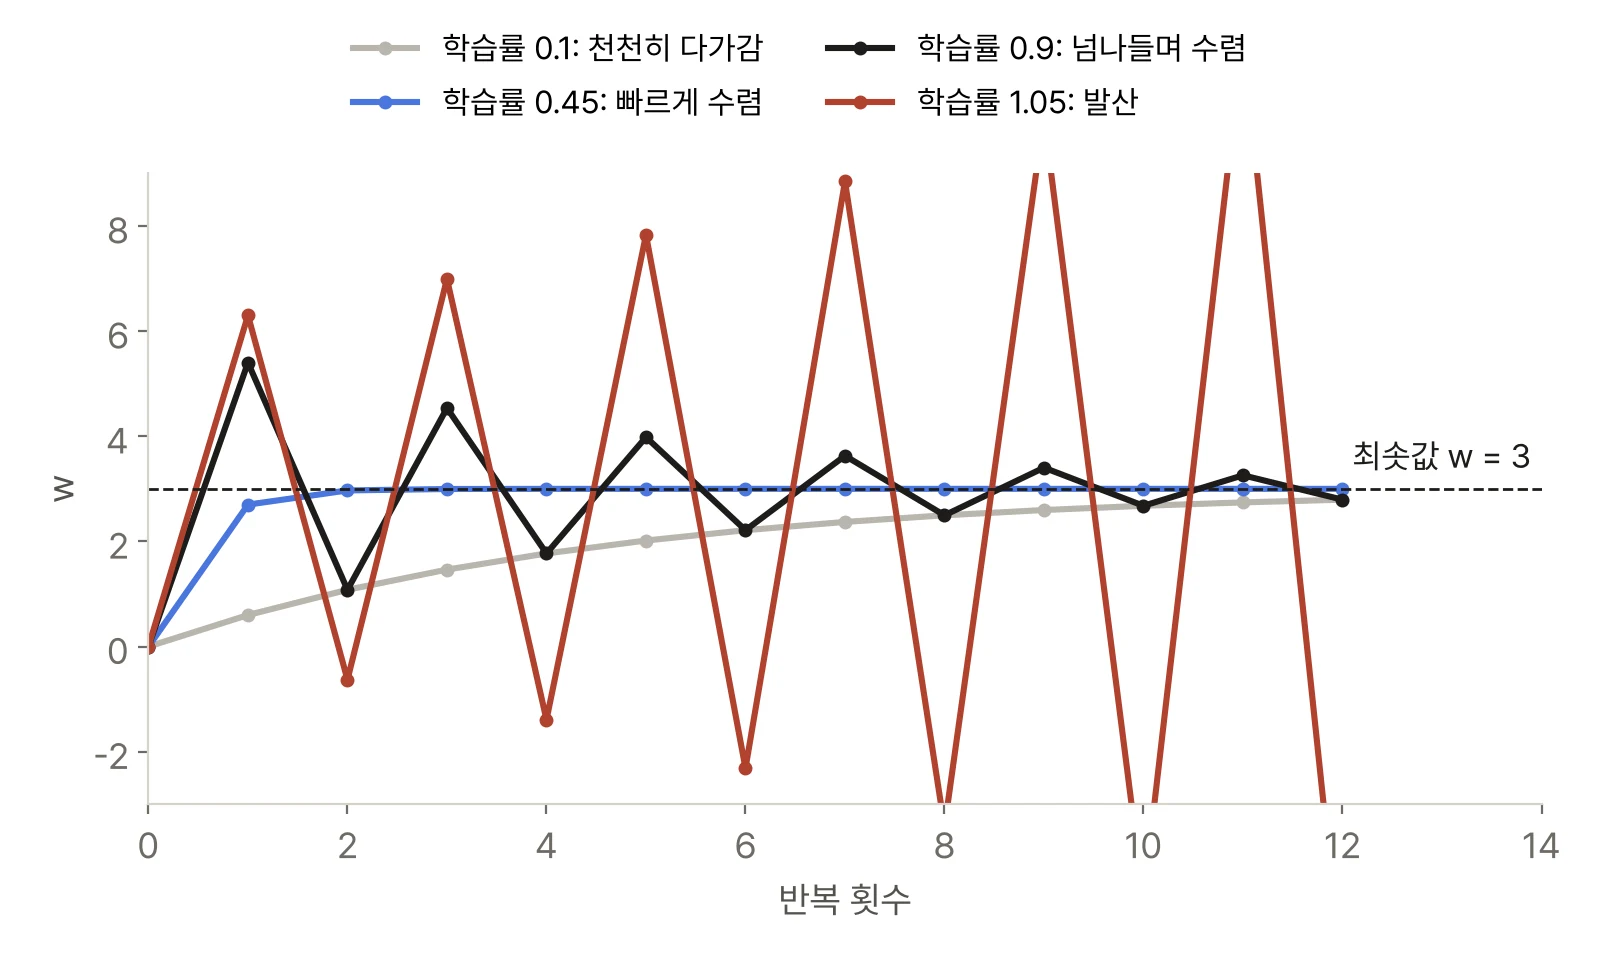
| 학습률 | 처음 몇 걸음의 | 결과 |
|---|---|---|
| 0.1 | 0 → 0.6 → 1.08 → 1.46 → … | 안전하지만 느림 |
| 0.45 | 0 → 2.7 → 2.97 → 3.00 | 빠르게 수렴 |
| 0.9 | 0 → 5.4 → 1.08 → 4.54 → … | 최솟값을 넘나들다 천천히 수렴 |
| 1.05 | 0 → 6.3 → −0.63 → 6.99 → … | 넘나드는 폭이 커지며 발산 |
이 함수에서는 학습률이 1보다 크면 한 걸음에 최솟값을 지나쳐 반대편으로 더 멀리 가 버린다. 실제 신경망의 손실 지형은 가중치가 수백만 개인 울퉁불퉁한 산이지만, 원리는 같다. 모든 가중치에 대해 기울기(그래디언트)를 구하고, 반대 방향으로 조금씩 옮기는 일을 반복한다. 학습률을 고르는 일이 왜 어려운지도 이 그래프 한 장에 담겨 있다.
미니배치와 에폭
데이터가 6만 장이라면, 한 걸음을 옮길 때마다 6만 장 전부의 손실을 계산하기에는 너무 느리다. 그래서 보통은 데이터를 작은 묶음(미니배치, 예: 64장)으로 나눠, 묶음 하나의 평균 손실로 기울기를 어림하고 한 걸음씩 옮긴다(확률적 경사 하강, SGD). 전체 데이터를 한 바퀴 다 보는 것을 에폭(epoch) 이라고 한다. 6만 장을 64장씩 보면 한 에폭에 약 938걸음을 걷는다.
8. 정리
- 뉴런은 가중합 에 활성화 함수를 씌운 것이다. 가중치만 바꿔도 AND, OR 같은 다른 계산이 된다.
- 뉴런 하나는 직선 하나로 나누는 문제만 푼다. 실제로 XOR은 20에폭 내내 풀리지 않았다.
- 층을 쌓으면 앞 층이 문제를 쉬운 표현으로 바꿔 주어 XOR도 풀린다. 단, 층 사이에는 비선형 활성화 함수가 있어야 한다.
- 학습은 손실(분류에서는 softmax + 교차 엔트로피)을 정하고, 경사 하강으로 줄여 나가는 일이다. 학습률이 너무 크면 발산한다.
다음 글: 경사 하강에는 모든 가중치의 기울기가 필요하다. 가중치가 10만 개라면 그 기울기를 어떻게 한꺼번에 구할까? 2편에서는 연쇄 법칙으로 이 문제를 푸는 역전파 를 숫자 예제로 따라가 보고, NumPy로 직접 구현해 손글씨 숫자(MNIST)를 학습시킨다.
실습 코드: 이 글의 모든 숫자(퍼셉트론 학습, XOR 망, softmax 예, 경사 하강)는 NumPy로 직접 계산했다. 퍼셉트론은 시드를 고정한 작은 무작위 값에서 시작했다.
참고 문헌
- F. Rosenblatt, "The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain", Psychological Review 65(6), 1958.
- M. Minsky, S. Papert, Perceptrons: An Introduction to Computational Geometry, MIT Press, 1969.
- I. Goodfellow, Y. Bengio, A. Courville, Deep Learning, 4장(수치 계산과 경사 하강), 6장(Deep Feedforward Networks), MIT Press, 2016.
- M. Nielsen, Neural Networks and Deep Learning, 1장.