이 글의 핵심 3줄
- 16편의 단일 사이클 데이터패스를 IF·ID·EX·MEM·WB 다섯 단으로 자르고, 데이터 해저드는 EX/MEM·MEM/WB 포워딩과 로드-사용 스톨 1사이클로, 레지스터 파일은 "앞 반에 쓰고 뒤 반에 읽기"로 푼다. 포워딩 조건식은
RegWrite ∧ rd≠0 ∧ rd=rs다. - 사이클 단위 모델로 프로그램 5개를 돌려 결과가 QEMU와 모두 같았다. 합계 CPI는 포워딩을 켜면 1.37, 끄면 1.83이었다. 켰을 때 남는 손실 0.37 중 0.36이 분기·점프 플러시이고 로드-사용 스톨은 0.013이었다.
- 포워딩에서 rd≠0을 빼도 컴파일한 5개 프로그램은 맞았다. 그러나 HINT
ntl.all(add x0, x0, x5)을 쓰는 프로그램은 0을 써야 할 256칸에0x80000000을 썼고, "안 쓰는 명령어는 rd=0"으로 디코드하는 설계에서는 6개 프로그램이 모두 틀렸다.
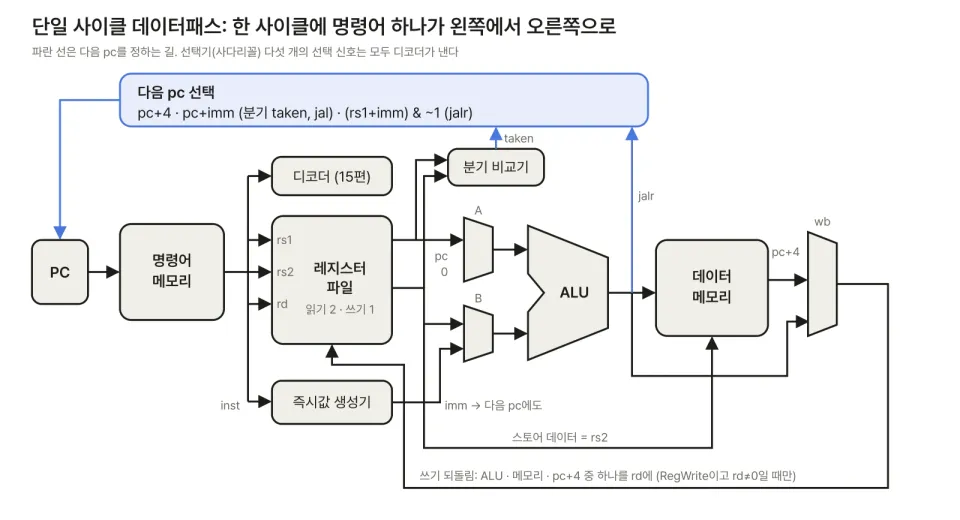
16편의 단일 사이클 코어는 명령어 하나를 한 사이클에 끝낸다. 그 대가로 클록 주기가 가장 느린 명령어(보통 lw) 하나의 길이로 정해진다. 파이프라인(pipeline)은 이 길을 다섯 토막으로 잘라 토막마다 다른 명령어를 동시에 처리한다. 이상적으로는 한 사이클에 명령어 하나가 끝나면서 클록은 다섯 배 가까이 빨라진다. 이 글은 그 "이상적으로"가 깨지는 곳, 해저드(hazard)를 다룬다. 특히 RISC-V의 x0 규칙이 포워딩 조건식에 어떻게 들어가야 하는지를 실제로 틀리는 프로그램으로 확인한다.
1. 다섯 단과 파이프라인 레지스터
16편 그림을 다음 경계에서 자른다.
| 단 | 하는 일 | 끝에 담는 것(파이프라인 레지스터) |
|---|---|---|
| IF | pc로 명령어 읽기, pc+4 | IF/ID: pc, 명령어 |
| ID | 디코드, 즉시값, 레지스터 읽기, 해저드 검출 | ID/EX: pc, 제어 신호, rs1·rs2 값, 즉시값, rs1·rs2·rd 번호 |
| EX | 포워딩 선택, ALU, 분기 판단 | EX/MEM: 제어 신호, ALU 결과(또는 pc+4), 스토어 데이터, rd |
| MEM | 로드·스토어 | MEM/WB: 제어 신호, 쓸 값, rd |
| WB | 레지스터 쓰기 | (레지스터 파일) |
ID/EX에 rs1·rs2 번호를 담는 것을 놓치기 쉽다. 값은 ID에서 읽었지만, 포워딩 검사는 EX에서 하니 번호도 EX까지 따라가야 한다. 제어 신호는 쓰이는 단까지 따라가며 하나씩 떨어진다. ALU 연산은 EX에서, MemRead·MemWrite는 MEM에서, RegWrite·쓰기 되돌림 선택은 WB에서 마지막으로 쓰인다.
모델(17/pipe.py)은 한 사이클마다 WB → MEM → EX → ID → IF 순서로 각 단의 조합 논리를 계산하고, 마지막에 네 파이프라인 레지스터를 한꺼번에 바꾼다. 거꾸로 계산하는 이유는 하드웨어에서 모든 단이 "이번 사이클 시작 때의 레지스터 값"을 보기 때문이다. 앞 단부터 계산하면 같은 사이클에 바뀐 값을 뒤 단이 보는 실수를 하기 쉽다. 빈 칸(버블)은 원인 이름표를 달고 흘러가다 WB에 닿을 때 원인별로 센다. 그래서 사이클 = 완료 명령어 + 원인별 버블이 정확히 맞아떨어진다.
2. 데이터 해저드와 포워딩
CRC-32 안쪽 루프를 GCC가 이렇게 만들었다.
800000a0: srli a3,a5,0x1
800000a4: slli a1,a5,0x1f
800000a8: srai a5,a1,0x1f    # a1: 바로 앞 결과
800000ac: and  a5,a5,a2      # a5: 바로 앞 결과
800000b0: xor  a5,a3,a5      # a5: 바로 앞, a3: 네 칸 앞
800000b4: addi a4,a4,-1
800000b8: bnez a4,800000a0 # a4: 바로 앞 결과srai가 EX에 있을 때 slli는 MEM에 있다. slli의 결과는 EX/MEM 레지스터에 있지만 레지스터 파일에는 아직 없다. srai가 ID에서 읽은 a1은 옛 값이다. 이것이 RAW(쓰기 후 읽기) 데이터 해저드다.
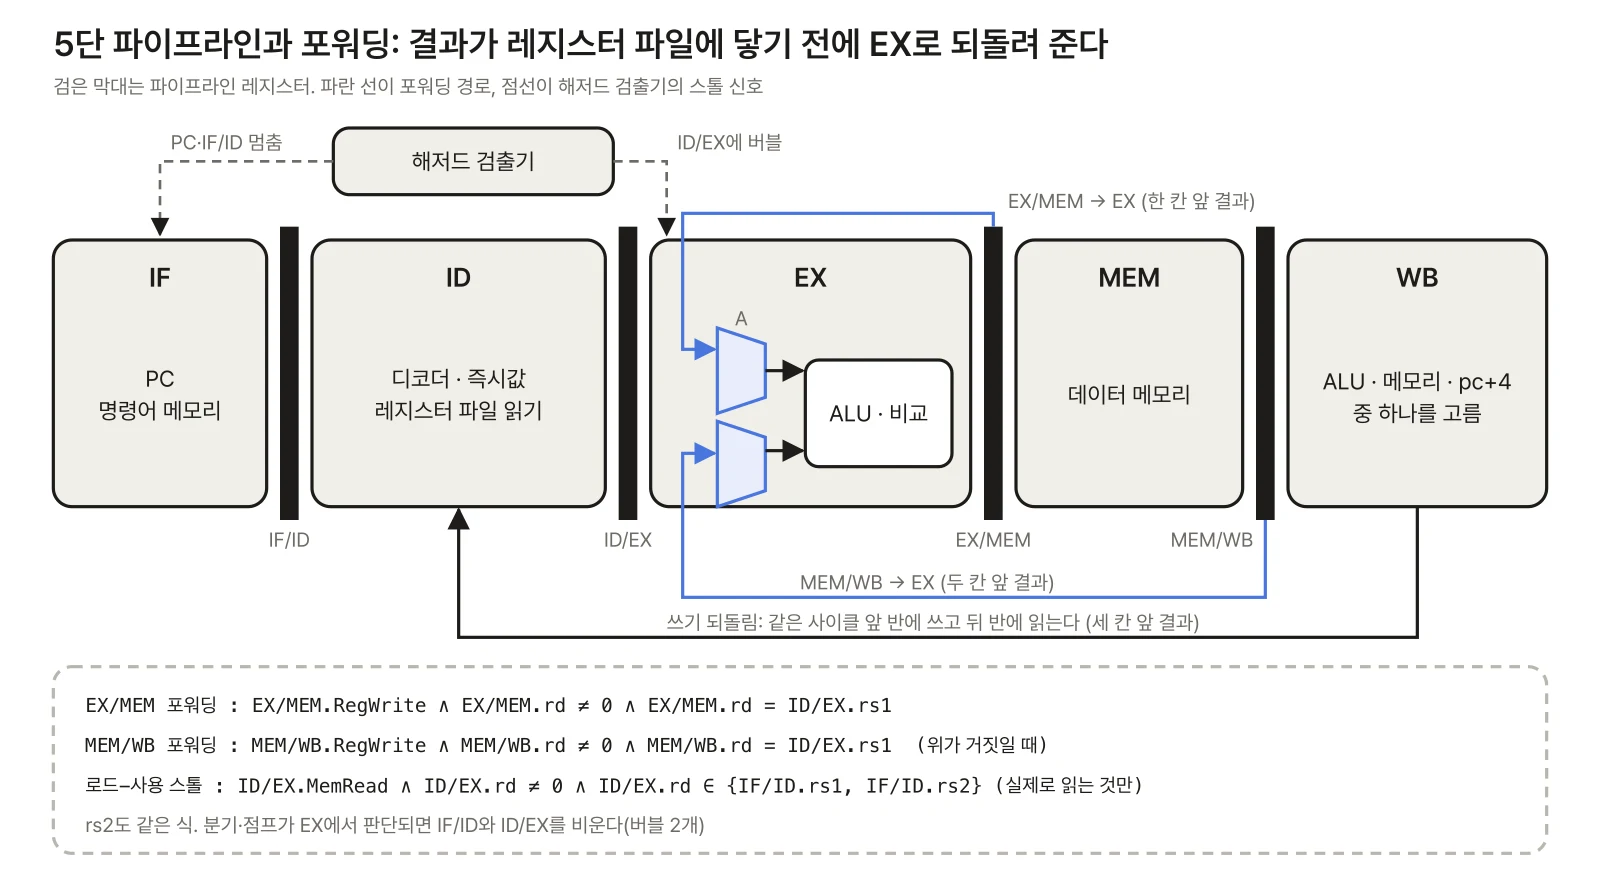
해결은 두 가지다. 값이 레지스터 파일에 닿을 때까지 기다리거나(스톨), 이미 계산된 값을 EX로 되돌려 주거나(포워딩)다. 생산자와 소비자의 거리별로 정리하면 다음과 같다.
| 거리 | 생산자 위치 | 해결 |
|---|---|---|
| 1칸 앞 | MEM (EX/MEM) | EX/MEM 포워딩 |
| 2칸 앞 | WB (MEM/WB) | MEM/WB 포워딩 |
| 3칸 앞 | 레지스터 파일 쓰는 중 | 같은 사이클 쓰기→읽기 |
| 4칸 이상 | 레지스터 파일에 있음 | 그냥 읽기 |
포워딩 선택기(ALU 입력 앞)의 조건은 그림 아래 식과 같다. rs1에 대해 쓰면 다음과 같다(rs2도 똑같다).
if   EX/MEM.RegWrite and EX/MEM.rd != 0
     and EX/MEM.rd == ID/EX.rs1:  A = EX/MEM.result
elif MEM/WB.RegWrite and MEM/WB.rd != 0
     and MEM/WB.rd == ID/EX.rs1:  A = MEM/WB.result
else:                             A = ID/EX.rs1값
순서가 중요하다. 1칸 앞과 2칸 앞이 같은 레지스터를 쓰면 더 최근 것, 즉 EX/MEM이 이겨야 한다. 위 루프의 and a5,a5,a2 다음 xor a5,a3,a5가 그 경우다. srai와 and가 둘 다 a5를 썼는데 xor가 받아야 하는 것은 and의 결과다.
EX/MEM에서 포워딩하는 값이 "ALU 출력"이 아니라 "이 명령어가 레지스터에 쓸 값"이어야 한다는 점도 놓치기 쉽다. jal ra, f의 ALU 출력은 쓸모없는 값이고, ra에 들어갈 값은 pc+4다. 모델은 EX에서 미리 result = pc+4 if wb=='4' else ALU를 만들어 EX/MEM에 담았다.
3. 로드-사용 스톨과 레지스터 파일
로드는 값이 MEM 끝에야 나온다. 바로 다음 명령어가 그 값을 EX 시작에 쓰려면 시간을 거슬러야 한다. 그래서 한 사이클 멈춘다. CRC-32 바깥 루프의 lbu a4,0(a0) 다음 xor a5,a5,a4가 그 경우다.
사이클      1   2   3   4   5   6   7
lbu a4      IF  ID  EX  MEM WB
xor a5,a4       IF  ID  ID  EX  MEM WB
                        ↑ 버블, MEM/WB → EX 포워딩
검출은 ID에서 한다. ID/EX에 있는 명령어(지금 EX에 있는 것)가 로드이고 그 rd가 지금 ID에 있는 명령어의 rs1·rs2와 같으면 PC와 IF/ID를 그대로 두고 ID/EX에 버블을 넣는다. 여기서 15편의 "rs1·rs2를 실제로 읽는가" 신호가 쓰인다. 이것 없이 비교하면 lui·jal의 즉시값 비트가 우연히 맞아 쓸데없이 멈춘다.
3칸 앞 결과는 포워딩이 아니라 레지스터 파일이 풀어 준다. 생산자가 WB에서 쓰는 사이클에 소비자는 ID에서 같은 레지스터를 읽는다. 레지스터 파일을 클록 앞 반(또는 하강 에지)에 쓰고 뒤 반에 읽게 만들면 소비자가 새 값을 본다(DDCA 7.5의 방식). 다른 방법은 레지스터 파일 안에 쓰기 데이터 → 읽기 출력 우회로를 두는 것이다. 어느 쪽이든 없으면 틀린다. 모델에서 이 기능을 끄자 6개 프로그램이 모두 틀렸다(5절).
4. x0: 조건식에 rd≠0이 왜 들어가나
x0에 쓰는 명령어는 결과를 버린다. 그런데 파이프라인 안에서는 그 "버려질 값"이 EX/MEM·MEM/WB에 그대로 실려 다닌다. 조건식에서 rd≠0을 빼면, 뒤따르는 명령어가 x0을 읽을 때 레지스터 파일의 0 대신 그 값을 포워딩받는다. x0을 읽는 명령어는 아주 흔하다. li a0,5(addi a0,x0,5), beqz a0(beq a0,x0), sw zero,0(a5)가 모두 x0을 읽는다.
그러면 x0에 0이 아닌 값을 쓰는 명령어는 무엇인가. 16편 모델로 다섯 프로그램이 실제로 실행한 "rd=x0이면서 RegWrite=1"인 명령어를 셌다.
| 프로그램 | jal x0(j) |
jalr x0(ret) |
그 밖 |
|---|---|---|---|
| qsort | 1,679 | 265 | 0 |
| crc32 | 0 | 1 | 0 |
| fib | 10,945 | 21,892 | 0 |
| matmul | 0 | 4,097 | 0 |
| sieve | 551 | 1 | 0 |
j와 ret은 x0에 pc+4를 "쓴다". 0이 아닌 값이다. 그런데 이 파이프라인에서는 문제가 되지 않는다. 점프는 EX에서 판단되고, 그때 뒤에 따라 들어온 두 명령어는 플러시된다. 점프 목적지의 첫 명령어가 EX에 도착하는 사이클에는 점프가 이미 WB를 지나 파이프라인을 떠났다. 포워딩할 대상이 남아 있지 않은 것이다. 실제로 rd≠0을 빼고 돌려도 5개 모두 QEMU와 같았다. GCC는 nop 말고는 x0에 연산 결과를 쓰는 코드를 만들지 않고, 이 다섯 프로그램은 nop도 실행하지 않았다.
이것으로 "x0 조건은 필요 없다"고 결론 내리면 틀린다. 두 경우를 확인했다.
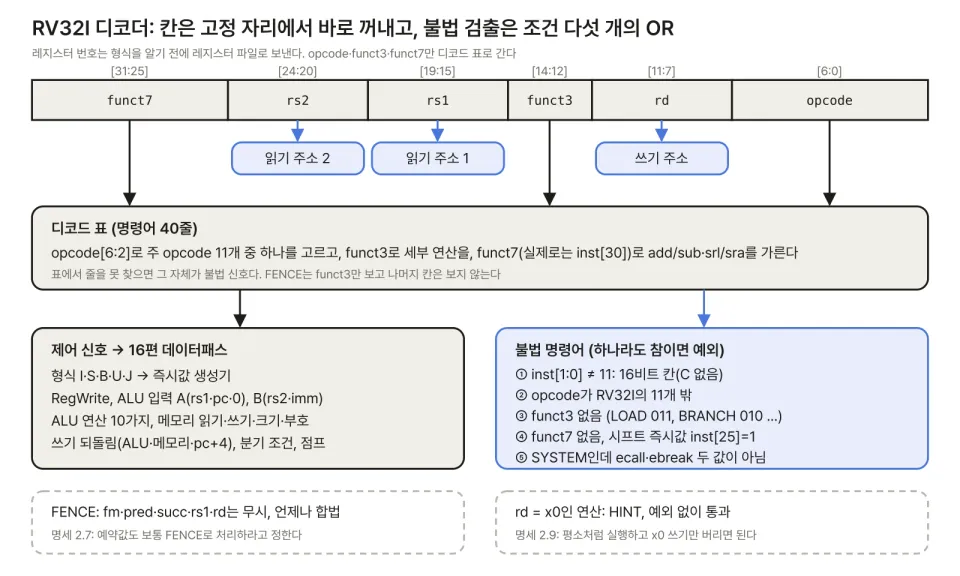
첫째, HINT. 15편에서 HINT는 "평소처럼 실행하고 x0 쓰기만 버리면 되는" 명령어라고 했다. Zihintntl 확장(명세 9장)의 비일시성 힌트 ntl.all은 add x0, x0, x5로 인코딩된다. 다시 쓰지 않을 데이터를 저장할 때 캐시를 덜 오염시키라는 힌트이고, 이 확장을 모르는 RV32I 코어도 그대로 실행할 수 있어야 한다. 버퍼 512칸을 채운 뒤 짝수 칸을 ntl.all을 붙여 0으로 지우는 프로그램(17/progs/ntl.c)을 짰다. 컴파일 결과의 핵심은 두 줄이다.
8000008c: add zero,zero,t0    # ntl.all (HINT)
80000090: sw zero,0(a5) # 0을 저장: x0을 rs2로 읽는다add가 EX에서 계산한 값은 0 + t0 = t0이다. 다음 사이클 sw가 EX에서 rs2=x0을 고를 때, rd≠0 검사가 없으면 EX/MEM의 이 값이 포워딩된다. t0에는 QEMU의 리셋 ROM이 남긴 0x80000000이 들어 있었다.
| 설정 | UART 출력 | 결과 |
|---|---|---|
| QEMU, 정상 모델 | ntl 4aefd727 00000100 00000000 |
0인 칸 256개, buf[0]=0 |
| rd≠0 뺀 모델 | ntl 63a7a3ea 00000000 80000000 |
0인 칸 0개, buf[0]=0x80000000 |
지웠어야 할 256칸 모두에 0x80000000이 들어갔다. 프로그램은 멀쩡히 끝나고 숫자만 틀린다. 가장 찾기 어려운 종류의 버그다.
둘째, RegWrite를 rd로 대신하는 설계. 디코더가 "레지스터를 쓰지 않는 명령어(스토어·분기·FENCE)는 rd를 0으로 내보낸다"고 정해 두면, 포워딩 조건에서 RegWrite를 빼고 rd≠0 ∧ rd=rs만 봐도 된다. 비교기 하나를 아끼는 흔한 방식이다. 이 설계에서 rd≠0까지 빼면, 모든 스토어와 분기의 ALU 결과(주소, 비교용 덧셈 결과)가 뒤따르는 x0 읽기로 포워딩된다.
| 포워딩 조건 | x0 조건 있음 | x0 조건 뺌 |
|---|---|---|
| RegWrite ∧ rd≠0 ∧ rd=rs | 6/6 맞음 | 5/6 맞음(ntl 틀림) |
| rd≠0 ∧ rd=rs (안 쓰면 rd=0) | 6/6 맞음 | 0/6 맞음 |
두 번째 줄의 실패는 요란했다. qsort는 정렬 안 된 주소로 점프해 예외로 멈췄고, fib는 출력 첫 글자부터 깨졌고(rib 10000014…), matmul·sieve·ntl은 끝나지 않았다. 이 방식에서 rd≠0은 "x0 예외 처리"가 아니라 쓰기 여부 그 자체다.
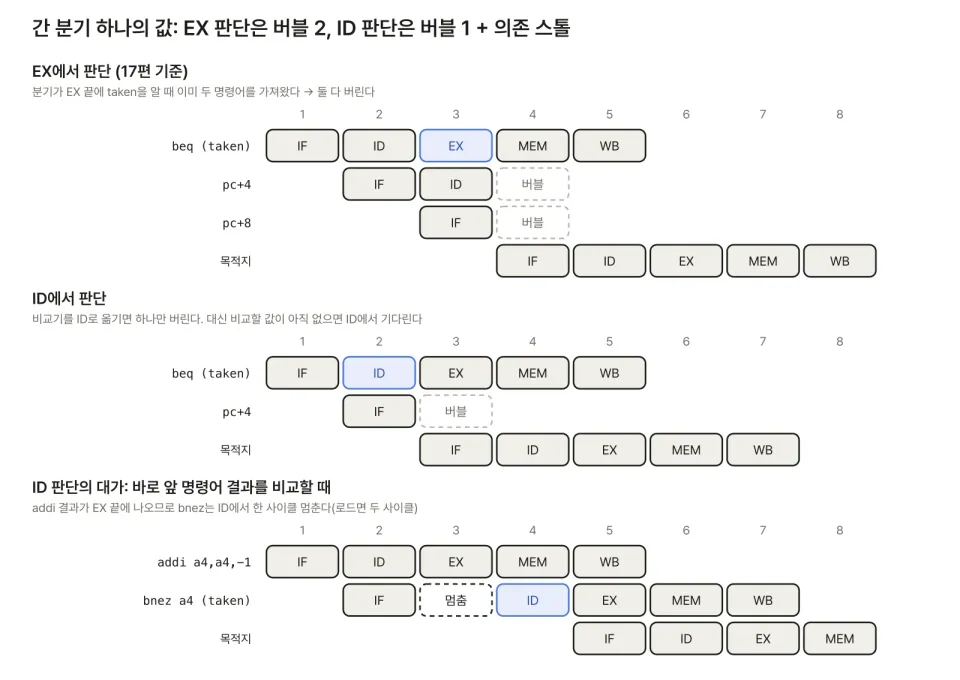
18편에서 하나가 더 나온다. 점프를 ID에서 일찍 판단하면 점프와 목적지 명령어가 파이프라인 안에서 만나게 되고, 그때는 j·ret의 pc+4가 실제로 포워딩된다. EX 판단에서 숨어 있던 버그가 마이크로아키텍처를 바꾸는 순간 드러나는 것이다. 처음부터 조건식에 rd≠0을 넣어 두는 것이 정답이다.
5. 실습: CPI와 스톨 원인
모델 설정은 분기·점프를 EX에서 판단하고, 그동안 IF는 pc+4로 계속 가져오는(예측 안 함 = not-taken) 기본형이다. 간 분기와 모든 점프는 IF/ID·ID/EX를 비우므로 2사이클을 잃는다. 메모리는 명령어·데이터 모두 1사이클로 가정했다(캐시 없음). 같은 다섯 프로그램을 돌려 16편과 같은 방법으로 QEMU와 대조했고(UART, 완료 순서대로의 pc 열, 최종 레지스터), 포워딩을 켜고 끈 두 경우 모두 6개 프로그램이 일치했다.
def _fwd(self, r, v):              # EX 단 입력 하나
    if not self.o['fwd']: return v
    if self._match(self.exmem, r): return self.exmem.res
    if self._match(self.memwb, r): return self.memwb.res
    return v

def _match(self, p, r):            # 포워딩·해저드 공통
    return (not isinstance(p, str) and p.d.rw
            and p.d.rd == r
            and (r != 0 or not self.o['x0']))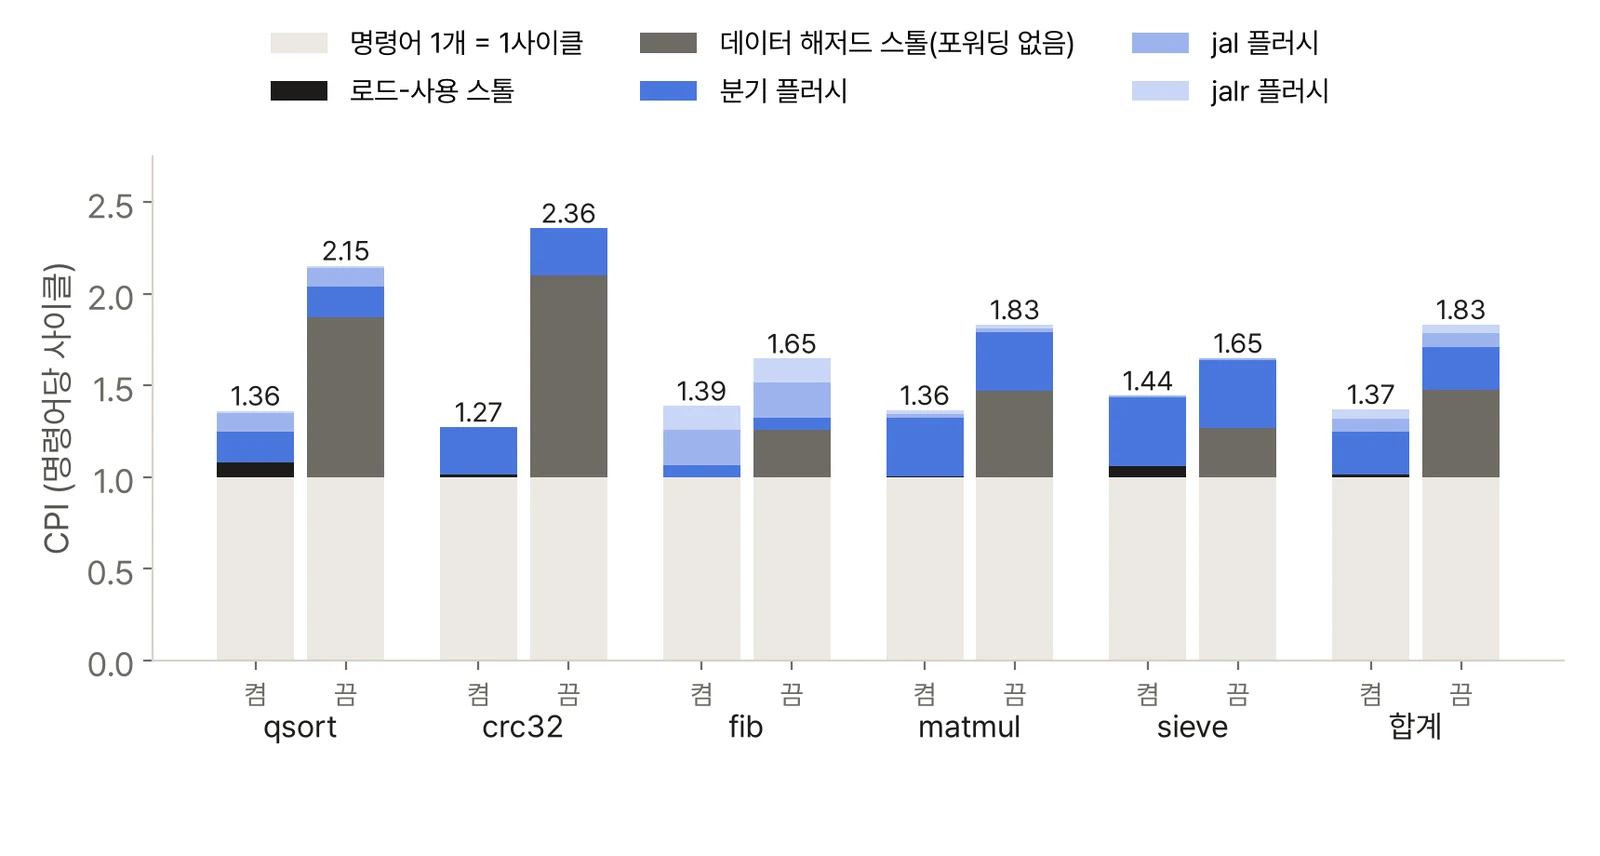
| 손실 원인 (합계) | 포워딩 켬 | 포워딩 끔 |
|---|---|---|
| 로드-사용 스톨 | 13,458 | (데이터 스톨에 포함) |
| 데이터 해저드 스톨 | 0 | 511,397 |
| 분기 플러시 | 251,732 | 251,732 |
jal 플러시 |
78,862 | 78,862 |
jalr 플러시 |
52,512 | 52,512 |
| CPI (1,076,364개) | 1.368 | 1.831 |
숫자를 읽어 보자.
- 포워딩의 효과. 끄면 1칸·2칸 앞 결과를 쓰는 명령어가 최대 2사이클씩 기다린다. 데이터 스톨이 511,397사이클, 명령어당 0.48이었다. crc32는 2.36까지 올라갔다. 위 루프처럼 거의 모든 명령어가 바로 앞 결과를 쓰기 때문이다.
- 켰을 때 남는 것. 로드-사용 스톨은 13,458사이클(명령어당 0.013)뿐이다. 남는 손실의 97%가 분기·점프 플러시다. 16편의 숫자와 맞춰 보면 정확하다. 간 분기 125,866개 × 2 = 251,732,
jal39,431개 × 2 = 78,862,jalr26,256개 × 2 = 52,512다. - 프로그램별. sieve가 1.44로 가장 높았다. 분기가 26%이고 그중 71%가 간다. fib는 점프 플러시가 크고(
jal·jalr합쳐 명령어당 0.32), qsort는 명령어당 로드-사용 스톨이 0.08로 가장 많았다(배열 원소를 읽자마자 비교한다).
포워딩 회로는 32비트 3입력 선택기 두 개와 5비트 비교기 네 개, 그리고 rd≠0 검사뿐이다. 그 대가로 CPI가 1.83에서 1.37로 25% 줄었다. 반면 남은 손실은 대부분 제어 해저드다. 18편이 이것을 다룬다.
6. 설계 체크리스트: 5단 파이프라인
| 항목 | 규칙 |
|---|---|
| 포워딩 조건 | RegWrite ∧ rd≠0 ∧ rd=rs. rs1·rs2 각각, EX/MEM이 MEM/WB보다 우선 |
| 포워딩 값 | ALU 출력이 아니라 쓸 값(jal·jalr은 pc+4) |
| 로드 결과 | MEM 끝에 나오므로 1칸 앞은 스톨, 2칸 앞부터 MEM/WB 포워딩 |
| 해저드 검사 대상 | 실제로 읽는 rs만. U·J 형식의 rs1 자리, I 형식의 rs2 자리는 즉시값 비트 |
| 레지스터 파일 | 같은 사이클 쓰기→읽기 통과(앞 반 쓰기 또는 내부 우회). 없으면 3칸 앞이 틀린다 |
| x0 | 레지스터 파일은 0번에 저장하지 않고, 포워딩·스톨 조건에도 rd≠0 |
| rd를 0으로 바꾸는 디코더 | 쓰지 않는 명령어의 rd를 0으로 내면 RegWrite 비교를 뺄 수 있다. 그때 rd≠0이 쓰기 여부를 대신한다 |
| HINT | 정상 실행되며 x0에 "쓴다". 포워딩에서 걸러지는지 시험 프로그램에 넣는다 |
| 스토어 데이터 | rs2도 포워딩 대상(EX에서 골라 EX/MEM에 싣는다) |
| 플러시 | EX에서 리다이렉트하면 IF/ID·ID/EX 비우기. ID의 스톨보다 우선 |
체크리스트의 HINT 줄은 검증과 이어진다. 컴파일러가 만든 프로그램만으로 시험하면 x0 버그는 통과한다. riscv-tests의 정수 명령어 시험이 TEST_RR_ZERODEST·TEST_IMM_ZERODEST 매크로로 결과를 x0에 쓰는 경우를 따로 시험하는 이유다(34편).
정리
- 5단 파이프라인은 단일 사이클 데이터패스를 IF·ID·EX·MEM·WB로 자르고, 파이프라인 레지스터가 값·제어 신호·레지스터 번호를 다음 단으로 나른다.
- 데이터 해저드는 1칸·2칸 앞은 포워딩, 3칸 앞은 레지스터 파일의 쓰기→읽기 통과로, 로드 바로 뒤는 1사이클 스톨로 푼다. 포워딩으로 합계 CPI가 1.83에서 1.37이 됐다.
- 포워딩을 켠 뒤 남는 손실의 97%는 분기·점프 플러시였다(명령어당 0.36). 로드-사용 스톨은 0.013이었다.
- 포워딩 조건의 rd≠0을 빼면 HINT를 쓰는 프로그램이 틀리고, RegWrite를 rd로 대신하는 설계는 모든 프로그램이 틀렸다. 컴파일한 프로그램이 통과했다고 x0 처리가 맞다는 뜻은 아니다.
다음 글: 18편에서는 남은 손실인 제어 해저드를 다룬다. 분기를 EX에서 판단할 때와 ID로 앞당길 때의 대가(플러시 사이클 대 포워딩·비교기 추가와 임계 경로), 뒤로 가는 분기를 taken으로 보는 정적 예측, 디코드에서 목적지를 알 수 있는 JAL과 레지스터에 의존하는 JALR, 명세가 rd·rs1 번호로 정해 둔 리턴 주소 스택 힌트, 정렬 안 된 목적지 예외를 같은 모델에 넣어 CPI로 비교한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 2.1 프로그래머 모델(x0), 2.9 HINT, 9장 Zihintntl(
ntl.all인코딩). https://github.com/riscv/riscv-isa-manual - D. Harris, S. Harris, Digital Design and Computer Architecture: RISC-V Edition, 2021. 7.5 파이프라인 프로세서(포워딩, 로드 스톨, 레지스터 파일의 하강 에지 쓰기)
- D. Patterson, J. Hennessy, Computer Organization and Design: RISC-V Edition, 2판, 2020. 4.6 파이프라인 개요, 4.7 파이프라인 데이터패스와 제어, 4.8 데이터 해저드: 포워딩 대 스톨
- riscv-tests,
isa/macros/scalar/test_macros.h의TEST_RR_ZERODEST·TEST_IMM_ZERODEST. https://github.com/riscv-software-src/riscv-tests