이 글의 핵심 3줄
- RV64I는 레지스터를 64비트로 넓히고 명령어 12개(
ldsdlwu와 W 명령어 9개)를 더한다. W 명령어는 아래 32비트만으로 계산한 뒤 bit 31을 위 32비트에 복사한다. QEMU에서0x7fffffff + 1은add로0x0000000080000000,addw로0xffffffff80000000이 됐다. - 이 규칙의 목적은 "32비트 값은 언제나 부호 확장된 모양으로 레지스터에 둔다"는 약속이다. 그래서 C의
int→long변환, 비교, 논리 연산에는 명령어가 따로 필요 없고, 덧셈과 시프트에만 W 버전이 있다. lui도 결과를 부호 확장하므로 64비트 상수는 비싸다. 무작위 64비트 상수 5,000개를li로 펼치니 평균 7.887개, 최대 8개 명령어였다. 32비트 상수는 언제나 2개였다. 실행·인코딩 결과 34개가 기준 모델과 모두 일치했다.
2~4편에서 RV32I 40개 명령어를 모두 봤다. 5편은 같은 ISA를 64비트로 넓힌 RV64I다. 리눅스가 도는 응용 프로세서는 거의 다 RV64라서, 나중에 RV64GC 코어를 만든다면 이 편의 규칙이 데이터패스 곳곳에 들어간다. 명세의 RV64I 장(4장)은 RV32I와 다른 점만 적는다. 이 글도 그렇게, 무엇이 넓어지고 무엇이 더해지는지, 그리고 왜 그렇게 만들었는지를 본다.
실습은 qemu-system-riscv64(11.1.3)의 virt 보드에서 베어메탈로 했다. 컴파일은 riscv64-elf-gcc 16.2, -march=rv64i -mabi=lp64다.
1. 무엇이 넓어지고 무엇이 더해지나
XLEN이 64가 된다. 레지스터 x1~x31과 pc가 64비트이고, 주소 공간도 64비트다. RV32I 명령어는 이름과 인코딩을 그대로 쓰되, 연산 폭이 64비트가 된다. 예를 들어 add는 64비트 덧셈이고, slt는 64비트 비교다.
새로 생기는 명령어는 12개다.
| 종류 | 명령어 | 하는 일 |
|---|---|---|
| 64비트 메모리 | ld, sd |
8바이트 로드·스토어 |
| 32비트 로드 | lwu |
4바이트를 영 확장 (lw는 부호 확장) |
| W 즉시값 | addiw, slliw, srliw, sraiw |
32비트로 계산 후 부호 확장 |
| W 레지스터 | addw, subw, sllw, srlw, sraw |
32비트로 계산 후 부호 확장 |
W 명령어는 RV32I에 없던 opcode 두 개(OP-IMM-32 0011011, OP-32 0111011)를 쓴다. ld·sd는 funct3 011, lwu는 110이다. 4편의 "funct3[1:0]은 크기, funct3[2]는 영 확장" 규칙이 그대로 이어진다. 크기 11이 8바이트가 됐을 뿐이다.
눈여겨볼 것은 없는 명령어다. andw·orw·xorw도, sltw도, beqw 같은 분기도 없다. 이유는 2절의 약속에 있다.
2. W 명령어와 "부호 확장해 둔다"는 약속
명세는 W 명령어를 이렇게 정의한다. 입력의 위 32비트는 무시하고, 아래 32비트로 계산한 32비트 결과를 64비트로 부호 확장해 rd에 쓴다. 결과의 bit 63부터 bit 31까지가 모두 같아진다.
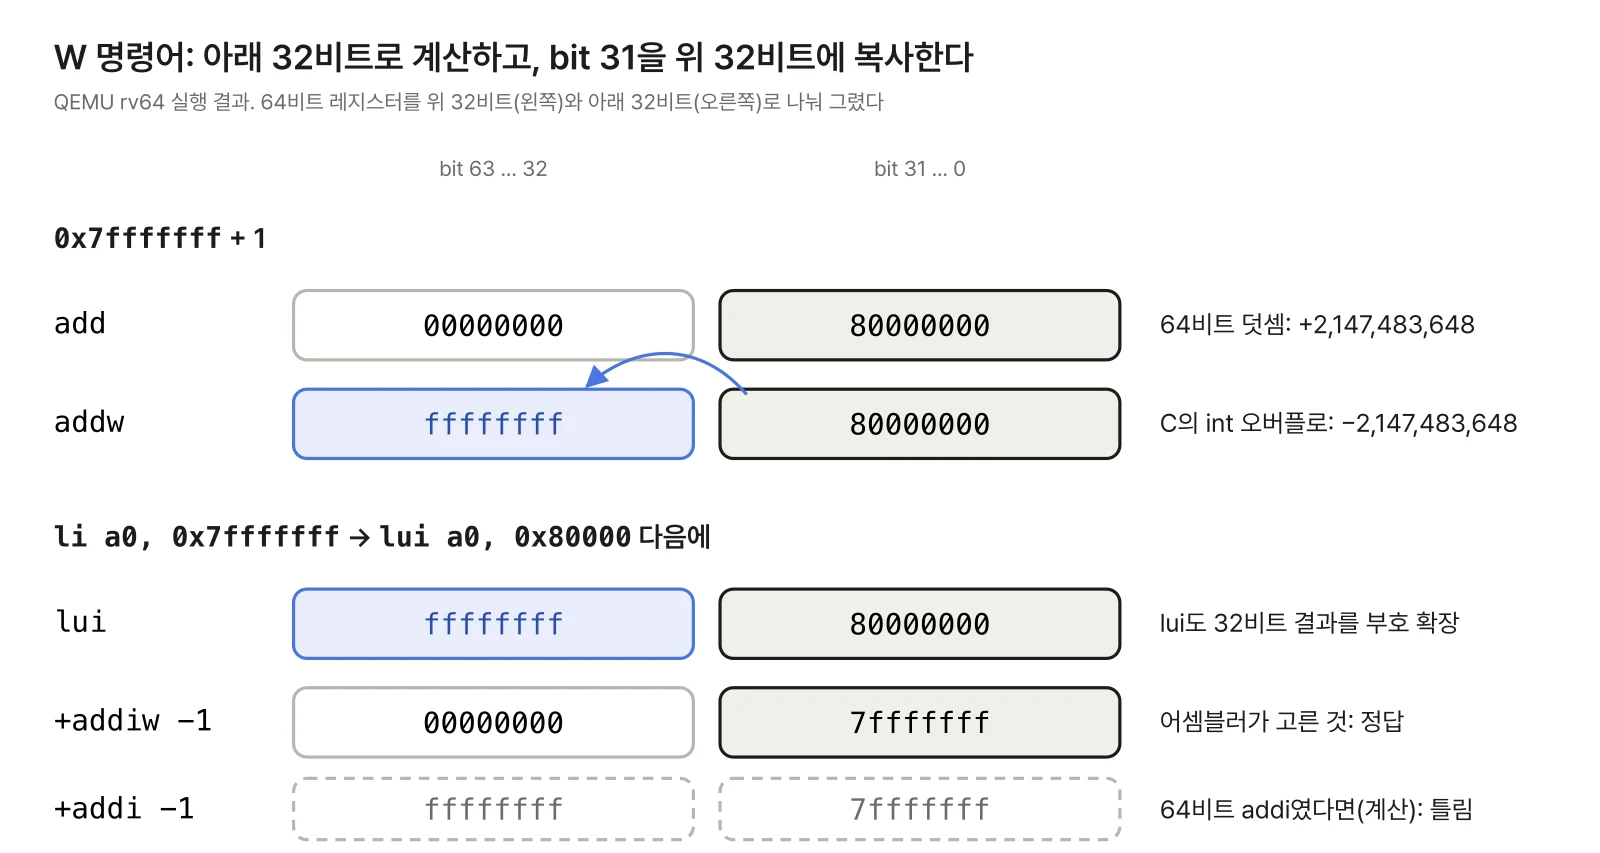
QEMU에서 실제로 실행한 결과다.
연산   rs1               rs2  결과
add    000000007fffffff  1    0000000080000000
addw   000000007fffffff  1    ffffffff80000000
addw   1234567800000001  1    0000000000000002
subw   0000000000000000  1    ffffffffffffffff
addiw  1234567880000000  0    ffffffff80000000
C의 int로 생각하면 addw가 맞는 답이다. int의 0x7fffffff + 1은 32비트에서 한 바퀴 돌아 −2,147,483,648이 되고, 64비트 레지스터에서 그 값의 모양은 0xffffffff80000000이다. 셋째 줄은 위 32비트에 쓰레기(0x12345678)가 있어도 addw가 무시한다는 것을 보여 준다. addiw rd, rs, 0은 아래 32비트를 부호 확장만 하는 명령어가 되어, 의사 명령어 sext.w라는 이름이 붙어 있다.
왜 부호 확장인가
명세의 해설에 핵심이 있다. 컴파일러와 호출 규약은 32비트 값을 언제나 부호 확장된 모양으로 64비트 레지스터에 둔다. 부호 없는 32비트 정수(unsigned)조차 bit 31을 위로 복사해 둔다. 이 약속 하나로 많은 것이 공짜가 된다.
int→long변환: 이미 부호 확장돼 있으니 명령어가 필요 없다.int와unsigned사이 변환: 레지스터 모양이 같으니 명령어가 필요 없다.- 비교와 분기: 부호 확장된 두 32비트 값을 64비트
slt·blt로 비교해도 답이 같다. 부호 없는 비교(sltu·bltu)도 마찬가지다. 위 32비트가 같은 규칙으로 채워져 있어 순서가 보존되기 때문이다. - 논리 연산: 부호 확장된 값끼리
and·or·xor를 하면 결과도 부호 확장된 모양이다.
반면 덧셈·뺄셈·시프트는 32비트에서 넘친 비트가 bit 31 위로 올라가 약속을 깬다. 그래서 이것들만 W 버전이 있다. 명세의 표현대로 W 명령어는 "32비트 값에서 적당한 성능을 내는 데 필요한 몇 개"만 더한 것이다.
실제 컴파일 결과로 확인했다(-O2).
| C 함수 | RV64 명령어 |
|---|---|
int add(int a, int b) |
addw a0,a0,a1 |
unsigned add(unsigned, unsigned) |
addw a0,a0,a1 |
long i2l(int a) |
없음 (ret만) |
int lt(int a, int b) |
slt a0,a0,a1 (64비트 비교 그대로) |
unsigned long u2ul(unsigned a) |
slli a0,a0,32 + srli a0,a0,32 |
마지막 줄이 이 약속의 비용이다. unsigned를 64비트 unsigned long으로 바꾸려면 위 32비트를 0으로 지워야 하는데, RV64I에는 그 명령어가 없어 시프트 두 개를 쓴다. unsigned 인덱스로 배열을 읽을 때도 같은 일이 생긴다(slli 32 + srli 29로 영 확장과 ×8을 한 번에). 이 비용을 줄이려고 Zba 확장에 zext.w(= add.uw rd, rs, zero)가 들어 있다.
1편의 utoa10이 RV64에서 커진 이유
1편에서 utoa10(부호 없는 32비트를 10진 문자열로)이 RV64에서 더 커졌다. 이번에 C 확장 없이 rv32im과 rv64im으로 다시 컴파일해 명령어를 셌다. 33개 대 39개였다. 차이는 세 곳에서 났다.
- 나눗셈을 곱셈으로 바꾼 상수
0xcccccccd: RV32는lui+addi2개, RV64는 4개. 이 값은 bit 31이 1이라 부호 확장된 32비트 상수로는 만들 수 없기 때문이다(4절). uint32_t v를 64비트 곱셈에 넣기 전 영 확장:slli+srli2개. Zba를 켜면zext.w1개가 되어 38개로 줄었다.- 나머지 2개는 레지스터 배치와 반복문 모양 차이였다.
반대로 n++, v - q*10, '0' + r 같은 32비트 연산은 W 명령어 6개(addiw 2, slliw 2, addw, subw)로 RV32와 같은 개수에 끝났다. W 명령어가 없었다면 이 연산마다 부호 확장(sext.w)이 하나씩 더 붙어야 했을 것이다(추정). W 명령어는 RV32 코드를 RV64로 옮겼을 때 커지는 것을 이 정도에서 막아 준다.
3. 시프트 양: 6비트와 5비트
64비트 시프트는 0~63을 밀 수 있어야 하므로 시프트 양이 6비트가 된다. W 시프트는 32비트 값을 미니까 5비트 그대로다.
연산   rs1               양  결과
sllw   0000000000000001  31  ffffffff80000000
sllw   0000000000000001  32  0000000000000001
sll    0000000000000001  32  0000000100000000
sll    0000000000000001  64  0000000000000001
srliw  ffffffff80000000  4   0000000008000000
srli   ffffffff80000000  4   0ffffffff8000000
sraiw ffffffff80000000 4 fffffffff8000000sllw로 1을 31번 밀면 bit 31이 1이 되어 위가 모두 1로 채워진다. 32번 밀면 아래 5비트(0)만 보므로 그대로 1이다. sll은 6비트를 보므로 32는 진짜 32번이고, 64는 0번이 된다. 오른쪽 시프트 세 줄을 비교하면 W의 뜻이 분명해진다. srliw는 아래 32비트 0x80000000만 0을 채워 밀고(0x08000000), 결과의 bit 31이 0이라 위도 0이다. 64비트 srli는 위 32비트의 1들까지 함께 밀려 내려온다.
인코딩에서는 RV32에서 "inst[25]=1이면 예약"이던 자리가 RV64의 slli·srli·srai에서 shamt[5]가 된다(2편). 반대로 slliw·srliw·sraiw에서 imm[5]가 1인 인코딩은 예약돼 있다. 디코더가 RV32/RV64를 함께 지원한다면 이 한 비트의 의미가 XLEN에 따라 바뀐다.
4. 로드, lui·auipc의 부호 확장, 64비트 상수
메모리에 워드 0x80000000, 그 다음 워드에 0x00000001을 두고 읽었다. lw는 ffffffff80000000, lwu는 0000000080000000, ld는 두 워드를 합쳐 0000000180000000이었다.
lui와 auipc도 RV64에서 바뀐다. 20비트 즉시값을 12비트 밀어 만든 32비트 값을 64비트로 부호 확장한다.
| 명령어 | 실행 결과 | 설명 |
|---|---|---|
lui 0x80000 |
ffffffff80000000 |
bit 31이 1 → 위가 1 |
lui 0x7ffff |
000000007ffff000 |
bit 31이 0 → 위가 0 |
auipc 0xfffff |
pc − 0x1000 |
pc 0x80000398 → 0x7ffff398 |
auipc 0x80000 |
pc − 2 GiB | pc 0x800003b8 → 0x000003b8 |
auipc가 부호 확장되기 때문에 pc 기준 주소는 RV64에서도 앞뒤로 ±2 GiB다. 넷째 줄은 0x800003b8에서 2 GiB 아래인 0x3b8을 정확히 가리켰다.
li 0x7fffffff와 addiw
RV64에서 0x7fffffff를 만드는 과정은 3편의 RV32와 다르다. 어셈블러는 lui a0, 0x80000과 addiw a0, a0, -1을 골랐다. lui가 0xffffffff80000000을 만들고, addiw가 32비트에서 −1을 더해 0x7fffffff로 한 바퀴 돈 뒤 부호 확장한다. bit 31이 0이니 위가 0이 되어 정답 0x000000007fffffff다. 여기서 64비트 addi를 썼다면 0xffffffff7fffffff가 됐을 것이다. RV64의 상수 생성에서 addiw가 필요한 이유다.
같은 이유로 bit 31이 1인 양수, 예를 들어 0x80000000은 lui 하나로 만들 수 없다. 어셈블러는 addiw a0, zero, 1과 slli a0, a0, 31로 만들었다.
64비트 상수는 몇 명령어인가
li가 펼친 결과를 모았다(-march=rv64i, C 없음).
0x7ff                addi
0x800                lui + addiw
0x7fffffff           lui + addiw
0x80000000           addiw + slli
0xffffffff           addiw + slli + addi
0xcccccccd           lui + addiw + slli + addi
0x8000000000000000   addiw + slli
0x123456789abcdef0   lui + addiw + (slli + addi) x3
규칙은 이렇다. 32비트 부호 있는 범위의 값은 3편처럼 lui + addiw(최대 2개)로 끝난다. 그 밖의 값은 위쪽 부분을 먼저 만들고 "12비트 안팎씩 왼쪽으로 밀고 아래 12비트를 더하기"를 되풀이한다. 아래쪽에 0이 많으면 밀기 한 번으로 끝나고, 비트가 꽉 찬 값은 최대 8개까지 간다.
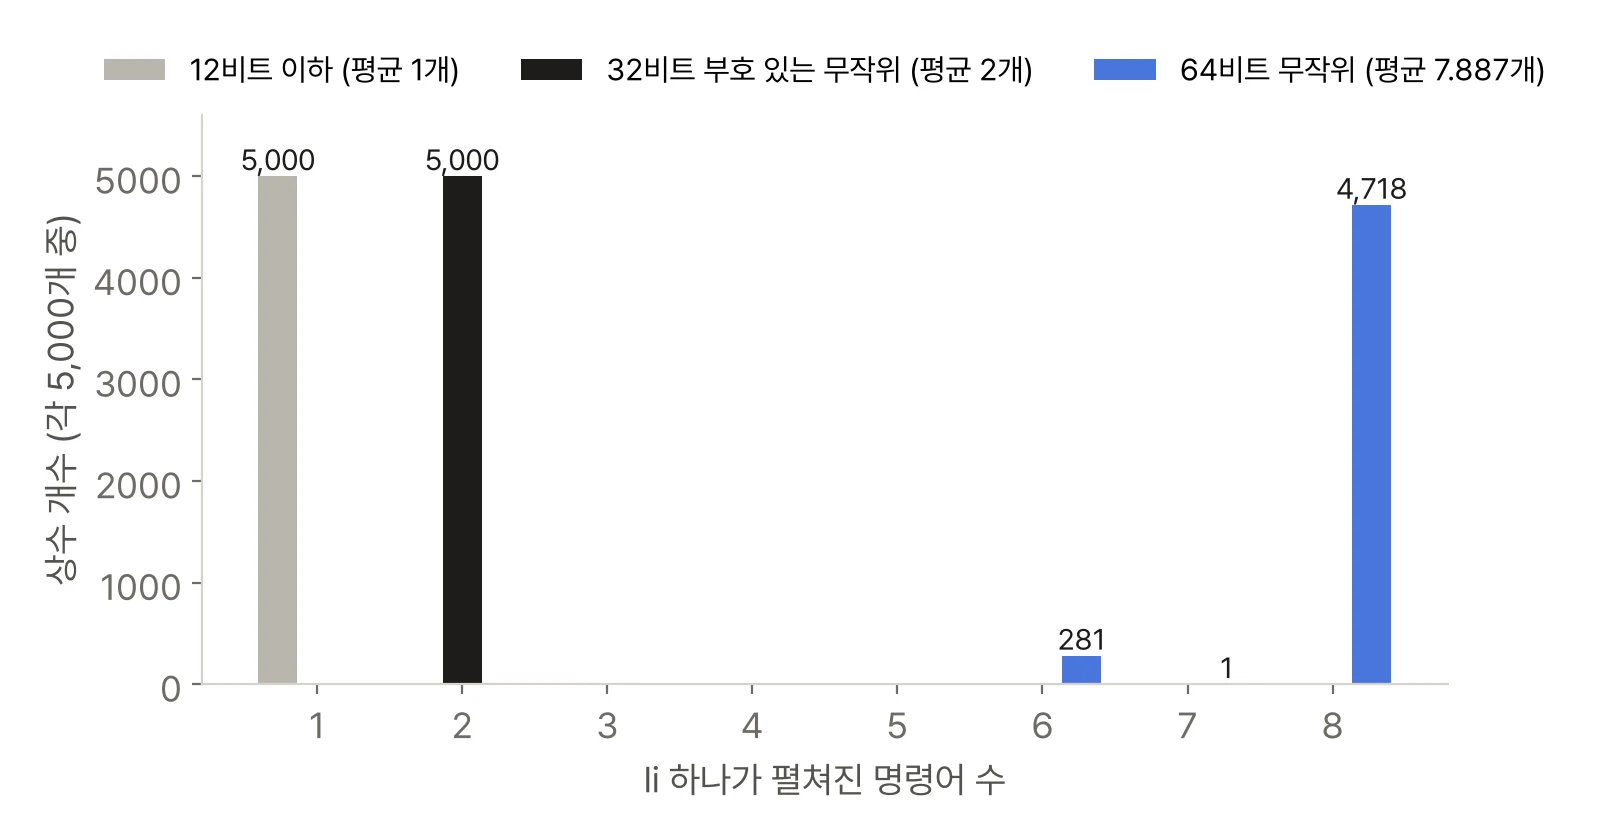
상수 종류별로 5,000개씩 무작위로 뽑아 어셈블했다. 12비트 이하는 모두 1개, 32비트 부호 있는 값은 모두 2개였다. 무작위 64비트 값은 4,718개가 8개, 281개가 6개, 1개가 7개로 평균 7.887개였다. 펼친 명령어를 Python으로 다시 실행해 15,000개 모두 원래 상수가 되는 것을 확인했다.
컴파일러는 다른 방법을 쓴다. GCC -O2는 0x123456789abcdef0을 위 절반과 아래 절반을 두 레지스터에서 따로 만든 뒤 slli 35와 add로 합쳤다. 명령어는 7개지만 두 줄기가 서로 기다리지 않아 슈퍼스칼라 코어에서 빨리 끝난다. 위·아래 32비트가 같은 0x1234567812345678은 한 번 만들어 slli 32 + add로 4개에 끝냈다. 그래도 64비트 상수는 비싸므로, 주소처럼 자주 쓰는 큰 값은 auipc 기준 상대 주소나 메모리의 상수 풀에서 읽는 편이 낫다.
5. 실습: QEMU 실행 결과와 기준 모델 대조
W 명령어는 인라인 어셈블리로 한 개씩 실행하고 64비트로 찍었다.
#define R(op, a, b) ({ uint64_t r_;            \
  __asm__ volatile(op " %0,%1,%2"              \
                   : "=r"(r_) : "r"(a), "r"(b)); r_; })

volatile uint64_t big = 0x7fffffff, one = 1;
show("add",  big, one, R("add",  big, one));
show("addw", big, one, R("addw", big, one));run.sh는 -march가 rv64로 시작하면 qemu-system-riscv64를 고른다. 기준 모델은 Python으로 몇 줄이다. W 연산은 "아래 32비트로 계산 → 32비트로 자르기 → 부호 확장"이다.
sx = lambda v, b: ((v & ((1 << b) - 1))
                   ^ (1 << (b - 1))) - (1 << (b - 1))
w = lambda v: sx(v, 32) & M64      # 32비트 결과 → 64비트
REF['addw'] = lambda a, b: w(a + b)
REF['srlw'] = lambda a, b: w((a & M32) >> (b & 31))
REF['lui'] = lambda a, b: sx(a << 12, 32) & M64| 시험 | 개수 | 일치 |
|---|---|---|
QEMU 실행 (W·시프트·로드·lui·auipc) |
21 | 21 |
li 예시 10개를 다시 실행해 원래 값 |
10 | 10 |
| 무작위 상수 묶음 3개 (각 5,000개) | 3 | 3 |
모두 34개, 전부 일치했다. srlw의 기준 모델을 처음에 w(a >> (b & 31))로 썼다면 위 32비트가 아래로 밀려 들어와 틀렸을 것이다. 명세의 "입력의 위 32비트는 무시"를 그대로 옮겨 a & M32를 먼저 해야 한다. 하드웨어도 마찬가지다.
6. 설계 체크리스트: RV64 데이터패스
| 항목 | 규칙 |
|---|---|
| W 결과 | 아래 32비트 결과의 bit 31을 bit 63:32에 복사 |
| W 입력 | rs1·rs2의 bit 63:32는 무시. 특히 srlw·sraw는 아래 32비트만 민다 |
| 시프트 양 | 64비트는 rs2[5:0], W는 rs2[4:0] |
| 즉시값 시프트 | slli류는 inst[25] = shamt[5]. slliw류의 imm[5]=1은 예약 |
lui·auipc |
32비트 값을 부호 확장. auipc는 그다음 64비트 pc에 더함 |
lw·lwu·ld |
부호 확장·영 확장·그대로. funct3 010·110·011 |
| 없는 W | 논리·비교·분기는 64비트 그대로 쓴다 |
| ALU 구조 | 64비트 덧셈기 결과의 아래 32비트를 부호 확장하는 선택기 하나로 W 처리(흔한 선택) |
| W 시프터 | sraw는 bit 31을 부호로 써야 한다. 64비트 시프터에 넣기 전 입력을 부호/영 확장해 두는 것이 흔한 방법 |
| RV32 모드 | RV64 코어가 mstatus.UXL 등으로 32비트 모드를 지원하면 결과 부호 확장 규칙이 추가된다(선택 기능) |
ALU 구조 줄을 풀어 보자. addw는 64비트 덧셈을 그대로 한 뒤 결과 아래 32비트만 골라 부호 확장하면 된다. 입력 위 32비트가 쓰레기여도 아래 32비트 합은 달라지지 않기 때문이다. 시프트는 다르다. srlw·sraw는 위 32비트가 밀려 내려오면 안 되므로, 시프터에 넣기 전에 입력을 영 확장(srlw)이나 부호 확장(sraw)해 둬야 한다. 3절의 srliw 결과 0x0000000008000000이 이 처리의 정답이다.
정리
- RV64I는 XLEN을 64로 넓히고
ld·sd·lwu와 W 명령어 9개를 더한다. W 명령어는 입력 위 32비트를 무시하고 32비트 결과를 부호 확장한다(0x7fffffff + 1→addw0xffffffff80000000). - 32비트 값은 언제나 부호 확장해 둔다는 약속 덕분에
int→long변환, 비교, 논리 연산은 명령어가 필요 없다.unsigned→unsigned long만 영 확장(slli+srli, Zba의zext.w)이 든다. - 시프트 양은 64비트가 6비트, W가 5비트다.
lui·auipc는 32비트 값을 부호 확장하므로li 0x7fffffff에는addiw가 필요하다. - 64비트 상수는
li로 평균 7.887개(무작위 5,000개), 32비트 상수는 언제나 2개였다. 1편utoa10이 RV64에서 33개 → 39개로 커진 것도 상수 생성과 영 확장 때문이었다.
다음 글: 6편에서는 어셈블리와 ABI를 다룬다. a0~a7·s0~s11 같은 레지스터 이름이 호출 규약에서 어떤 약속인지, 스택 프레임과 프롤로그·에필로그가 어떻게 생기는지 실제 C 함수를 컴파일해 따라간다. 인자가 8개를 넘을 때, 구조체를 돌려줄 때, ilp32·lp64d 같은 ABI 이름의 차이, call·tail·la 같은 의사 명령어의 펼침, 그리고 ELF 재배치와 링커 완화를 readelf·objdump로 본다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 4장 RV64I(4.2 정수 연산, 4.3 로드·스토어), 2.3 즉시값 인코딩. https://github.com/riscv/riscv-isa-manual
- RISC-V Bit-Manipulation ISA-extensions (Zba의
add.uw·zext.w), Version 1.0.0 - RISC-V Assembly Programmer's Manual (
li,sext.w). https://github.com/riscv-non-isa/riscv-asm-manual - RISC-V ELF psABI (LP64 정수 인자의 부호 확장 규칙). https://github.com/riscv-non-isa/riscv-elf-psabi-doc
- D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 9장 RV64