이 글의 핵심 3줄
- RVWMO는 "자기 하트 안에서는 순서대로 보이지만, 다른 하트에게는 일부 순서가 바뀌어 보여도 된다"는 약한 메모리 모델이다. 지켜야 하는 순서(보존 프로그램 순서)는 13개 규칙으로 정해지고, 나머지 순서는
fence나aq·rl로 소프트웨어가 요구한다. - 리트머스 시험 7개를 SC·TSO·RVWMO로 전부 열거하니, 약한 결과가 RVWMO에서는 MP·SB·LB 모두 허용, TSO에서는 SB만 허용됐다.
fence rw,rw는 SB를 막지만fence.tso는 막지 못했다. 열거기는 명세 부록의 예시 결과(a0 ∈ {2, 4, 5})를 그대로 재현했다. - QEMU에서 하트 2개로 시험마다 100만 번 돌렸지만 약한 결과는 한 번도 나오지 않았다. GCC는
memory_order_seq_cst저장을fence rw,w; sw; fence rw,rw로 냈고, Ztso를 켜면 획득·해제용 울타리가 모두 사라졌다.
8편에서 원자 명령어를 보며 "같은 하트의 접근이 다른 하트에게 순서가 바뀌어 보일 수 있다"는 말을 여러 번 했다. 9편은 그 말이 정확히 무슨 뜻인지 다룬다. 메모리 모델(memory consistency model)은 "로드가 어떤 값을 돌려줄 수 있는가"를 정하는 규칙이다. 하트 하나에서는 당연해 보이는 이 질문이, 하트가 여럿이고 각자 저장 버퍼와 캐시를 가지면 전혀 당연하지 않게 된다. 이 편은 ISA 쪽 규칙(RVWMO, fence, Ztso)을 정리하고, 코어 구현에서 무엇을 지켜야 하는지는 체크리스트로 남긴다.
장비는 맥 M1 Max, QEMU 11.1.3, riscv64-elf-gcc 16.2, Python 3(uv)이다.
1. 왜 메모리 모델이 필요한가
하트 하나만 있으면 규칙은 단순하다. 로드는 프로그램 순서상 가장 최근에 같은 주소에 쓴 값을 돌려준다. 코어가 안에서 명령어 순서를 아무리 바꿔도 그 하트 자신에게는 차례로 실행한 것처럼 보이면 된다.
하트가 둘이 되면 문제가 생긴다. 가장 흔한 원인은 저장 버퍼(store buffer)다. 스토어는 캐시에 쓰기까지 시간이 걸리므로, 대부분의 코어는 스토어를 버퍼에 넣어 두고 다음 명령어로 넘어간다. 뒤따르는 로드는 버퍼를 기다리지 않고 메모리로 간다. 하트 자신은 버퍼에서 값을 바로 받으니(전달, forwarding) 아무 문제가 없다. 하지만 다른 하트에게는 "스토어보다 로드가 먼저 일어난 것"처럼 보인다.
손으로 따라가 보자. x, y는 0에서 시작한다.
하트 0          하트 1
sw x ← 1        sw y ← 1
lw r1 ← y       lw r2 ← x
이 두 하트의 명령어를 차례로 끼워 넣는 방법은 4!/(2!·2!) = 6가지다. 6가지를 모두 따라가면 (r1, r2)는 (0, 1) 1번, (1, 0) 1번, (1, 1) 4번 나온다. 어떻게 끼워 넣어도 적어도 한 스토어는 두 로드보다 먼저이므로 (0, 0)은 나올 수 없다. 이렇게 "모든 하트의 접근을 어떤 한 줄로 끼워 넣은 것과 같다"고 보는 모델이 순차 일관성(SC, sequential consistency)이다.
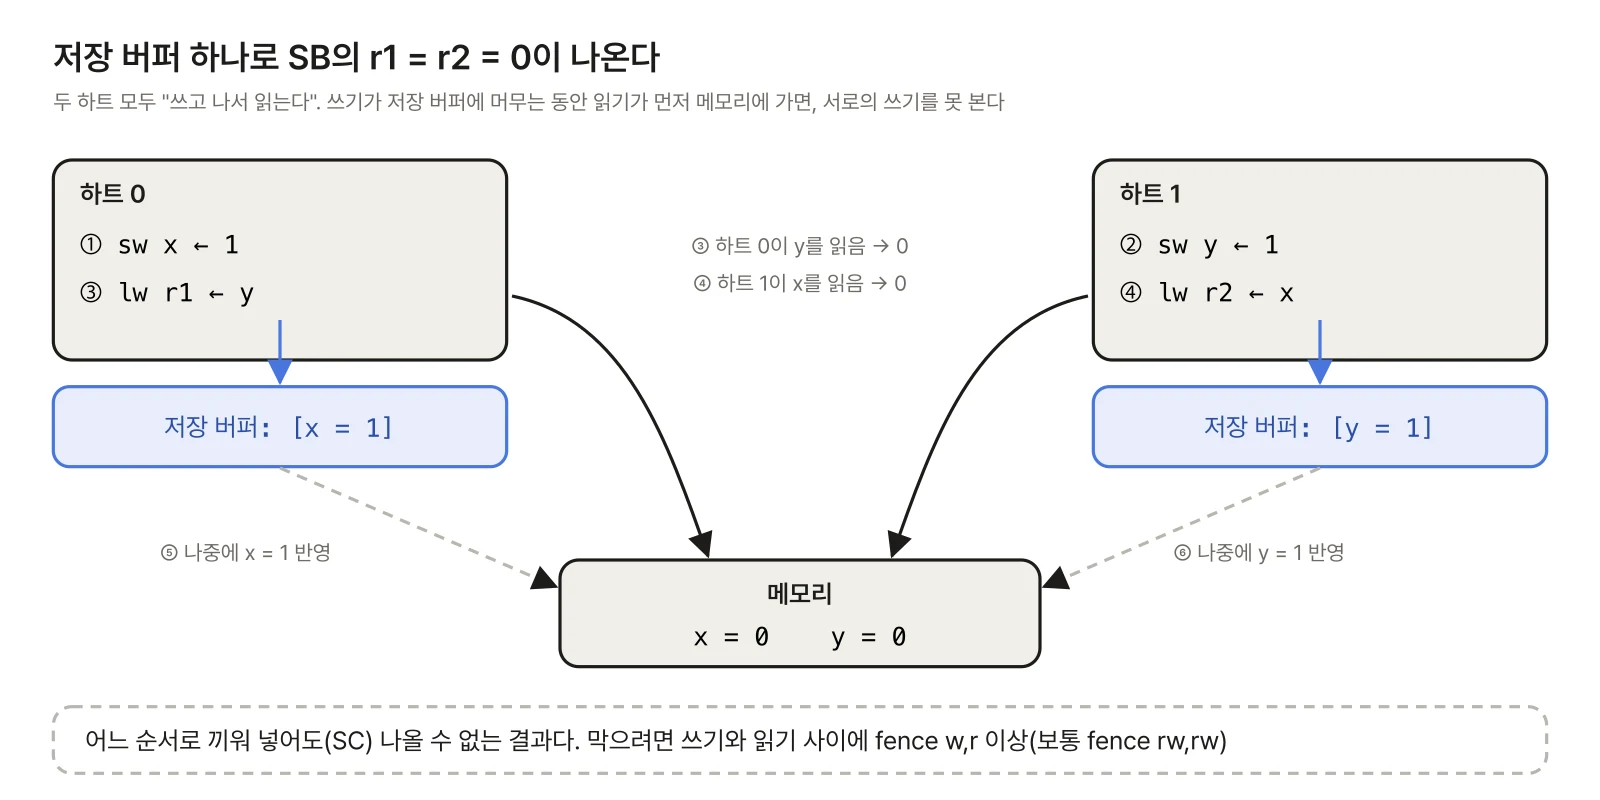
저장 버퍼가 있으면 (0, 0)이 나온다. 두 스토어가 버퍼에 머무는 동안 두 로드가 메모리에서 0을 읽으면 된다. 이 시험을 SB(store buffering)라 부른다. 하드웨어 최적화 하나가 SC를 깨뜨린 것이다. 메모리 모델은 이런 결과 중 무엇을 허용하고 무엇을 금지할지 ISA 차원에서 정한다. 허용 범위가 넓을수록(약한 모델) 하드웨어는 자유롭고, 소프트웨어는 필요한 곳에 순서를 직접 요구해야 한다.
2. 리트머스 시험: MP, SB, LB
메모리 모델은 리트머스 시험(litmus test)으로 이야기하면 쉽다. 하트 둘, 명령어 두세 개짜리 작은 프로그램을 놓고 "이 결과가 나올 수 있는가"를 묻는다. 대표적인 세 가지다.
| 이름 | 하트 0 | 하트 1 | 약한 결과 |
|---|---|---|---|
| MP | x=1; y=1 |
r1=y; r2=x |
r1=1, r2=0 |
| SB | x=1; r1=y |
y=1; r2=x |
r1=0, r2=0 |
| LB | r1=x; y=1 |
r2=y; x=1 |
r1=1, r2=1 |
- MP(message passing): 하트 0이 데이터 x를 쓰고 깃발 y를 세운다. 하트 1이 깃발을 보고(r1=1) 데이터를 읽었는데 옛 값(r2=0)이면 메시지 전달이 깨진 것이다. 스토어 둘의 순서가 바뀌거나 로드 둘의 순서가 바뀌면 생긴다.
- SB: 1절의 예. 스토어 뒤의 로드가 먼저 보이면 생긴다.
- LB(load buffering): 로드 뒤의 스토어가 먼저 보이면 생긴다. 서로가 상대의 "미래" 스토어 값을 읽은 것처럼 보인다.
세 모델이 이 결과들을 어떻게 다루는지가 이 편의 핵심이다. SC는 셋 다 금지, x86과 SPARC가 쓰는 TSO(total store order)는 SB만 허용, RVWMO는 셋 다 허용한다. 7절 실습에서 이를 직접 열거해 확인한다.
3. RVWMO의 규칙을 직관으로
RVWMO(RISC-V Weak Memory Ordering)의 정의는 이렇게 생겼다. 모든 하트의 메모리 접근을 한 줄로 세운 전역 메모리 순서(global memory order)가 존재해야 하고, 그 순서는 각 하트의 프로그램 순서 중 일부, 즉 보존 프로그램 순서(preserved program order, PPO)를 지켜야 한다. 그리고 세 공리를 만족해야 한다.
PPO 규칙 13개는 네 묶음으로 나뉜다. a가 b보다 프로그램 순서상 앞이고 둘 다 일반 메모리일 때, 다음 중 하나면 a는 전역 순서에서도 b보다 앞이어야 한다.
| 묶음 | 규칙 | 직관 |
|---|---|---|
| 같은 주소 (1~3) | b가 a와 겹치는 주소에 쓰는 스토어 등 | 같은 위치의 접근은 섞지 않는다 |
| 명시적 동기화 (4~8) | 사이에 fence, a에 aq, b에 rl, LR/SC 짝 |
소프트웨어가 요구한 순서 |
| 문법적 의존 (9~11) | b의 주소·데이터가 a의 결과에 의존, a에 제어 의존인 스토어 | 값이 이어지면 순서도 잇는다 |
| 파이프라인 의존 (12~13) | 중간 명령어를 거친 간접 의존 | 흔한 파이프라인이 자연히 지키는 것 |
여기에 없는 순서, 예를 들어 서로 다른 주소에 대한 스토어→로드, 로드→로드, 스토어→스토어, 로드→스토어는 모두 바뀌어 보여도 된다. 그래서 MP·SB·LB가 다 허용된다.
공리는 셋이다.
- 로드 값 공리(Load Value Axiom): 로드는 "전역 순서에서 자기보다 앞선 스토어"와 "프로그램 순서에서 자기보다 앞선 스토어" 중 전역 순서상 가장 늦은 것의 값을 돌려준다. 둘째 항이 저장 버퍼 전달을 허용하는 부분이다. 자기 스토어는 남에게 보이기 전에 자기가 먼저 볼 수 있다.
- 원자성 공리(Atomicity Axiom): 짝이 맞는 LR/SC 사이에 다른 하트의 스토어가 끼어들 수 없다. 8편의 "다른 하트 저장이면
sc실패" 규칙의 정확한 정의다. - 진행 공리(Progress Axiom): 어떤 접근도 무한히 미뤄질 수 없다. 스토어는 결국 남에게 보인다.
RVWMO는 TSO보다 약하지만, POWER처럼 스토어가 일부 하트에게만 먼저 보이는 일은 허용하지 않는다(자기 하트의 전달만 예외). 명세 부록은 이를 다중 복사 원자성(multi-copy atomicity, 정확히는 other-multi-copy atomicity)이라 부르고 RVWMO와 RVTSO 모두 이 성질을 가진다고 적는다. 덕분에 "한 줄로 세운 전역 순서"라는 그림이 성립한다.
4. FENCE: pred와 succ
fence pred, succ는 "울타리 앞의 pred 종류 접근이, 울타리 뒤의 succ 종류 접근보다 먼저 보인다"를 보장한다. 종류는 네 가지 비트로 고른다. R(메모리 읽기), W(메모리 쓰기), I(장치 입력), O(장치 출력)다. GNU as로 인코딩을 확인했다.
fence rw,rw  = 0x0330000f  pred 0011 succ 0011
fence r,rw   = 0x0230000f  pred 0010 succ 0011
fence rw,w   = 0x0310000f  pred 0011 succ 0001
fence.tso    = 0x8330000f  fm 1000, rw,rw
fence        = 0x0ff0000f  iorw,iorw
# [31:28] fm, [27:24] PI PO PR PW,
# [23:20] SI SO SR SW, opcode MISC-MEMfence만 쓰면 어셈블러가 iorw,iorw로 채운다. fm(fence mode) 필드는 지금 0000(보통)과 1000(TSO)만 정의되어 있다. 언제 무엇을 쓰는지 정리하면 이렇다.
| 울타리 | 막는 순서 | 쓰는 곳 |
|---|---|---|
fence rw,rw |
앞뒤 전부 | SB, C11 seq_cst 울타리 |
fence r,rw |
앞 읽기 → 뒤 전부 | 획득(acquire) 로드 뒤 |
fence rw,w |
앞 전부 → 뒤 쓰기 | 해제(release) 스토어 앞 |
fence w,w |
쓰기 → 쓰기 | MP 쓰는 쪽(Linux smp_wmb) |
fence r,r |
읽기 → 읽기 | MP 읽는 쪽(Linux smp_rmb) |
fence.tso |
읽기→전부, 쓰기→쓰기 | C11 acq_rel 울타리 |
fence iorw,iorw |
장치 포함 전부 | 드라이버(Linux mb()) |
fence.tso는 x86이 원래 지키는 순서를 한 명령어로 준다. 쓰기→읽기 순서만 빠져 있다. 그래서 fence.tso로는 SB를 막을 수 없다. 명세는 fence.tso를 fence rw,rw로 구현해도 맞다고 적는다(더 강하니까). 같은 원리로 간단한 구현은 pred·succ를 무시하고 언제나 모든 접근을 막는 울타리로 실행해도 된다.
명세는 앞날을 위해 두 가지를 정해 둔다. rs1·rd 칸은 예약되어 있어 하드웨어는 무시하고 소프트웨어는 0으로 둔다. 정의되지 않은 fm과 pred·succ 조합은 하드웨어가 fm=0000인 보통 울타리로 처리한다. pred나 succ가 비어 있는 fence는 HINT 공간이고, pause(Zihintpause)가 이 자리를 쓴다.
5. aq·rl과 FENCE의 관계
8편의 aq·rl 비트는 PPO 규칙 5~7이다. aq가 붙은 접근은 뒤의 모든 접근보다 먼저, rl이 붙은 접근은 앞의 모든 접근보다 나중에 보인다. 두 비트가 다 붙은 접근끼리는 서로 순서를 지킨다(RCsc). 울타리와 비교하면, 획득은 amoswap.w.aq 대신 lw 뒤에 fence r,rw를, 해제는 amoswap.w.rl 대신 fence rw,w 뒤에 sw를 써도 된다.
차이는 범위다. fence r,rw는 울타리 앞의 모든 로드를 뒤의 모든 접근보다 앞에 세운다. .aq는 그 명령어 하나만 앞에 세운다. 필요 없는 순서를 강제하지 않으니 하드웨어가 더 많은 접근을 겹쳐 실행할 수 있다.
한계도 있다. 지금 RISC-V에는 aq·rl이 붙은 일반 로드·스토어가 없다. aq·rl은 AMO와 LR/SC에만 있다. 그래서 C11의 atomic_load(acquire)처럼 일반 로드에 순서를 줘야 할 때는 울타리를 쓴다. 다음 절의 GCC 출력이 그 모습이다.
6. Ztso: x86처럼 강한 순서
Ztso는 명령어를 하나도 더하지 않는다. 대신 메모리 모델을 RVTSO로 바꾼다. 명세의 정의는 RVWMO에 세 줄을 더한 것이다.
- 모든 로드는 획득(acquire-RCpc)처럼 동작한다.
- 모든 스토어는 해제(release-RCpc)처럼 동작한다.
- 모든 AMO는 획득과 해제를 다 가진 것(RCsc)처럼 동작한다.
결과적으로 로드→전부, 스토어→스토어 순서가 저절로 지켜지고, 스토어→로드만 바뀔 수 있다. 저장 버퍼만 있고 나머지는 순서대로인 x86과 같다. 명세는 Ztso의 목적을 x86·SPARC 코드 이식과, 원래 TSO처럼 동작하는 구현이 그 사실을 소프트웨어에 알리는 것으로 설명한다.
방향이 중요하다. RVWMO용 코드는 Ztso 코어에서 그대로 돈다(울타리가 남지만 해롭지 않다). 반대로 Ztso를 가정하고 울타리를 뺀 바이너리는 RVWMO 코어에서 틀리게 돈다. 그래서 명세는 Ztso 전용 바이너리에 표시를 남겨, Ztso가 없는 플랫폼이 실행을 거부할 수 있게 하라고 한다.
7. 실습: 열거기, QEMU, GCC
(1) 허용 결과 열거. Python으로 작은 열거기를 만들었다. 하트마다 PPO가 요구하는 순서만 남기고 메모리 접근의 순서를 바꾼 모든 경우를 만들고, 하트 사이의 모든 끼워 넣기를 하나의 메모리에서 실행한다. 로드는 아직 실행 안 된 자기 하트의 앞선 스토어가 같은 주소에 있으면 그 값을 받는다(로드 값 공리의 전달). 모델 차이는 "지켜야 하는 순서" 함수 하나에 들어 있다.
def preserved(model, prog, i, j):   # i < j
    a, b = prog[i], prog[j]
    if model == 'SC': return True
    if a[1] == b[1] and (b[0] == 'st'
            or a[0] == b[0] == 'ld'):
        return True                 # 같은 주소
    if any(f[0] in ('fence', 'tso')
           and fence_orders(f, a, b)
           for f in prog[i + 1:j]):
        return True                 # 울타리
    if b[0] == 'st' and len(b) > 3 and b[3] == a[2]:
        return True                 # 데이터 의존
    if model == 'TSO':
        return not (a[0] == 'st' and b[0] == 'ld')
    return False                    # RVWMO
이 방식은 RVWMO 전체를 구현한 것이 아니다. 하트 둘, 같은 주소 섞임이 없는 이 시험들에서 명세 부록의 결론과 같은 답을 내도록 단순화한 것이다. 정확성 검사로 명세 부록 A.2의 예시 시험(하트 0: x에 1, 2를 쓰고 읽은 뒤 3을 씀, 하트 1: x에 4, 5를 씀)을 넣었다. 명세는 하트 0이 읽은 값이 2·4·5 중 하나이고 1·3은 불가능하다고 적는데, 열거기의 답도 정확히 {2, 4, 5}였다.
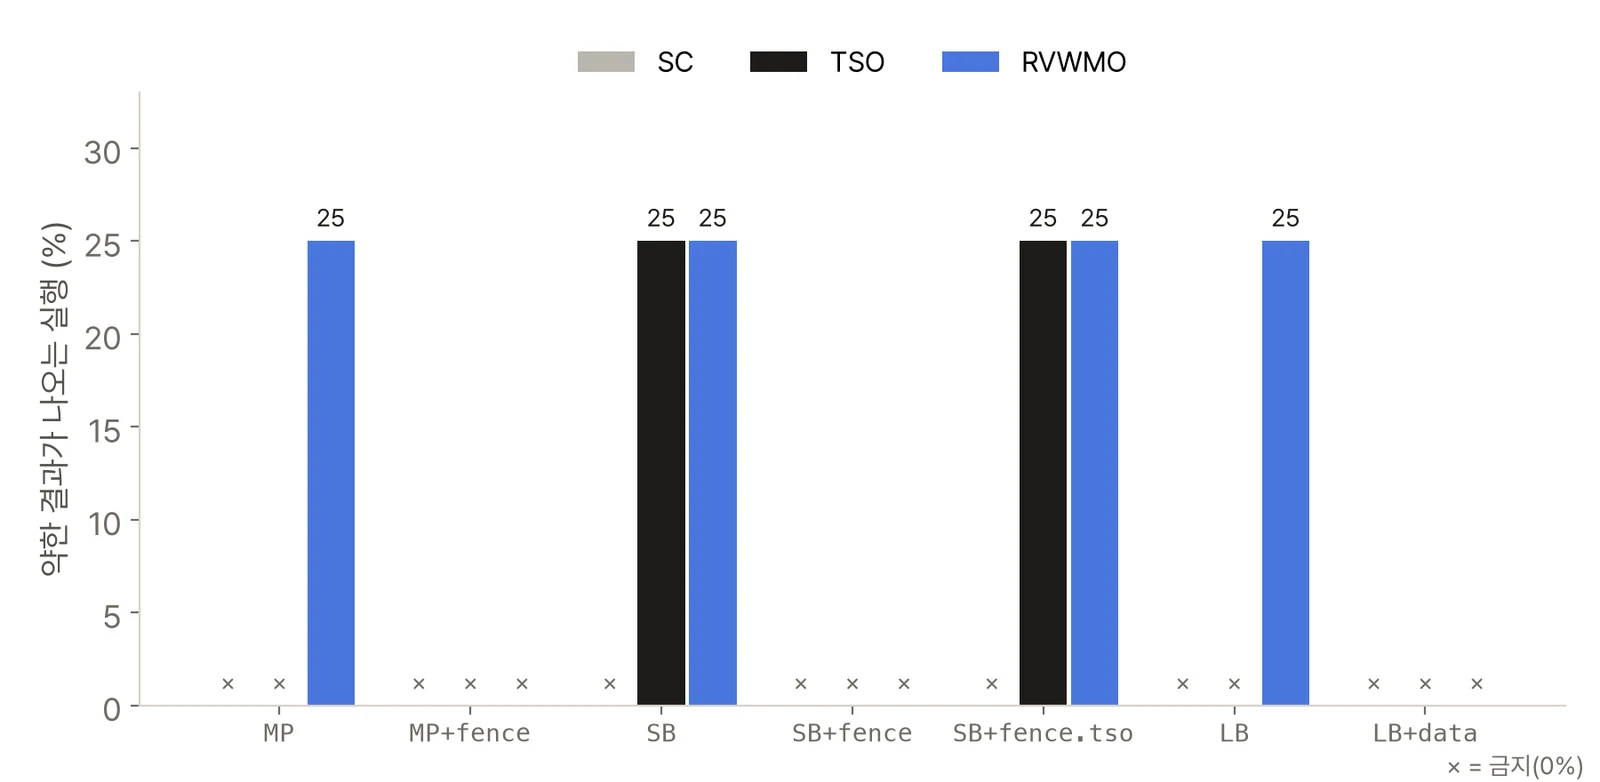
| 시험 | SC | TSO | RVWMO |
|---|---|---|---|
| MP | 금지 | 금지 | 허용 |
MP + fence w,w / fence r,r |
금지 | 금지 | 금지 |
| SB | 금지 | 허용 | 허용 |
SB + fence rw,rw |
금지 | 금지 | 금지 |
SB + fence.tso |
금지 | 허용 | 허용 |
| LB | 금지 | 금지 | 허용 |
| LB + 데이터 의존 | 금지 | 금지 | 금지 |
RVWMO에서 MP를 열거하면 하트마다 순서 2가지씩 4조합, 조합마다 끼워 넣기 6가지로 24개 실행이 나오고, 네 결과가 6개씩 고르게 나왔다. 울타리를 넣으면 SC와 같은 6개 실행, 결과 3가지로 줄었다. fence.tso가 SB를 막지 못한다는 4절의 설명이 표에서 그대로 확인된다. LB에 데이터 의존(r1=x; y=r1)을 넣으면 금지되는데, 이는 PPO 규칙 10이 "값이 이어지면 순서도 잇는다"를 요구하기 때문이다. 의존이 없다면 하드웨어가 로드 결과를 기다리지 않고 스토어를 먼저 내보낼 수 있다.
(2) QEMU에서 실제로 돌리기. 8편의 여러 하트 시작 코드를 복사해 하트 2개로 MP·SB·LB를 시험마다 100만 번 돌렸다. 매 회 x=y=0으로 되돌리고 amoadd.w 장벽으로 두 하트를 맞춘 뒤, 하트마다 고정 시드 난수로 0~511번 헛돌아 출발 시점을 흩뜨렸다(51초).
| 시험 | 100만 번 중 약한 결과 | 두 하트가 겹친 증거 |
|---|---|---|
| MP | 0 | |
| SB | 0 | (1,1) 23번 |
SB + fence rw,rw |
0 | (1,1) 15번 |
SB + fence.tso |
0 | (1,1) 30번 |
| LB | 0 |
약한 결과는 한 번도 나오지 않았다. 그렇다고 QEMU가 SC라는 뜻은 아니다. SB에서 (1,1)은 두 스토어가 모두 두 로드보다 먼저 보여야 나오는 결과라, 두 하트가 정말로 같은 순간에 시험 코드를 실행했다는 증거다. 그런 경우가 100만 번 중 23번뿐이었다. 대부분은 한 하트가 다 끝난 뒤 다른 하트가 실행해 (0,1)·(1,0)이 나왔다. 겹침이 이렇게 드물면 약한 결과가 안 나와도 결론을 내릴 수 없다. 실제 칩에서 약한 결과를 보려면 litmus7 같은 도구가 쓰는 정교한 동기화와 수많은 반복이 필요하다. 설계 검증에서 메모리 모델을 확인할 때 무작위 실행보다 열거기나 형식 모델(부록 B의 herd·Alloy 모델)을 쓰는 이유다.
(3) C11 원자 연산이 되는 명령어. memory_order별 함수를 -march=rv64gc와 rv64gc_ztso로 컴파일했다(주소 계산과 부호 확장은 생략).
| C11 연산 | RVWMO | Ztso |
|---|---|---|
| load relaxed | lw |
lw |
| load acquire | lw; fence r,rw |
lw |
| load seq_cst | fence rw,rw; lw; fence r,rw |
fence rw,rw; lw |
| store release | fence rw,w; sw |
sw |
| store seq_cst | fence rw,w; sw; fence rw,rw |
sw; fence rw,rw |
| fetch_add acquire | amoadd.w.aq |
amoadd.w |
| fetch_add seq_cst | amoadd.w.aqrl |
amoadd.w |
| CAS seq_cst | lr.w.aqrl … sc.w.rl |
같음 |
| fence acq_rel | fence.tso |
(없음) |
| fence seq_cst | fence rw,rw |
fence rw,rw |
대부분 명세 부록 A.5의 C/C++ 대응표와 같다. 하나 다른 곳이 있다. 대응표는 seq_cst 저장을 fence rw,w; sw로 적는데, GCC 16.2는 뒤에 fence rw,rw를 하나 더 붙였다. 명세는 같은 부록에서 "이 대응표의 seq_cst 저장 뒤에, 앞으로 생길 수 있는 aq 로드를 쓰는 seq_cst 로드가 오면 순서가 바뀔 수 있으니 저장 쪽에 울타리를 하나 더 붙이거나 amoswap.rl을 써야 한다"고 적는다. GCC가 그 강화된 대응을 고른 것으로 보인다(추정). Ztso에서는 획득·해제용 울타리가 모두 사라지고, AMO의 aq·rl 비트도 빠졌다. 남은 것은 SB를 막는 fence rw,rw뿐이다. TSO에서도 스토어→로드는 바뀔 수 있기 때문이다.
8. 설계 체크리스트: 메모리 모델
| 항목 | 규칙 |
|---|---|
| 기본 모델 | RVWMO. 다른 주소의 스토어→로드·로드→로드·스토어→스토어·로드→스토어는 바뀌어도 됨 |
| 저장 버퍼 전달 | 허용(로드 값 공리). 단 AMO·SC가 쓴 값을 뒤 로드에 미리 전달하면 안 됨(규칙 3) |
| 같은 주소 | 스토어는 앞선 같은 주소 접근 뒤에. 같은 주소 로드 둘이 서로 다른 스토어 값을 읽으면 순서 유지(규칙 2) |
| 의존 | 주소·데이터 의존, 제어 의존인 스토어는 순서 유지. 투기 실행으로 스토어를 먼저 내보내면 안 됨 |
fence 구현 |
가장 단순: 모든 앞 접근이 끝나고 저장 버퍼가 빌 때까지 뒤 접근을 멈춤. pred·succ 무시 가능 |
| pred에 W, succ에 R | 순서대로 실행하고 저장 버퍼가 FIFO인 코어에서는 이 경우만 버퍼를 비우면 된다 |
fence.tso |
fence rw,rw로 처리해도 맞다 |
| 예약 조합 | 정의 안 된 fm·pred·succ는 보통 울타리로. rs1·rd는 무시 |
| pred 또는 succ = 0 | HINT(pause 등). 울타리 동작 불필요 |
| I/O | I·O 비트로 장치 접근 순서를 따로 지정. PMA로 어떤 주소가 I/O인지 정함 |
| aq·rl | AMO·LR/SC에만. aq: 뒤 접근 시작을 미룸, rl: 앞 접근 완료를 기다림 |
| Ztso 구현 | 로드 순서와 스토어 순서를 지켜야 한다. 순서를 바꾸는 코어라면 위반 감지·재실행 필요 |
순서대로 실행하고 저장 버퍼가 FIFO인 간단한 코어는 사실상 TSO처럼 동작한다. 이런 코어는 대부분의 fence를 거의 공짜로 처리하고, fence w,r류에서만 저장 버퍼를 비우면 된다. 비순차 코어는 사정이 다르다. 로드를 투기적으로 먼저 실행해 놓고, 같은 주소 규칙이나 울타리를 어겼는지 나중에 확인해 다시 실행하는 장치가 필요하다. 이 장치들은 RISC-V만의 문제가 아니므로 이 시리즈에서는 A 확장 구현(20편)에서 aq·rl과 fence 처리를 다룰 때 필요한 만큼만 본다.
정리
- 메모리 모델은 로드가 돌려줄 수 있는 값을 정한다. 저장 버퍼 하나만으로도 SB의 r1 = r2 = 0처럼 순차 일관성에서 불가능한 결과가 나온다.
- RVWMO는 PPO 13개 규칙(같은 주소, 명시적 동기화, 문법적 의존, 파이프라인 의존)과 공리 3개로 정의된다. 열거해 보니 MP·SB·LB의 약한 결과가 모두 허용됐고, 울타리나 데이터 의존을 넣으면 금지됐다.
fence pred,succ는 R·W·I·O 조합으로 순서를 요구한다.fence.tso는 쓰기→읽기를 빼고 다 막으므로 SB는 못 막는다. aq·rl은 한 명령어에만 걸리는 더 좁은 순서다.- Ztso는 명령어 없이 모델만 TSO로 바꾼다. GCC는 Ztso에서 획득·해제 울타리를 모두 뺐고, RVWMO의
seq_cst저장에는 명세 표보다 울타리를 하나 더 붙였다. QEMU 100만 번 실행에서는 약한 결과가 나오지 않았다.
다음 글: 10편에서는 부동소수점 확장 F·D로 넘어간다. 32개의 FP 레지스터와 fcsr, 다섯 가지 반올림 모드와 예외 플래그, 64비트 레지스터에 32비트 값을 넣을 때 쓰는 NaN boxing, 정수 변환에서 범위를 넘을 때의 규칙을 QEMU로 확인한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 2.7 메모리 순서 명령어(FENCE, fm, FENCE.TSO), 2.9 HINT, 17장 RVWMO 메모리 일관성 모델 v2.0(17.1.3 보존 프로그램 순서, 17.1.4 공리), 18장 "Ztso" v1.0, 부록 A RVWMO 설명 자료(A.2 리트머스 시험, A.5 코드 이식과 대응표), 부록 B 형식 메모리 모델. https://github.com/riscv/riscv-isa-manual
- RISC-V 리트머스 시험 모음. https://github.com/litmus-tests/litmus-tests-riscv
- D. Sorin, M. Hill, D. Wood, A Primer on Memory Consistency and Cache Coherence, 2판, 2020. 3장 SC, 4장 TSO, 5장 완화된 모델
- C. Trippel 외, "TriCheck: Memory Model Verification at the Trisection of Software, Hardware, and ISA," ASPLOS 2017 (RISC-V 메모리 모델 개정의 계기)
- GCC RISC-V 원자 연산 대응(
-march=…_ztso). https://gcc.gnu.org/onlinedocs/gcc/RISC-V-Options.html