이 글의 핵심 3줄
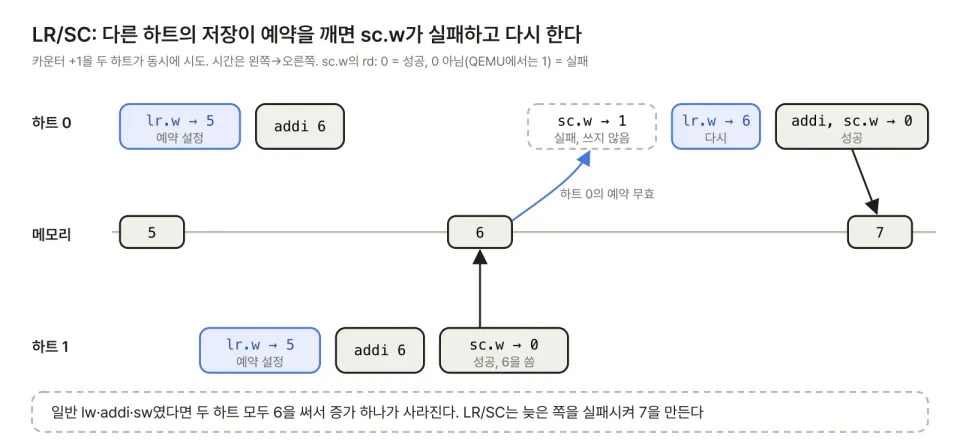
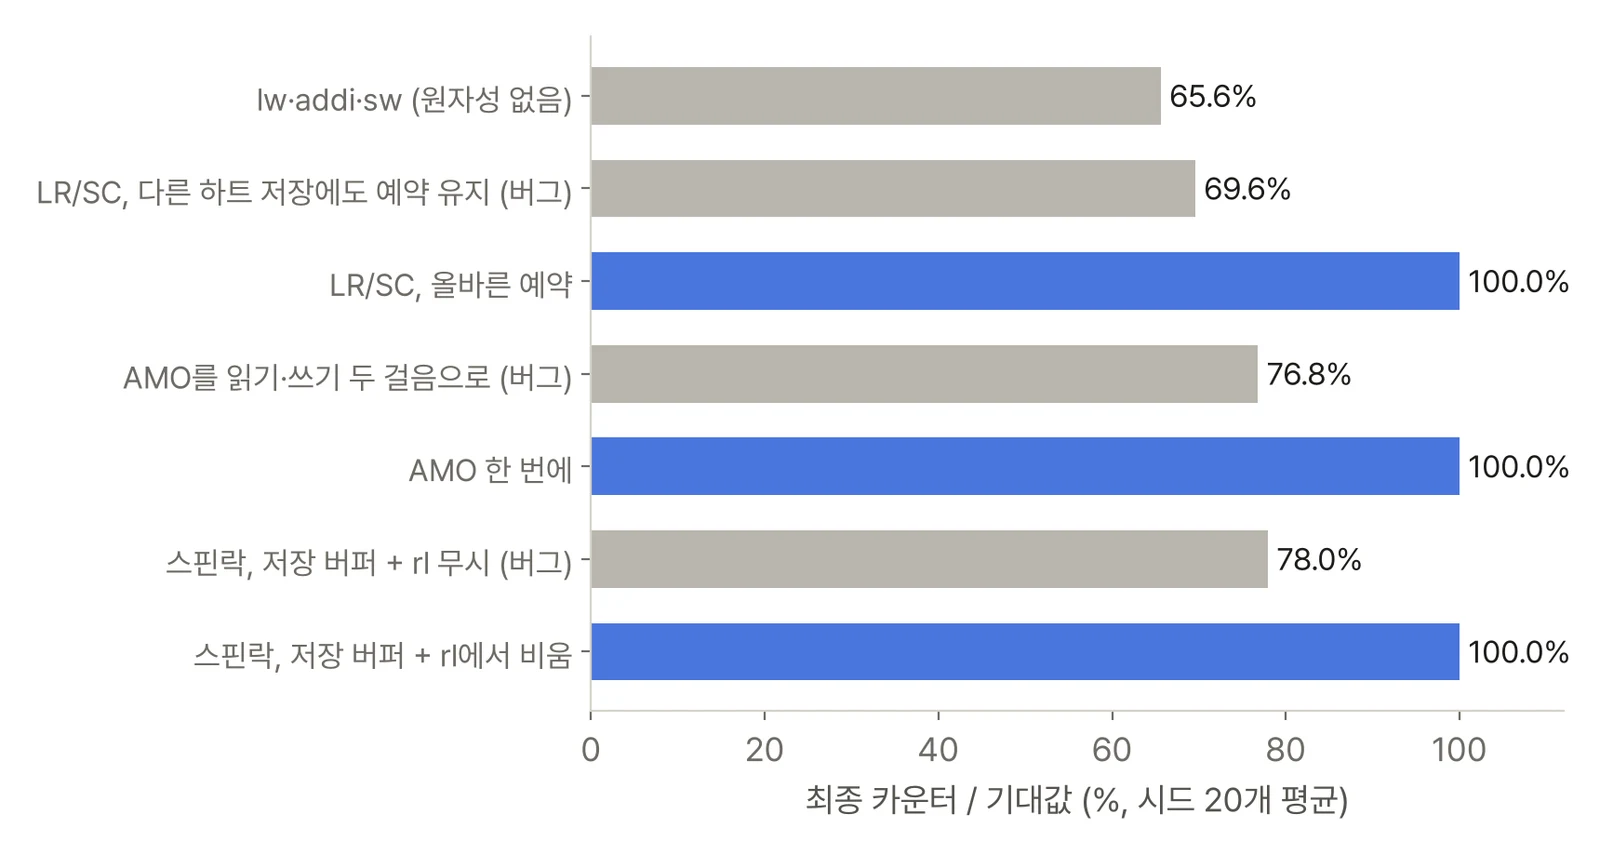
- LR/SC는 하트마다 예약 레지스터 하나(유효 비트 + 주소)로 만든다. 핵심은 "다른 하트의 저장이 예약 집합에 닿으면 지운다"는 규칙 하나다. 이 규칙을 빼면 두 하트가 2,000번씩 올린 카운터가 4,000이 아니라 평균 2,782가 됐다.
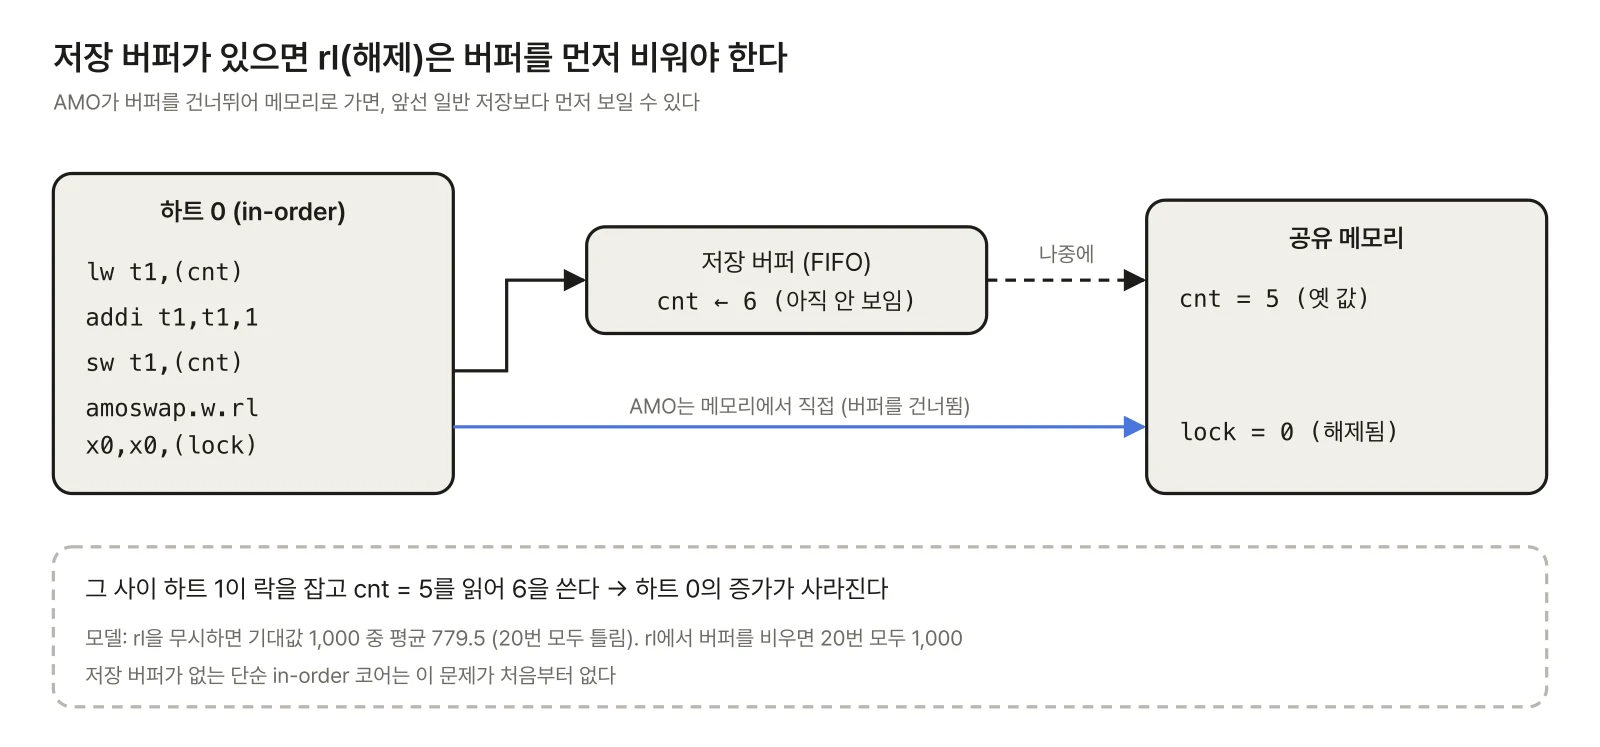
- AMO는 읽기·수정·쓰기를 다른 하트가 끼어들 수 없게 한 덩어리로 해야 한다. 두 걸음으로 나누면 평균 76.8%만 남았다. 저장 버퍼가 없는 in-order 코어에서는 aq·rl·FENCE가 거의 저절로 지켜지고, 저장 버퍼가 있으면 rl과 FENCE에서 버퍼를 비워야 한다(안 비우면 스핀락으로 1,000번 올린 카운터가 평균 779.5).
- QEMU
-smp 2에서 카운터 40만 번 증가는 LR/SC·AMO 모두 정확했지만, LR과 SC 사이에 다른 하트가 값을 바꿨다 되돌리는 ABA 시험에서 SC가 20번 모두 성공했다. 명세는 실패를 요구한다. QEMU TCG는 예약 대신 값 비교로 SC를 흉내 내기 때문이다.
19편에서 RV32I 5단 파이프라인 코어에 M 확장을 붙였다. 이번에는 A 확장(원자적 명령어)이다. 명령어의 뜻은 8편에서 봤으니, 여기서는 구현 쪽 질문에 답한다. 예약 집합(reservation set)을 얼마나 크게 잡고 언제 지우는가, SC는 언제 반드시 실패해야 하는가, AMO의 읽기-수정-쓰기를 어디서 하는가, aq·rl과 FENCE는 무엇을 하면 지켜지는가. 확인 도구는 두 하트가 메모리를 나눠 쓰는 작은 Python 모델과 QEMU의 2하트 실행이다.
1. A 확장이 하드웨어에 요구하는 것
A 확장은 두 부분 확장의 합이다(비특권 명세 14장). Zalrsc는 lr.w·sc.w, Zaamo는 AMO 9개(amoswap amoadd amoand amoor amoxor amomax amomaxu amomin amominu)다. 모두 opcode AMO(0101111), funct3 010(워드)이고 funct5가 종류를, inst[26]이 aq, inst[25]가 rl을 나타낸다.
| 명령어 | 하는 일 | rd에 쓰는 값 |
|---|---|---|
lr.w rd, (rs1) |
읽고 예약 등록 | 읽은 값 |
sc.w rd, rs2, (rs1) |
예약이 유효하면 쓰기 | 성공 0, 실패 0 아닌 값 |
amoXX.w rd, rs2, (rs1) |
읽고, 연산하고, 쓰기를 원자적으로 | 원래 메모리 값 |
SC의 실패 코드는 지금 1만 정의되어 있다. 명세는 이 값을 고른 이유로 slt·sltu가 이미 쓰는 0/1 선택기를 재사용할 수 있다는 점을 든다. 주소는 반드시 4바이트 정렬이어야 하고, 아니면 주소 정렬 예외나 접근 폴트를 낸다(정렬 안 된 LR/SC를 흉내 내는 것은 사실상 불가능하다).
코어 입장에서 새로 생기는 것은 세 가지다. 예약 레지스터, 메모리 단계에서 읽기와 쓰기를 연달아 하는 경로(AMO), 그리고 순서 비트(aq·rl)를 지키는 장치다.
2. 예약 집합: 무엇을 기억하고 언제 지우나
LR은 읽은 주소를 포함하는 바이트 집합, 즉 예약 집합을 등록한다. 명세는 크기를 구현에 맡긴다. 읽은 워드를 포함하기만 하면 얼마든지 커도 된다. 흔한 선택은 워드(4바이트) 또는 캐시 줄(64바이트 등)이다(추정). 하트 하나는 예약을 하나만 갖는다. 새 LR은 이전 예약을 덮어쓰고, SC는 성공하든 실패하든 자기 예약을 지운다.
SC가 성공해도 되는지는 명세 14.2절이 "반드시 실패"와 "실패해도 됨"으로 나눠 정한다.
| 조건 | SC 결과 |
|---|---|
| 주소가 가장 최근 LR의 예약 집합 밖 | 반드시 실패 |
| LR 이후 다른 하트가 예약 집합에 저장 | 반드시 실패 |
| LR 이후 다른 장치(DMA 등)가 LR의 바이트에 쓰기 | 반드시 실패 |
| LR과 SC 사이에 다른 SC가 있음 | 반드시 실패 |
| 다른 장치가 예약 집합 중 LR 바이트가 아닌 곳에 쓰기 | 실패해도, 성공해도 됨 |
| 그 밖의 이유(구현 사정) | 가끔 실패해도 됨, 단 3절의 전진 보장을 지킬 것 |
둘째 줄이 핵심이다. 조건은 "값이 바뀌었는가"가 아니라 "다른 하트가 저장했는가"다. 그래서 LR/SC는 CAS(compare-and-swap)가 겪는 ABA 문제(값이 A→B→A로 돌아오면 바뀐 줄 모름)를 피한다. 명세가 CAS 대신 LR/SC를 고른 첫 번째 이유도 이것이다.
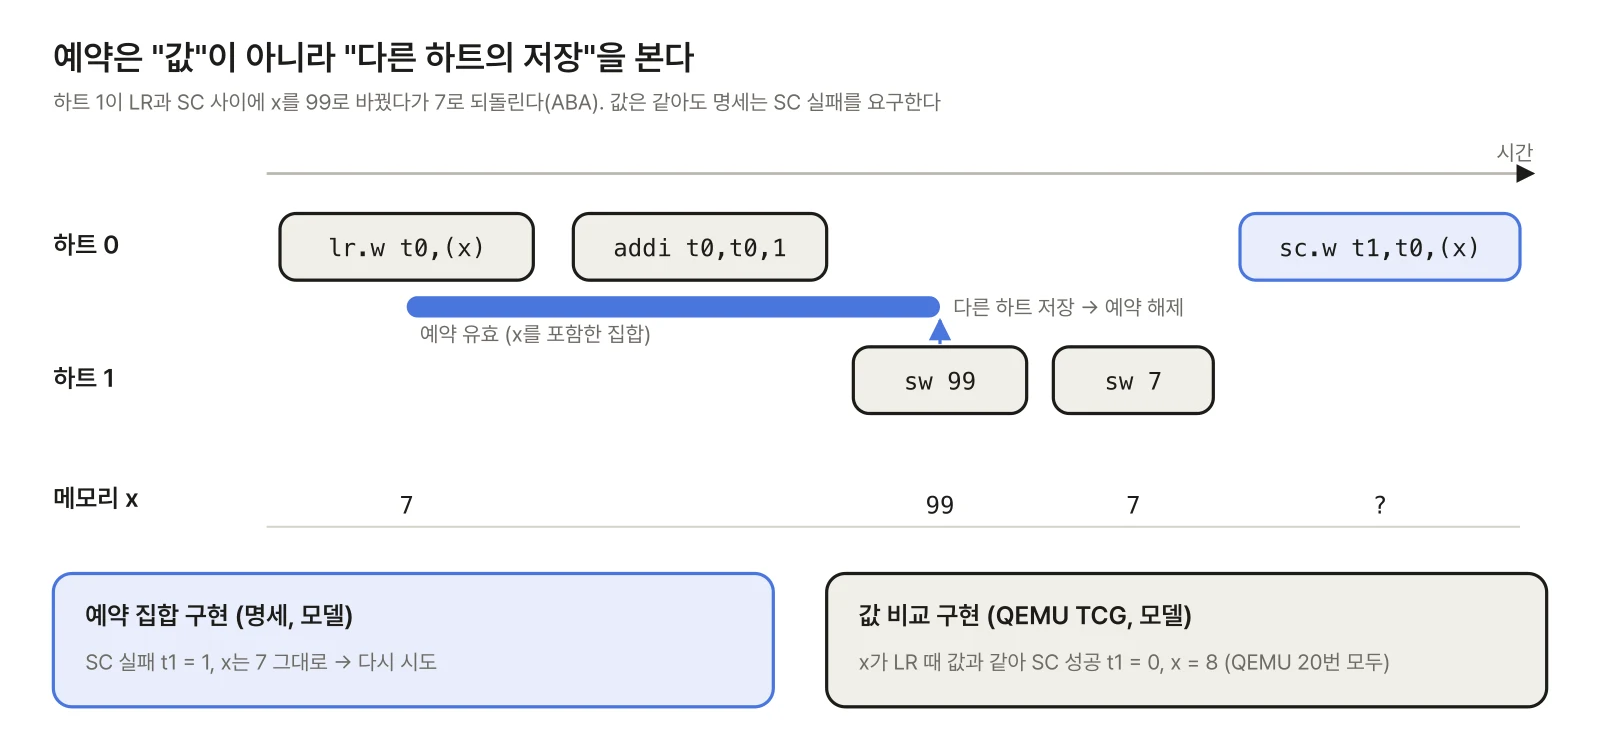
손으로 따라가 보자. x = 7에서 하트 0이 lr.w로 7을 읽고 예약을 건다. 하트 1이 x에 99를 썼다가 7을 쓴다. 첫 저장이 하트 0의 예약을 지운다. 하트 0의 sc.w는 예약이 없으니 실패하고 x는 7 그대로다. 하트 0은 다시 LR부터 시작한다. 모델의 예약 구현은 정확히 이렇게 동작했다(rd = 1, x = 7). 반면 SC 때 "메모리 값이 LR 때 값과 같은가"만 보는 구현은 성공해 x = 8을 쓴다.
가장 단순한 구현
단일 하트 in-order 코어라면 예약은 레지스터 두 개로 끝난다.
LR:  resv_valid <= 1; resv_addr <= addr[31:2]
SC:  ok = resv_valid && resv_addr == addr[31:2]
     if ok: 메모리에 쓰기
     rd <= ok ? 0 : 1;  resv_valid <= 0
다른 하트가 없으니 "다른 하트의 저장"은 생기지 않는다. 남는 것은 DMA 같은 버스 마스터다. 이들이 LR이 읽은 바이트에 쓰면 예약을 지워야 하므로, 버스의 쓰기 주소를 엿보는(snoop) 비교기를 둔다. 다하트 시스템에서는 캐시 일관성 메시지가 이 역할을 한다. 다른 코어가 그 캐시 줄을 독점(쓰기) 상태로 가져가면 예약을 지우는 식이다. 이렇게 하면 예약 크기가 자연스럽게 캐시 줄이 된다.
예약이 크면 거짓 공유(false sharing)가 생긴다. 서로 다른 카운터 두 개(주소 0x1000, 0x1004)를 두 하트가 각자 LR/SC로 2,000번씩 올리게 했다. 결과는 언제나 맞았지만 SC 실패율이 달랐다.
| 예약 크기 | 정확한 실행 (20번 중) | 성공 1번당 SC 실패 |
|---|---|---|
| 4바이트 | 20 | 0.0 |
| 64바이트 | 20 | 0.444 |
예약 크기는 정확성이 아니라 성능 문제다. 명세도 "플랫폼이 예약 집합의 크기와 모양을 알 수 있는 방법을 제공해야 한다"고만 한다.
명세가 하드웨어에 요구하지 않는 것도 있다. 문맥 전환(context switch) 때 이전 스레드의 예약이 남아 있으면 새 스레드의 SC가 잘못 성공할 수 있다. 명세는 이때 소프트웨어가 아무 주소에나 SC를 한 번 실행해 예약을 지우라고 한다. 하드웨어가 트랩이나 mret에서 예약을 지워도 된다(흔한 선택이지만 필수는 아니다).
3. SC 실패 조건과 전진 보장
SC가 "가끔 실패해도 된다"면, 두 하트가 서로의 예약을 끝없이 지워 아무도 성공하지 못하는 라이브락(livelock)이 생길 수 있다. 명세 14.3절은 제약 LR/SC 루프(constrained LR/SC loop)를 정의하고, 이 루프에 들어간 하트에는 결국 무언가(누군가의 SC 성공, 다른 하트의 저장, 루프 탈출, 트랩)가 일어나야 한다고 요구한다.
| 제약 루프 조건 | 이유 |
|---|---|
| LR부터 재시도 분기까지 16개 이하, 연속 배치 | 64바이트 안: 명령어 캐시·TLB 연관도 제약을 줄임 |
| LR과 SC 사이에는 기본 I 명령어만 | 곱셈·나눗셈·FP는 OS 에뮬레이션을 피하려고 금지 |
| 로드·스토어, 뒤로 가는 분기·점프, JALR, FENCE, SYSTEM 금지 | 다른 접근이 예약 줄을 쫓아내지 않게, 시간 제한 |
| SC는 마지막 LR과 같은 주소·같은 크기 |
이 조건 밖의 LR/SC 순서는 "제약 없음"이고, 구현은 그런 순서를 무조건 실패시켜도 된다. 하드웨어 쪽에서 지킬 것은 하나다. 로드와 LR은 다른 하트의 예약을 지우지 않는다. 명세는 다른 하트의 로드나 LR, 공유 캐시에서의 쫓겨남(eviction)이 LR/SC의 전진을 무한정 막으면 안 된다고 적었다.
이것을 어기면 어떻게 되는지 모델로 확인했다. "다른 하트의 LR이 내 예약을 지운다"는 잘못된 구현에서, LR과 SC 사이에 addi 4개가 있는 제약 루프(9개 명령어)를 두 하트가 한 명령어씩 번갈아 실행했다. 하트 1 앞에 nop을 0~9개 넣어 출발 위상을 10가지로 바꿨다.
| 구현 | 2만 단계 동안 SC 성공 (위상 10가지) |
|---|---|
| 저장만 예약을 지움 (명세대로) | 위상마다 1,250번 |
| 다른 하트의 LR도 예약을 지움 | 위상마다 0~2번, 3가지 위상은 0번 |
서로의 LR이 상대 예약을 지우는 위상에 걸리면, 두 하트가 LR → (상대 LR이 내 예약 삭제) → SC 실패 → 재시도를 끝없이 반복한다. 캐시 기반 구현에서 "LR이 줄을 독점 상태로 가져오고 다른 코어의 줄을 무효화"하면 바로 이 모양이 된다(추정).
4. AMO를 어디서 실행하나
AMO는 메모리 값을 읽고, rs2와 연산하고, 결과를 같은 주소에 쓴다. 이 셋 사이에 다른 하트의 저장이 끼어들면 안 된다. 두 가지 자리가 있다.
코어 안에서(ALU 근처). 5단 파이프라인에서 AMO는 MEM 단계를 두 번 쓴다. 첫 사이클에 읽고, 작은 AMO ALU(덧셈, AND·OR·XOR, 부호 있는/없는 최대·최소, swap)로 계산하고, 다음 사이클에 쓴다. 읽은 원래 값은 rd로 간다. 원자성은 그 사이에 다른 마스터가 그 주소에 쓰지 못하게 해서 얻는다. 단일 버스면 버스를 쥐고 놓지 않으면(lock) 되고, 캐시가 있으면 줄을 독점 상태로 잡은 채 읽기와 쓰기를 끝낸다. 명세는 단순한 구현이 내부적으로 LR/SC를 써서 AMO를 만들어도 된다고 한다. 결국 끝나기만 보장하면 된다.
메모리나 버스 쪽에서. 코어는 "이 주소에 이 값을 더하라"는 요청만 보내고, 메모리 컨트롤러나 공유 캐시가 읽기-수정-쓰기를 한다. AXI5의 원자 트랜잭션(AtomicStore·AtomicLoad·AtomicSwap·AtomicCompare)이나 TileLink의 Arithmetic·Logical 메시지가 이런 용도다. 많은 코어가 같은 카운터를 두드릴 때 줄이 코어 사이를 오가지 않아 유리하고, rd가 x0이면 원래 값을 돌려받을 필요도 없다(명세가 이 최적화를 언급한다). 버스·캐시 설계는 이 시리즈 범위 밖이라 여기까지만 적는다.
어느 쪽이든 핵심은 "한 덩어리"다. 모델에서 AMO를 읽기 한 걸음, 쓰기 한 걸음으로 나눠 그 사이에 다른 하트가 끼어들 수 있게 하자, 4,000이어야 할 카운터가 평균 3,072(76.8%)가 됐다.
5. aq·rl과 FENCE를 in-order 코어에서 지키기
aq(acquire)는 "이 원자적 명령어 뒤의 메모리 접근이 이것보다 먼저 보이면 안 된다", rl(release)은 "이것이 앞선 메모리 접근보다 먼저 보이면 안 된다"는 뜻이다(14.1절). 둘 다 켜면 순차 일관(sequentially consistent)이다. FENCE는 pred·succ 비트로 "앞의 어떤 접근(R/W/I/O)이 뒤의 어떤 접근보다 먼저 보여야 하는지"를 지정한다.
질문은 "내 코어가 접근 순서를 바꿀 수 있는가"다.
- 저장 버퍼도, 비차단 로드도 없는 in-order 코어: 모든 메모리 접근이 프로그램 순서대로 하나씩 끝난다. 뒤 접근은 앞 접근이 끝난 뒤에야 시작하므로 aq·rl·FENCE가 요구하는 순서가 처음부터 지켜진다. FENCE는 NOP으로 처리해도 된다.
- 저장 버퍼가 있는 코어: 저장을 버퍼에 넣고 바로 다음 명령어로 넘어가면, 뒤 로드가 앞 저장보다 먼저 메모리에 닿는다(저장→로드 순서 뒤바뀜). 이 경우 FENCE(pred에 W, succ에 R)는 버퍼를 비울 때까지 기다려야 한다.
두 하트가 각자 자기 변수에 1을 쓰고 상대 변수를 읽는 SB(store buffering) 리트머스로 확인했다. 둘 다 0을 읽으면 순서가 뒤바뀐 것이다. 무작위 스케줄 2만 번씩이다.
| 구성 | 둘 다 0을 읽은 횟수 |
|---|---|
| 저장 버퍼 없음, FENCE 없음 | 0 |
| 저장 버퍼 있음, FENCE 없음 | 3,705 |
| 저장 버퍼 있음, FENCE를 NOP으로 | 1,768 |
| 저장 버퍼 있음, FENCE에서 버퍼 비움 | 0 |
그래서 "FENCE를 NOP으로 처리해도 되는 조건"은 코어가 메모리 접근 순서를 바꾸는 구조(저장 버퍼, 비차단 캐시, 쓰기 응답을 기다리지 않는 버스 등)를 하나도 갖지 않을 때다. I/O 쪽도 같다. 버스가 장치 쓰기를 응답 전에 끝난 것으로 치는(posted write) 구조라면, I/O를 순서 짓는 FENCE는 응답을 기다려야 한다.
aq·rl도 같은 논리다. in-order 코어에서 AMO는 끝날 때까지 뒤 명령어를 막으므로 aq는 저절로 지켜진다. rl은 앞선 저장이 모두 보인 뒤에 AMO가 보여야 하므로, 저장 버퍼가 있으면 AMO 전에 버퍼를 비워야 한다. 모델의 스핀락(amoswap.w.aq로 잠그고, 카운터를 lw·addi·sw로 올리고, amoswap.w.rl로 풀기)이 이것을 보여 준다.
| 스핀락 구성 (기대값 1,000) | 평균 | 정확한 실행 (20번 중) |
|---|---|---|
| 저장 버퍼 없음 | 1,000 | 20 |
| 저장 버퍼 + rl에서 비움 | 1,000 | 20 |
| 저장 버퍼 + rl 무시 | 779.5 | 0 |
명세의 권장도 하나 더 기억해 둘 만하다. LR에 rl만, SC에 aq만 켜는 것은 둘 다 끈 것보다 강한 순서를 보장하지 않는다. 구현은 aq·rl 비트를 그대로 읽어 "rl이면 앞을 비우고, aq면 끝날 때까지 뒤를 막는다"로만 처리하면 된다.
6. 실습: 두 하트 모델과 QEMU -smp 2
모델(atomics.py)은 하트마다 RV 비슷한 작은 명령어 목록을 한 명령어씩 실행하고, 스케줄러가 시드 고정 무작위로 어느 하트를 진행할지 고른다. 구현 선택지는 생성자 인자 하나씩이다.
class Impl:
    def __init__(self, granule=4,
                 clear_on_store=True,  # 다른 하트 저장 → 예약 해제
                 clear_on_lr=False,    # 버그: 다른 하트 LR도 해제
                 sc='resv',            # 'value': 값 비교
                 amo_atomic=True,      # False면 읽기·쓰기 두 걸음
                 sbuf=False,           # 저장 버퍼
                 drain_on_rl=True,     # rl에서 버퍼 비움
                 fence_drains=True):   # FENCE에서 버퍼 비움
카운터 시험은 두 하트가 같은 주소를 2,000번씩 올리고, 시드 20개로 반복했다.
| 구현 | 최종값 평균 (기대 4,000) | 정확 (20번 중) |
|---|---|---|
lw·addi·sw |
2,623 | 0 |
| LR/SC, 올바른 예약 | 4,000 | 20 |
| LR/SC, 다른 하트 저장에도 예약 유지 | 2,782 | 0 |
| AMO 한 번에 | 4,000 | 20 |
| AMO 두 걸음 | 3,072 | 0 |
QEMU 쪽은 시작 코드를 복사해 하트마다 스택을 따로 잡고(start_smp.S), -smp 2 -accel tcg,thread=multi로 두 하트를 호스트 스레드 두 개에서 동시에 돌렸다. 하트마다 20만 번씩 세 방식으로 카운터를 올리고, 이어서 2절의 ABA 시험을 했다. 20번 실행한 결과다.
| 시험 (하트당 20만 번) | QEMU 결과 (20번) |
|---|---|
lw·addi·sw |
200,264~201,649 (기대 400,000) |
lr.w/sc.w 루프 |
언제나 400,000 |
amoadd.w |
언제나 400,000 |
| ABA 시험의 SC 결과 코드 | 언제나 0 (성공) |
카운터는 모델과 같은 결론이다. ABA 시험은 다르다. 하트 0은 lr.w 뒤 하트 1이 x에 99와 7을 쓰고 깃발을 세울 때까지 기다린 다음 sc.w를 실행했다. 다른 하트의 저장이 LR과 SC 사이에 관찰됐으니 명세상 SC는 반드시 실패해야 한다. QEMU는 20번 모두 성공시켰다. QEMU 소스(trans_rva.c.inc의 gen_sc)를 보면 LR 때 읽은 주소와 값을 기억해 두고, SC를 "주소가 같고 값이 아직 그대로면 쓰기"라는 호스트의 compare-and-swap(tcg_gen_atomic_cmpxchg_tl)으로 실행한다. 모델의 sc='value' 구현이 같은 결과(rd = 0, x = 8)를 냈다. 카운터처럼 값이 한 방향으로만 변하는 코드에서는 차이가 드러나지 않지만, 하드웨어 검증 기준으로 QEMU를 쓸 때 LR/SC 쪽은 이 점을 감안해야 한다.
QEMU의 SC 실패는 하트당 평균 177,229번(성공 20만 번 대비)이었다. 호스트 스레드 스케줄에 따른 값이라 하드웨어 성능과는 관계가 없다. 장비는 맥 M1 Max, QEMU 11.1.3, riscv64-elf-gcc 16.2(-march=rv32ima_zicsr)다.
7. 설계 체크리스트: A 확장
| 항목 | 규칙 |
|---|---|
| 예약 레지스터 | 하트당 1개. LR이 덮어쓰고, SC는 성공·실패 모두 지움 |
| 예약 크기 | 읽은 워드 이상이면 자유. 흔히 워드 또는 캐시 줄 |
| 예약 해제 | 다른 하트의 저장·AMO·성공한 SC가 집합에 닿을 때(필수) |
| 해제하면 안 되는 것 | 다른 하트의 로드·LR, 공유 캐시 쫓겨남이 전진을 막으면 안 됨 |
| 장치 쓰기 | LR이 읽은 바이트에 쓰면 해제(필수). 나머지 집합은 선택 |
| SC 실패 코드 | 1 (다른 값은 예약) |
| 정렬 | 4바이트 정렬 아니면 주소 정렬 예외 또는 접근 폴트 |
| 실패한 SC | 메모리 보호 목적상 저장처럼 다뤄도 됨(권한 검사) |
| AMO 원자성 | 읽기-연산-쓰기 사이 다른 마스터 쓰기 차단(버스 잠금, 줄 독점, 메모리 쪽 실행) |
| AMO의 rd | 원래 메모리 값. rd = x0이면 읽기 응답 생략 가능 |
| aq | in-order 차단형이면 저절로. 아니면 AMO가 끝날 때까지 뒤 접근 대기 |
| rl | 저장 버퍼가 있으면 비운 뒤 실행 |
| FENCE | 순서를 바꾸는 구조가 하나도 없으면 NOP. 아니면 pred 쪽 완료 대기 |
| FENCE 필드 | pred·succ를 무시하고 언제나 전부 순서 짓는 것도 허용. 예약된 fm은 일반 FENCE로, FENCE.TSO는 FENCE RW,RW로 처리해도 됨(2.7절) |
| 문맥 전환 | 예약 정리는 소프트웨어 SC 책임. 트랩에서 지우는 것은 선택 |
정리
- 예약은 하트당 레지스터 하나다. "다른 하트의 저장이 집합에 닿으면 지운다"는 규칙을 빼면 카운터가 기대값의 69.6%가 됐다. 예약을 64바이트로 키우면 정확성은 그대로지만 거짓 공유로 SC 실패가 성공 1번당 0.444번 생겼다.
- 로드나 LR이 다른 하트의 예약을 지우면 제약 LR/SC 루프가 라이브락에 빠질 수 있다. 모델에서 위상 10가지 중 3가지가 2만 단계 동안 한 번도 성공하지 못했다.
- AMO는 읽기-수정-쓰기를 한 덩어리로 해야 한다(나누면 76.8%). 코어 MEM 단계 두 번 + 버스 잠금, 또는 메모리·버스 쪽 실행 중에 고른다.
- 저장 버퍼가 없는 in-order 코어는 aq·rl·FENCE가 저절로 지켜지고 FENCE는 NOP이면 된다. 저장 버퍼가 있으면 rl과 FENCE에서 비워야 한다. QEMU TCG의 SC는 값 비교라 ABA 시험에서 명세와 달리 성공한다.
다음 글: 21편에서는 C 확장을 구현한다. 16비트 압축 명령어를 디코더 앞에서 32비트로 펼치는 압축 해제기, 32비트 페치 워드 안에 16비트와 32비트 명령어가 섞여 들어올 때 다음 명령어를 꺼내는 페치 버퍼, 두 워드에 걸치는 32비트 명령어와 2바이트 정렬 분기 목적지를 Python 모델로 만들고, 실제 rv32imc 프로그램을 GNU objdump와 대조한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 14장 "A" 확장(14.1 순서 지정, 14.2 Zalrsc, 14.3 SC의 결국 성공, 14.4 Zaamo), 17장 RVWMO 메모리 모델, 2.7절 FENCE. https://github.com/riscv/riscv-isa-manual
- D. Harris 외, RISC-V System-on-Chip Design, 2023. 원자적 명령어와 캐시 구현(CORE-V Wally)
- D. Patterson, A. Waterman, The RISC-V Reader, 2017. 6장 RV32A
- K. Gharachorloo 외, "Memory Consistency and Event Ordering in Scalable Shared-Memory Multiprocessors", ISCA 1990
- QEMU 소스
target/riscv/tcg/insn_trans/trans_rva.c.inc의gen_sc(2026-11 master에서 확인). https://github.com/qemu/qemu