이 글의 핵심 3줄
- RISC-V는 저장한 값이 같은 하트의 명령어 페치에 보이는 것을 FENCE.I 전에는 보장하지 않는다. 쓴 코드가 안 보이는 자리는 셋이다. 쓰기 지연 데이터 캐시, 명령어 캐시, 그리고 이미 가져온 명령어(파이프라인 앞단과 미리 가져오기 버퍼).
- 같은 자기 수정 코드 ELF를 Python 명령어 모델의 16가지 조합(코어 구성 4 × FENCE.I 구현 4)에서 돌렸다. FENCE.I를 NOP으로 둬도 되는 것은 캐시도 미리 가져오기도 없는 코어뿐이었고, 캐시가 없어도 미리 가져오기가 있으면 플러시가, I가 있으면 내리기까지 필요했다.
- QEMU 11.1.3은 fence.i 없이도 다른 곳에 쓴 코드는 새 것(2)을 실행했지만, 바로 다음 명령어를 고친 경우는 옛 것(11)을 실행했다. TCG가 변환한 페이지에 쓰기를 감지하되, 지금 실행 중인 변환 블록은 끝까지 옛 번역으로 돌기 때문이다. 블록을 명령어 하나로 줄이자 둘 다 새 코드가 됐다.
19~21편에서 RV32I 5단 파이프라인 코어에 M·A·C를 붙였다. 2부의 마지막인 이번 편은 명령어 쪽의 남은 규칙 하나, FENCE.I다. 20편의 FENCE가 하트 사이에서 데이터 접근의 순서를 정했다면, FENCE.I는 한 하트 안에서 "데이터로 쓴 것"과 "명령어로 읽는 것"을 맞춘다. JIT 컴파일러, 부트로더가 코드를 RAM에 복사한 뒤 뛰어드는 경우, 디버거의 소프트웨어 중단점이 모두 이 규칙에 기댄다.
1. 쓴 코드가 왜 안 보이나
폰 노이만 구조에서 명령어와 데이터는 같은 메모리에 있다. 그런데 파이프라인 코어는 명령어와 데이터를 서로 다른 길로 읽는다. IF 단계는 명령어 캐시(I)나 데이터 버스로 간다. 둘을 나눠야 한 사이클에 명령어 하나와 데이터 하나를 동시에 읽을 수 있기 때문이다. 이렇게 나뉜 길 사이에는 기본적으로 아무 연결이 없다.
sw로 새 명령어를 썼을 때 명령어 쪽이 옛 비트를 들고 있을 수 있는 자리는 셋이다.
| 자리 | 옛 비트가 남는 이유 |
|---|---|
| ① 쓰기 지연(write-back) D$ | 새 코드가 D는 메모리에서 채운다 |
| ② I$ | 예전에 그 주소를 실행해 줄이 남아 있다 |
| ③ 이미 가져온 명령어 | 5단 파이프라인의 IF·ID에 있는 명령어, 미리 가져오기(prefetch) 버퍼, 21편의 페치 버퍼 |
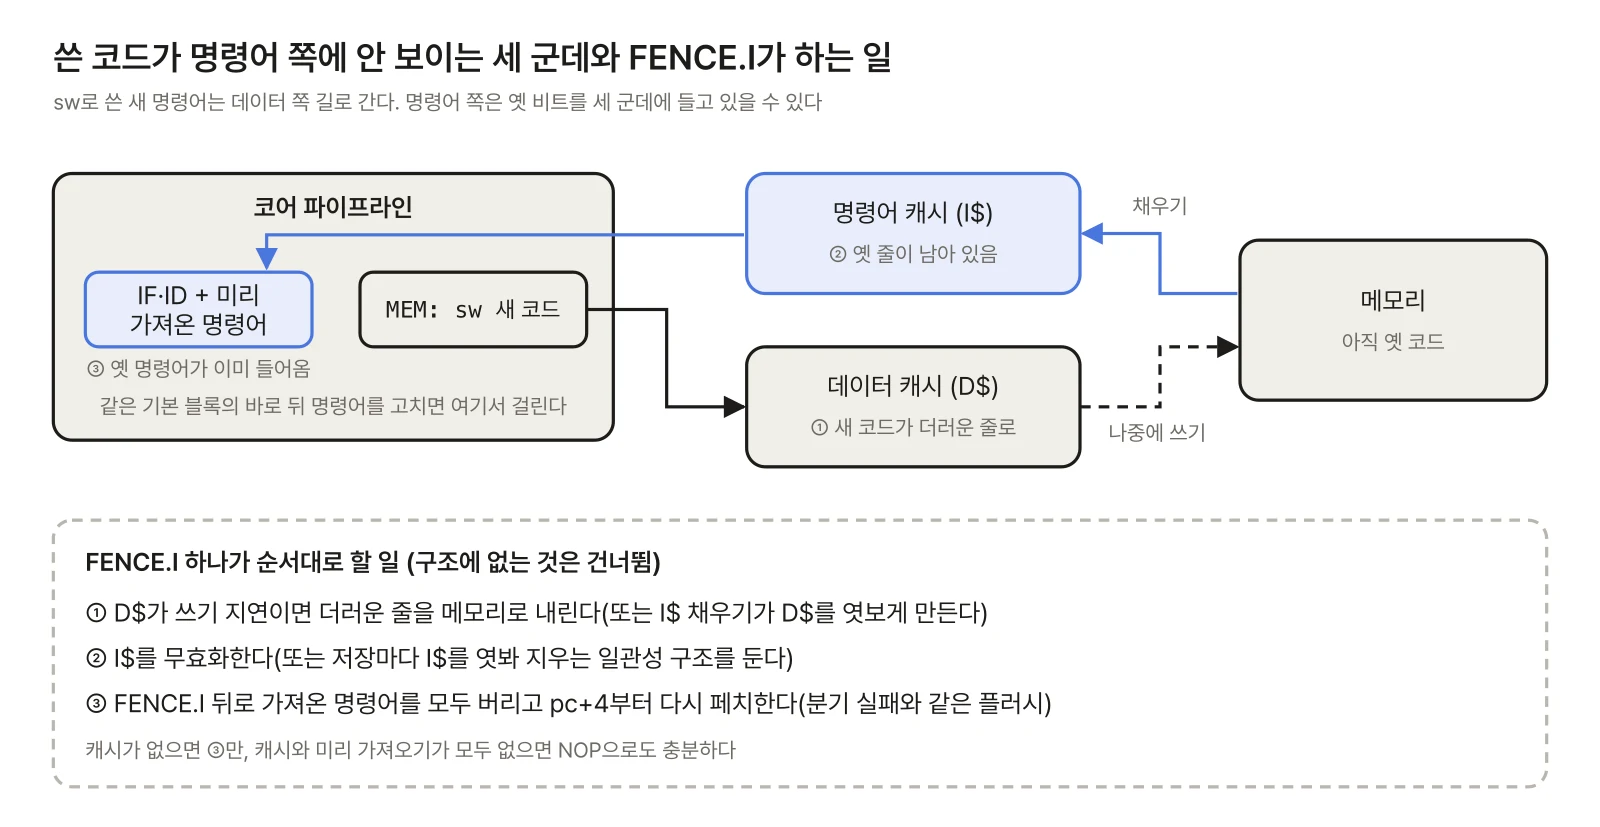
③은 캐시가 없는 가장 단순한 코어에도 있다. 바로 다음 명령어를 고치는 경우를 손으로 따라가 보자. 실습 코드의 시험 2는 이렇다.
80000110: sw   t1,0(t0)    # t0 = 0x80000114
80000114: addi a0,x0,11    # 이 명령어를 addi a0,x0,22로
5단 파이프라인에서 사이클별 위치는 다음과 같다.
사이클   IF          ID      EX      MEM
  1      sw
  2      addi(114)   sw
  3      다음        addi    sw
4 다음 addi sw → 0x114에 씀sw가 MEM에서 0x80000114에 쓰는 사이클 4에는, 그 주소의 옛 addi가 이미 EX에서 실행되고 있다. 옛 명령어는 사이클 2에 페치됐다. 미리 가져오기 버퍼가 있으면 더 멀리 떨어진 명령어도 이미 들어와 있을 수 있다.
2. FENCE.I의 의미: 같은 하트만
FENCE.I(Zifencei 확장, 비특권 명세 6장)는 I 형식이고 opcode MISC-MEM(0001111), funct3 001이다. rs1·rd·imm 칸은 미래의 세밀한 펜스를 위해 남겨 뒀고, 구현은 이 칸을 무시해야 한다. 명세의 규칙은 두 문장으로 요약된다.
- RISC-V는 명령어 메모리에 한 저장이 그 하트의 명령어 페치에 보인다는 것을, 그 하트가 FENCE.I를 실행하기 전에는 보장하지 않는다.
- FENCE.I는 그 뒤의 명령어 페치가 "같은 하트에 이미 보이는" 앞선 데이터 저장을 모두 보게 한다. 다른 하트의 페치는 보장하지 않는다.
"같은 하트에 이미 보이는"이 ①의 근거다. D와 메모리에서 채우는 I를 내리거나(write back), I를 엿보게(snoop) 해야 한다.
20편의 FENCE와 이름이 비슷하지만 하는 일은 다르다.
| 항목 | FENCE | FENCE.I |
|---|---|---|
| 맞추는 것 | 데이터 접근(R·W·I·O)끼리의 순서 | 데이터 저장 → 명령어 페치 |
| 누구 기준 | 다른 하트·장치가 관찰하는 순서 | 같은 하트만 |
| 단순 in-order 코어 | 순서를 바꾸는 구조가 없으면 NOP | 5단 파이프라인이면 최소한 플러시 |
| 확장 | 기본 RV32I | Zifencei (원래 기본 ISA에 있다가 분리됨) |
FENCE.I가 기본 ISA에서 빠진 이유도 명세 해설에 있다. I가 서로 일관되지 않은 설계에서는 FENCE.I가 두 캐시를 통째로 비워야 해서 비싸고, 다하트 환경의 사용자 모드에서는 그것만으로 충분하지도 않기 때문이다(아래에서 설명). 그래서 FENCE를 NOP으로 처리할 수 있는 단순한 코어라도 FENCE.I는 따로 생각해야 한다.
명령어 캐시가 있는 하트 여럿에 새 코드를 보이게 하려면, 명세는 쓴 하트가 먼저 데이터 FENCE를 실행하고 다른 모든 하트에 FENCE.I 실행을 요청하라고 한다. 요청 방법은 명세 밖(실행 환경)이다. 흔한 방법은 둘이다.
| 방법 | 하는 일 |
|---|---|
| IPI + FENCE.I | 쓴 하트가 다른 하트에 소프트웨어 인터럽트를 보내고, 받은 하트가 처리기에서 FENCE.I |
SBI sbi_remote_fence_i |
S 모드 OS가 M 모드 펌웨어(OpenSBI 등)에 요청. SBI RFENCE 확장 |
리눅스는 같은 이유로 FENCE.I를 사용자 모드 ABI에서 뺐다. 스레드가 FENCE.I 직후 다른 하트로 옮겨지면 소용이 없기 때문이다. 대신 시스템 호출(riscv_flush_icache)로 OS에 맡긴다. 명세 6장의 해설이 이 사정을 그대로 적어 두었다.
3. 코어 구조별 FENCE.I 구현
명세는 구현 방법을 정하지 않고 결과만 요구한다. 해설은 "간단한 구현은 로컬 명령어 캐시와 명령어 파이프라인을 비우면 된다", "I가 일관되게 유지되거나 캐시 없는 RAM뿐이면 페치 파이프라인만 비우면 된다"고 적는다. 구조에 따라 정리하면 다음과 같다.
| 코어 구조 | FENCE.I가 할 일 |
|---|---|
| 캐시 없음, 가져온 명령어 없음 | 없음 (NOP) |
| 캐시 없음, 파이프라인·미리 가져오기 있음 | 뒤 명령어 플러시, pc+4부터 다시 페치 |
| I 또는 D$ 없음) | 플러시 + I$ 무효화 |
| I | 플러시 + I 더러운 줄 내리기 |
| I$가 저장을 엿봐 스스로 지움 | 플러시만 |
여기서 "캐시 없음, 가져온 명령어 없음"은 사실 5단 파이프라인에는 해당하지 않는다. 1절의 표처럼 5단 파이프라인은 그 자체로 명령어 두세 개를 앞서 가져오기 때문이다. 그래서 이 시리즈의 5단 코어에서 FENCE.I의 최소 구현은 "분기 예측 실패처럼 뒤를 비우고 pc+4로 다시 가기"다. 이미 있는 플러시 경로(18편의 분기 처리)를 그대로 쓰면 되니, 디코더에 FENCE.I를 "목적지 pc+4인 무조건 점프, 항상 예측 실패"로 표시하는 방법이 간단하다. 저장 버퍼가 있다면 앞선 저장이 메모리(또는 일관된 캐시)에 닿을 때까지 기다리는 것도 함께 해야 한다.
4. 실습 1: QEMU에서 자기 수정 코드
시험 코드(smc.c)는 두 가지를 한다. 장비는 맥 M1 Max, QEMU 11.1.3, riscv64-elf-gcc 16.2(-march=rv32i_zifencei)다.
- 시험 1 (다른 곳에 쓴 코드): 데이터 배열
code[]에addi a0,x0,1; ret을 쓰고 FENCE.I 뒤 호출한다. 같은 자리에addi a0,x0,2; ret을 쓰고 FENCE.I 없이 호출한다. 이어 FENCE.I 뒤 다시 호출한다. - 시험 2 (바로 다음 명령어): 1절의
sw+addi쌍을 FENCE.I 없이 한 번,sw와addi사이에 FENCE.I를 넣어 한 번 실행한다.
/* addi a0, x0, k */
#define LI_A0(k) ((uint32_t)(k) << 20 | 10u << 7 | 0x13u)
#define RET 0x00008067u   /* jalr x0, 0(ra) */
write_code(1); __asm__ volatile("fence.i" ::: "memory");
put("t1 first      ", ((fn)code)());
write_code(2);            /* fence.i 없음 */
put("t1 no fence.i ", ((fn)code)());| 시험 | QEMU 기본 | QEMU 명령어 하나씩 |
|---|---|---|
| 시험 1, 처음 | 1 | 1 |
| 시험 1, FENCE.I 없이 | 2 | 2 |
| 시험 1, FENCE.I 뒤 | 2 | 2 |
| 시험 2, FENCE.I 없이 | 11 | 22 |
| 시험 2, FENCE.I 뒤 | 22 | 22 |
QEMU는 FENCE.I 없이도 시험 1에서 새 코드를 실행했다. 실제 I"처럼 행동하는 셈이다.
반면 시험 2는 FENCE.I 없이 옛 코드(11)를 실행했다. 고친 명령어가 지금 실행 중인 변환 블록 안에 있었기 때문이다. 블록은 이미 번역됐으니 끝까지 옛 번역대로 돈다. 블록을 명령어 하나로 쪼개는 옵션(-accel tcg,one-insn-per-tb=on)으로 다시 돌리자 22가 나왔다. FENCE.I는 QEMU에서 블록을 끝내고 다음 블록을 새로 번역하게 하므로 두 경우 모두 22다.
정리하면 QEMU는 명세가 허용하는 행동 중 하나를 보일 뿐, 하드웨어와 같지 않다. FENCE.I를 빠뜨린 소프트웨어 버그가 QEMU에서는 드러나지 않을 수 있고, 반대로 RTL 검증의 기준 모델로 QEMU를 쓸 때 FENCE.I 없는 자기 수정 코드는 비교 대상에서 빼야 한다.
5. 실습 2: 명령어 모델로 16가지 조합
같은 smc.elf를 직접 짠 작은 RV32I 명령어 모델(iss.py)에서 실행했다. ELF의 적재 세그먼트를 메모리에 올리고, UART 주소 저장을 글자로 모으고, 종료 장치 쓰기에서 멈춘다. 명령어 쪽에는 세 가지를 넣을 수 있다.
- 미리 가져오기 큐: 실행할 명령어보다 최대 3개 앞까지 순서대로 가져와 둔다(5단 파이프라인의 IF·ID와 버퍼 하나에 해당한다고 본 모델 선택). 분기가 일어나면 비운다.
- I$: 직접 사상, 16줄 × 16바이트. 미스면 메모리에서 채운다.
- 쓰기 지연 D$: 저장을 "더러운 워드"로 들고 있다가 FENCE.I가 내리라고 할 때만 메모리에 쓴다. 로드는 이것을 먼저 본다.
def fence_i(self):
    if self.fencei == 'nop': return
    if self.fencei == 'full' and self.wb:   # ① D$ 내리기
        for a, v in self.dirty.items():
            self.write_mem(a, v)
        self.dirty = {}
    if self.fencei in ('flush+inval', 'full'):
        self.itag = [None] * len(self.itag) # ② I$ 무효화
    self.redirect(self.pc + 4)              # ③ 플러시
먼저 정확성 검사로, 캐시도 미리 가져오기도 없는 구성 A의 출력이 QEMU를 명령어 하나씩 돌린 결과와 다섯 줄 모두 같은지 확인했다(같았다). 그다음 코어 구성 4가지와 FENCE.I 구현 4가지(NOP, 플러시만, 플러시 + I 내리기)를 모두 돌렸다.
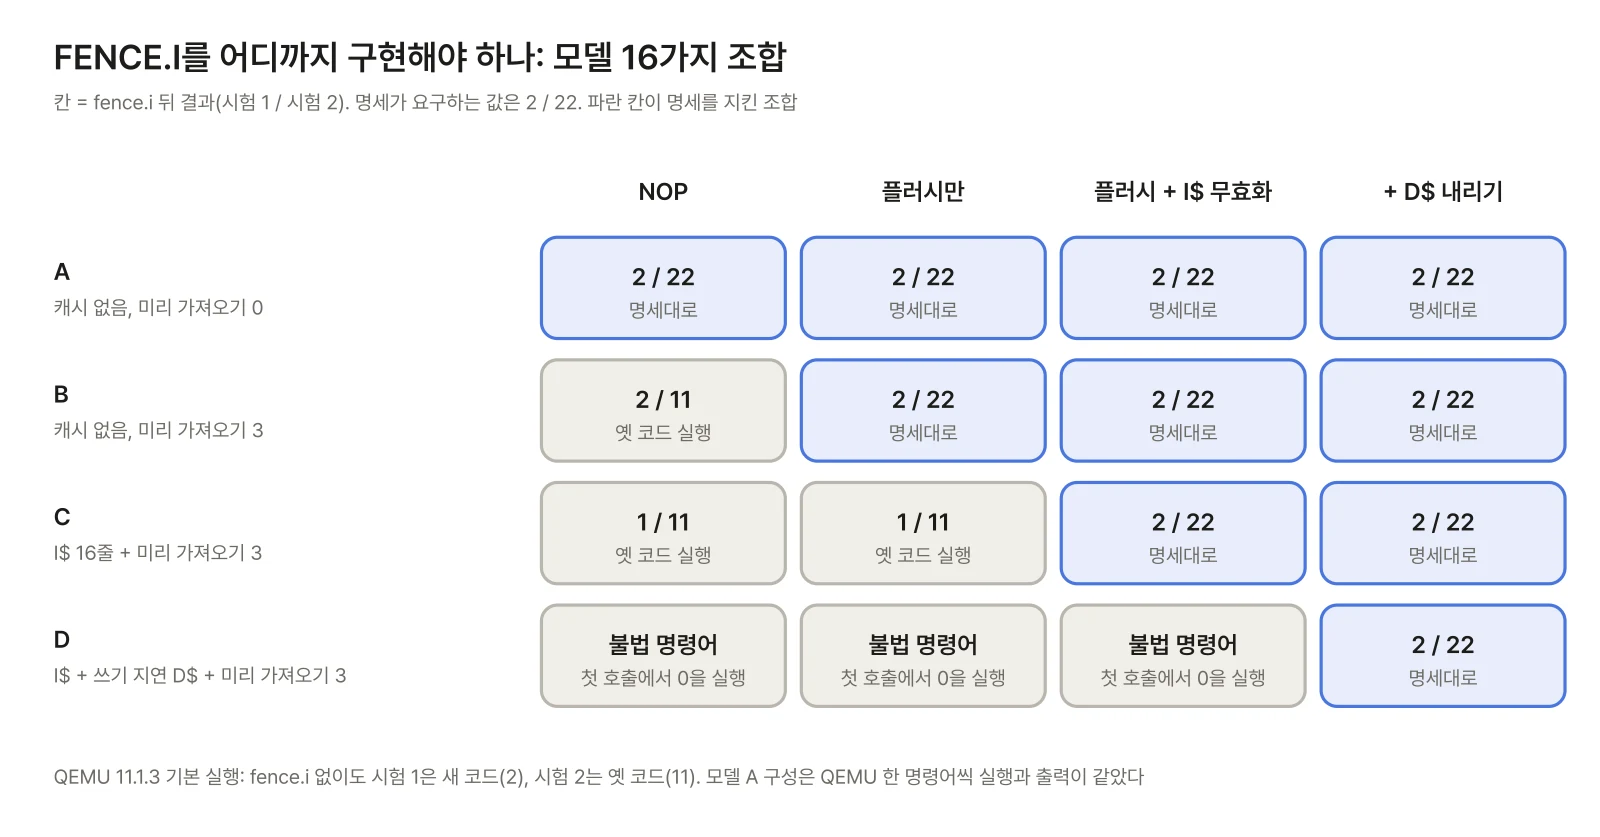
| 코어 구성 | FENCE.I 없이 시험 1 / 2 | 명세를 지키는 최소 구현 |
|---|---|---|
| A 캐시 없음, 미리 가져오기 0 | 2 / 22 | NOP |
| B 캐시 없음, 미리 가져오기 3 | 2 / 11 | 플러시 |
| C I$ + 미리 가져오기 3 | 1 / 11 | 플러시 + I$ 무효화 |
| D I + 미리 가져오기 3 | 첫 호출부터 실패 | + D$ 내리기 |
구성 D에서 FENCE.I가 D에만 있었다. I$는 메모리의 0을 가져왔고, 0x80000200에서 0x00000000(불법 명령어)을 실행하게 됐다. 21편에서 본 대로 전부 0인 명령어를 명세가 불법으로 정해 둔 덕분에, 이런 버그는 엉뚱한 실행 대신 즉시 트랩으로 드러난다.
FENCE.I 없이의 결과를 보면 QEMU 기본 실행(2 / 11)은 구성 B, 즉 "캐시는 없고 앞서 가져온 명령어만 있는 코어"와 같은 모양이었다.
비용도 하나 쟀다. 구성 C에서 프로그램 전체(693개 명령어, FENCE.I 3번)의 I 전체를 버리므로, 실제 코드에서는 무효화 뒤에 실행하는 코드의 크기만큼 미스가 생긴다. 명세 해설이 JIT 컴파일러의 예로 "번역한 명령어를 길게 만든 뒤 FENCE.I를 한 번만 부르는" 방식을 드는 이유다.
6. 5단 코어에서의 구현 세부
RTL로 옮길 때 정해야 할 것이 몇 가지 있다. 명세가 정하지 않는 부분이라 흔한 선택을 적는다.
어느 단계에서 처리하나. FENCE.I는 앞선 저장이 끝난 뒤에 효과를 내야 한다. 5단 코어에서 가장 단순한 방법은 FENCE.I를 MEM 단계까지 보낸 뒤(앞선 sw는 이미 WB 쪽으로 넘어감), 그 시점에 I 미스 비용이 더해진 만큼이다(추정, 구현마다 다름).
**I는 뒤쪽을 고르는 경우가 많다(추정).
**D의 더러운 줄을 모두 내리는 것은 비싸다. 그래서 I를 먼저 엿보게 하거나, 둘 아래에 통합 L2를 두고 L1 D·D$를 일관되게 유지하는 여러 방법을 예로 든다.
실제로 언제 쓰이나. 자기 수정 코드라고 하면 특이한 기법 같지만, 흔한 곳에 숨어 있다. 부트로더가 플래시의 다음 단계 코드를 RAM에 복사하고 뛰어들 때, OS가 프로그램을 메모리에 올릴 때, 디버거가 소프트웨어 중단점(ebreak)을 써 넣을 때, JIT가 코드를 만들 때다. 5절 구성 D가 첫 호출부터 실패한 모습이 바로 "복사하고 FENCE.I 없이 뛰어든 부트로더"의 증상이다.
7. 설계 체크리스트: FENCE.I
| 항목 | 규칙 |
|---|---|
| 인코딩 | MISC-MEM, funct3 001. rs1·rd·imm은 무시(소프트웨어는 0으로) |
| 최소 구현 | 뒤 명령어 플러시 + pc+4 재페치. 5단 파이프라인이면 언제나 필요 |
| I$ | 무효화하거나, 저장을 엿봐 지우는 일관성 구조 |
| 쓰기 지연 D$ | 더러운 줄을 내리거나, I를 엿봄 |
| 저장 버퍼 | 앞선 저장이 I$가 보는 곳까지 닿은 뒤 플러시 |
| 페치 버퍼(C 확장) | 비운다. 남은 16비트 칸도 옛 비트다 |
| 분기 예측기·BTB | 옛 코드 기준 예측이 남아도 정확성 문제는 없다(예측 실패로 고쳐짐). 비우는 것은 선택 |
| 범위 | 같은 하트만. 다른 하트는 IPI 또는 SBI sbi_remote_fence_i |
| 사용자 모드 | 명령어는 실행 가능하지만 리눅스 ABI는 시스템 호출 사용 |
| 트랩 | FENCE.I 자체는 트랩 없음. Zifencei를 구현하지 않으면 불법 명령어로 처리하는 것이 흔한 선택 |
| 디버그 중단점 | 디버거가 ebreak를 써 넣는 것도 자기 수정 코드. 디버그 모드 진입·복귀 때 같은 처리가 필요(37편) |
정리
- 저장한 코드가 명령어 쪽에 안 보이는 자리는 쓰기 지연 D, 이미 가져온 명령어 셋이다. 캐시가 없는 5단 파이프라인에도 셋째는 있다.
- FENCE.I는 같은 하트의 이후 페치가 그 하트에 보이는 앞선 저장을 모두 보게 한다. 다른 하트에는 IPI나 SBI
sbi_remote_fence_i로 각자 FENCE.I를 실행시켜야 한다. - 명령어 모델 16가지 조합에서, FENCE.I가 할 일은 구조에 따라 NOP → 플러시 → 무효화 → D$ 내리기로 늘었다. 하나라도 빠지면 옛 코드(1, 11)를 실행하거나 첫 호출부터 불법 명령어를 만났다.
- QEMU 11.1.3은 FENCE.I 없이도 다른 곳에 쓴 코드는 새 것을, 실행 중인 블록 안의 바로 다음 명령어는 옛 것을 실행했다. 변환 블록 단위 번역 때문이라 하드웨어와 다르다.
다음 글: 23편부터 3부 특권 아키텍처로 넘어간다. 첫 편은 특권 모드와 CSR이다. M·S·U 모드가 왜 나뉘었는지, CSR 주소 12비트에 권한과 읽기 전용 여부가 어떻게 들어 있는지, WARL·WLRL 필드가 구현에 무엇을 맡기는지, 그리고 앞으로 다룰 주요 CSR의 지도를 그린다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 6장 "Zifencei" 확장, 2.7절 메모리 순서 명령어, 17장 RVWMO. https://github.com/riscv/riscv-isa-manual
- RISC-V Supervisor Binary Interface Specification, RFENCE 확장(
sbi_remote_fence_i). https://github.com/riscv-non-isa/riscv-sbi-doc - D. Harris 외, RISC-V System-on-Chip Design, 2023. 캐시와 FENCE.I 구현(CORE-V Wally)
- D. Patterson, J. Hennessy, Computer Organization and Design: RISC-V Edition. 4장 파이프라인, 5장 메모리 계층
- QEMU TCG 문서(변환 블록과 자기 수정 코드). https://www.qemu.org/docs/master/devel/tcg.html