이 글의 핵심 3줄
- M 확장은 곱셈 4개(
mulmulhmulhsumulhu)와 나눗셈 4개(divdivuremremu), RV64에서 W 명령어 5개를 더한다. 곱의 아래 절반은 부호와 상관없이 같아서mul하나, 위 절반은 해석에 따라 셋이다. - 0으로 나누기와 부호 있는 오버플로(−2³¹ ÷ −1)도 예외 없이 정해진 값을 낸다. 0 나누기의 몫은 모든 비트 1, 나머지는 피제수, 오버플로의 몫은 피제수, 나머지는 0이다.
- QEMU에서 경계값 쌍 1,948개를 실행해 Python 기준 모델과 모두 일치했다. M이 없으면 곱셈 한 번에 명령어가 86개 더 들고(libgcc 호출), 나눗셈은 약 160개 더 들었다.
앞 편들에서 본 RV32I에는 곱셈도 나눗셈도 없다. 덧셈·시프트·비교만으로 곱셈을 만들 수는 있지만 느리다. 7편부터는 확장을 하나씩 붙인다. 첫 번째가 정수 곱셈·나눗셈을 더하는 M 확장이다. 명령어 수는 적지만, 0으로 나누기와 오버플로처럼 "보통은 예외를 내는" 경우에 RISC-V가 내는 정해진 결과가 설계에 그대로 이어진다. 이 편에서는 명령어의 뜻과 경계 규칙을 QEMU로 확인하고, 곱셈기·나눗셈기 회로는 19편(M 확장 구현)으로 미룬다.
실행 환경은 3편과 같다. QEMU 11.1.3의 virt 보드에 베어메탈 프로그램을 올리고 UART로 결과를 찍었다. 장비는 맥 M1 Max, 컴파일러는 riscv64-elf-gcc 16.2다.
1. M 확장 한눈에
M 확장 명령어는 모두 R 형식이고, opcode와 funct7으로 기본 정수 연산과 구별된다. RV32I의 add·sub가 쓰는 opcode OP(0110011)를 그대로 쓰고, funct7을 0000001로 둔다. 연산은 funct3 세 비트가 고른다. 아래 값은 GNU as가 만든 기계어에서 직접 뽑았다.
| funct3 | OP (0110011) |
OP-32 (0111011, RV64만) |
|---|---|---|
| 000 | mul |
mulw |
| 001 | mulh |
|
| 010 | mulhsu |
|
| 011 | mulhu |
|
| 100 | div |
divw |
| 101 | divu |
divuw |
| 110 | rem |
remw |
| 111 | remu |
remuw |
funct3의 맨 윗비트가 곱셈(0)과 나눗셈(1)을 가른다. 디코더 입장에서는 "funct7 = 0000001이면 M, inst[14]로 곱셈기냐 나눗셈기냐"가 된다. RV64의 W 명령어는 5편에서 본 addw처럼 OP-32 opcode를 쓰고, 곱셈 상위 절반 W 버전은 없다.
곱셈과 나눗셈을 기본 ISA에서 뺀 이유를 명세는 이렇게 설명한다. 작은 구현이나, 곱셈·나눗셈이 드물거나 가속기에 맡기는 응용에서 하드웨어를 덜기 위해서다. 그래서 RV32I만 구현한 코어도 정당한 RISC-V 코어이고, 그런 코어용 컴파일러는 곱셈을 라이브러리 함수 호출로 바꾼다. 6절에서 그 비용을 잰다.
2. 곱셈: 아래 절반은 하나, 위 절반은 셋
32비트 두 수를 곱하면 결과는 64비트다. mul은 그 아래 32비트를 rd에 넣는다. mulh·mulhsu·mulhu는 같은 곱의 위 32비트를 넣는데, 두 피연산자를 부호 있게 읽느냐 없게 읽느냐가 다르다.
| 명령어 | rs1 해석 | rs2 해석 | 결과 |
|---|---|---|---|
mul |
(상관없음) | (상관없음) | 곱의 [31:0] |
mulh |
부호 있음 | 부호 있음 | 곱의 [63:32] |
mulhsu |
부호 있음 | 부호 없음 | 곱의 [63:32] |
mulhu |
부호 없음 | 부호 없음 | 곱의 [63:32] |
왜 아래 절반 명령어는 하나뿐일까. 숫자로 따라가 보자. rs1 = 0xfffffff9, rs2 = 7이다. 부호 있게 읽으면 −7 × 7 = −49이고, 64비트로 쓰면 0xffffffff_ffffffcf이다. 부호 없이 읽으면 4,294,967,289 × 7 = 30,064,771,023 = 0x00000006_ffffffcf이다. 아래 32비트는 둘 다 0xffffffcf로 같고, 위 32비트만 0xffffffff와 0x00000006으로 다르다.
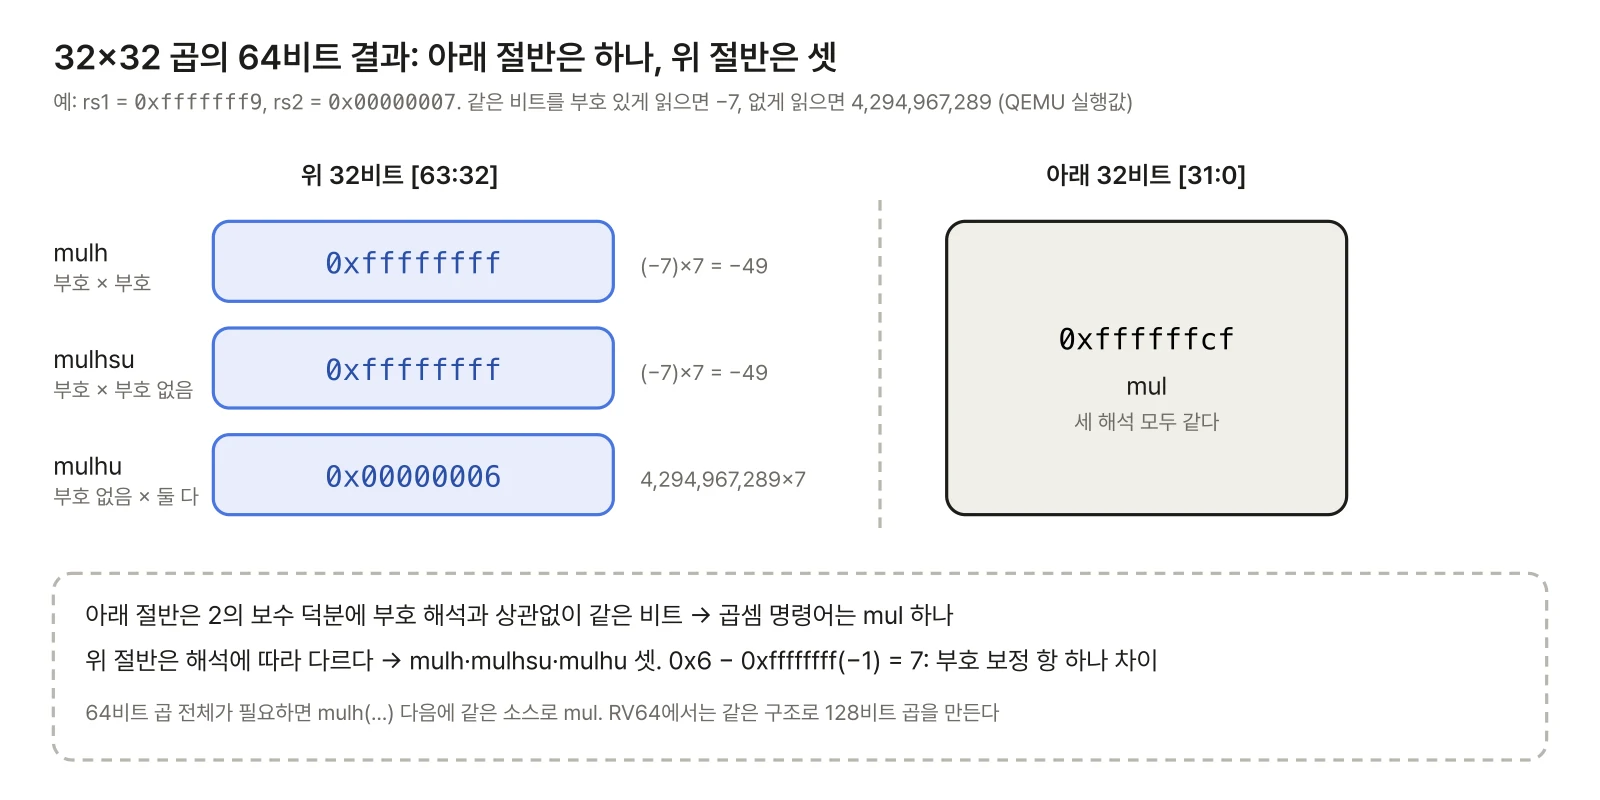
2의 보수 덧셈이 부호를 몰라도 되는 것과 같은 이치다. n비트 곱의 아래 n비트는 두 수를 2ⁿ으로 나눈 나머지만으로 정해지고, 부호 있는 해석과 없는 해석은 2ⁿ의 배수만큼 차이 나기 때문이다. 위 절반의 차이는 식으로 쓰면 이렇다. 부호 없는 값 와 부호 있는 값 는 관계다.
말로 풀면, 부호 없이 읽은 곱의 위 절반은 부호 있게 읽은 위 절반에 "음수였던 쪽이 상대 피연산자를 한 번 더 더한 값"이다. 위 예에서 , 이니 mulh의 0xffffffff(−1)에 b = 7을 더해 6이 된다. QEMU의 mulhu 결과 0x00000006과 맞는다. 곱셈기 하드웨어는 보통 피연산자를 한 비트 늘려(33비트) 부호 확장 또는 0 확장을 고른 뒤 같은 부호 있는 곱셈기로 세 명령어를 모두 처리한다. 이 구조는 19편에서 다룬다.
mulhsu는 어디에 쓸까. 명세의 설명대로 여러 워드로 된 부호 있는 큰 수를 곱할 때, 부호 비트가 든 최상위 워드와 부호 없는 아래 워드를 곱하는 데 쓴다. 경계값도 몇 개 보자(QEMU 실행값).
rs1 × rs2     mul         mulh        mulhu
-1 × -1       0x00000001  0x00000000  0xfffffffe
min × min     0x00000000  0x40000000  0x40000000
-7 × 7        0xffffffcf  0xffffffff  0x00000006
min은 0x80000000(−2³¹)이다. (−2³¹)² = 2⁶²라 mulh는 0x40000000, 부호 없이 읽은 2³¹ × 2³¹도 2⁶²라 mulhu도 같다. −1 × −1은 부호 있게는 1이라 위 절반이 0이지만, 부호 없이 읽으면 (2³² − 1)²이라 위 절반이 0xfffffffe다.
3. 나눗셈: 0 쪽으로 버리고, 나머지는 피제수 부호
div·divu는 몫을, rem·remu는 나머지를 낸다. 부호 있는 나눗셈의 몫은 0 쪽으로 버린다(소수점 아래를 잘라낸다). 그 결과 나머지의 부호는 피제수(나눠지는 수)와 같아진다. C 언어의 /·%와 같은 규칙이다.
| 식 | 몫 (div) |
나머지 (rem) |
검산 |
|---|---|---|---|
| −7 ÷ 2 | −3 (0xfffffffd) |
−1 (0xffffffff) |
−3 × 2 − 1 = −7 |
| 7 ÷ −2 | −3 (0xfffffffd) |
1 | −3 × −2 + 1 = 7 |
| −7 ÷ 2 (부호 없음) | 0x7ffffffc |
1 | divu·remu |
셋째 줄은 같은 비트 0xfffffff9를 부호 없이 4,294,967,289로 읽은 경우다. 같은 피연산자인데 몫이 −3과 2,147,483,644로 전혀 다르다. 그래서 곱셈의 아래 절반과 달리 나눗셈은 부호 있는 것과 없는 것이 따로 있어야 한다.
4. 0으로 나누기와 오버플로: 예외 없이 정해진 값
여기가 M 확장에서 가장 중요한 규칙이다. 많은 ISA는 0으로 나누면 트랩을 낸다(x86의 #DE). RISC-V는 내지 않는다. 대신 결과를 정해 둔다.
| 경우 | 몫 div[u] |
나머지 rem[u] |
|---|---|---|
| x ÷ 0 | 모든 비트 1 | x |
−2³¹ ÷ −1 (div·rem만) |
−2³¹ | 0 |
RV32 QEMU에서 실행한 값은 이랬다.
div  7 / 0          -> 0xffffffff
divu 7 / 0          -> 0xffffffff
rem  7 / 0          -> 0x00000007
remu 0xfffffff9 / 0 -> 0xfffffff9
div  0x80000000 / -1 -> 0x80000000
rem  0x80000000 / -1 -> 0x00000000
divu 0x80000000 / 0xffffffff -> 0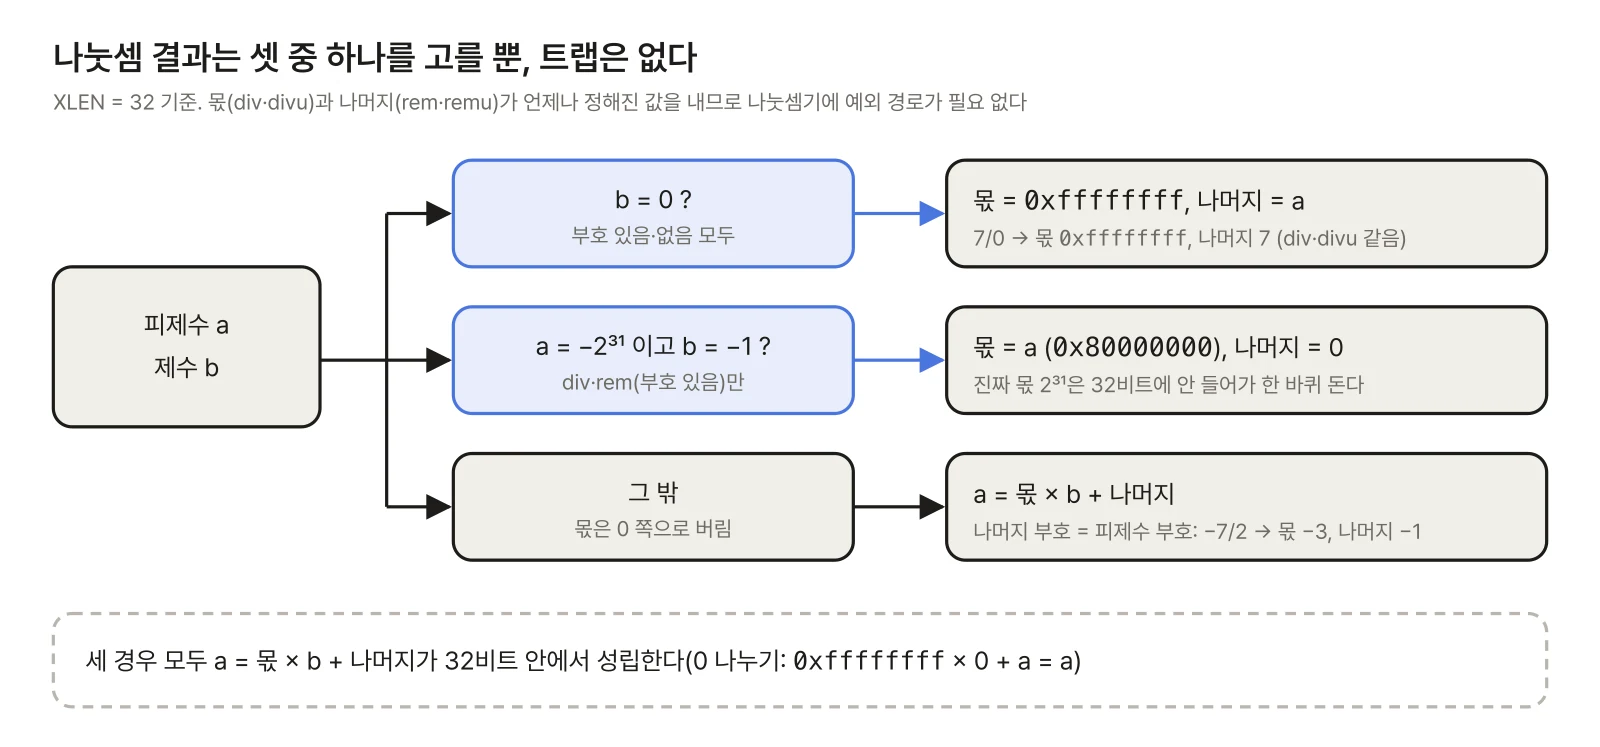
이 값들은 아무렇게나 고른 것이 아니다. 세 가지 이유가 있다.
- 항등식이 깨지지 않는다. 0 나누기에서 몫 × 0 + 나머지 = x, 오버플로에서 −2³¹ × −1 + 0 = 2³¹ ≡ −2³¹ (32비트에서 한 바퀴)이다. 피제수 = 제수 × 몫 + 나머지가 32비트 안에서 언제나 성립한다.
- 부호 없는 나눗셈기의 자연스러운 출력이다. 복원 나눗셈(restoring division)은 매 단계 "빼도 되면 빼고 몫 비트 1"을 한다. 제수가 0이면 언제나 뺄 수 있으니 몫 비트가 전부 1이 되고, 나머지 레지스터에는 피제수가 그대로 남는다. 명세는 부호 있는 나눗셈도 같은 값(모든 비트 1 = −1)으로 정해 부호 없는 회로를 재사용하기 쉽게 했다고 밝힌다.
- 트랩이 하나도 없다. 명세의 설명을 줄이면, 0 나누기 트랩을 넣으면 표준 ISA의 유일한 산술 트랩이 된다. 언어가 예외를 요구하면 나눗셈 뒤에
beqz하나를 넣으면 되고, 그 분기는 거의 언제나 안 뛰므로 비용이 작다.
GCC는 C의 a / b에 0 검사를 넣지 않았다(7절의 divmod 출력은 div·rem 두 줄이 전부다). C에서 0 나누기는 정의되지 않은 동작이기 때문이다. 0 검사가 필요한 언어(예: Java의 ArithmeticException)는 컴파일러가 분기를 직접 넣는다.
5. RV64: W 명령어와 128비트 곱
RV64M에서 mul·div 등 여덟 개는 64비트로 동작하고, 32비트 버전 mulw·divw·divuw·remw·remuw가 따로 있다. 규칙은 5편의 W 명령어와 같다. 아래 32비트만 보고 계산한 뒤 32비트 결과를 64비트로 부호 확장한다. 위 32비트에 무엇이 들어 있든 무시한다.
g = 0x12345678_7fffffff(위에 쓰레기, 아래는 0x7fffffff)로 확인했다.
mulw  g * 7     -> 0x000000007ffffff9
divw  g / 0     -> 0xffffffffffffffff
remw  g / 0     -> 0x000000007fffffff
remuw 0x80000000 / 0  -> 0xffffffff80000000
divuw 0x80000000 / -1 -> 0x0000000000000000
divw  0x80000000 / -1 -> 0xffffffff80000000
넷째 줄이 함정이다. remuw는 "부호 없는" 나머지인데도 결과 0x80000000을 부호 확장해 0xffffffff80000000이 됐다. 명세가 "REMW와 REMUW는 0 나누기를 포함해 언제나 32비트 결과를 부호 확장한다"고 못 박아 둔 부분이다. divuw의 0 나누기 몫도 0xffffffff를 부호 확장해 64비트 전부 1이 된다. RV64 레지스터에서는 32비트 값을 부호 확장된 모양으로 들고 다닌다는 5편의 원칙이 부호 없는 연산에도 그대로 적용된다.
GCC는 C의 int 곱셈·나눗셈을 RV64에서 mulw·divw·remuw 한 줄로 컴파일했다. 64비트끼리의 128비트 곱(unsigned __int128)은 RV32의 64비트 곱과 같은 구조로 mulhu + mul 두 줄이 됐다. 64비트 div·rem의 경계 규칙도 똑같이 확인했다: −2⁶³ ÷ −1의 몫은 0x8000000000000000, 나머지는 0이었다.
6. 실습: QEMU 실행 결과와 기준 모델, 그리고 M이 없을 때의 비용
정확성 대조. 경계값 9개(0, 1, −1, 2, −2, 7, −7, 2³¹−1, −2³¹)의 모든 쌍 81개에 RV32M 8개 명령어를, RV64에서는 값 10개의 쌍 100개에 13개 명령어를 실행했다. 인라인 어셈블리로 명령어 하나씩을 넣고, 컴파일러가 미리 계산하지 못하게 입력은 volatile에 담았다.
#define OP(op, a, b) ({ uint32_t r_; \
  __asm__ volatile(op " %0,%1,%2" \
    : "=r"(r_) : "r"(a), "r"(b)); r_; })
for (int i = 0; i < 9; i++)
  for (int j = 0; j < 9; j++) {
    volatile uint32_t a = V[i], b = V[j];
    show("mulh", a, b, OP("mulh", a, b));
    show("div", a, b, OP("div", a, b));
    /* … 8개 모두 */
  }
기준 모델은 Python 정수로 직접 썼다. 곱셈은 무한 정밀도로 곱한 뒤 자르고, 나눗셈은 abs(a) // abs(b)에 부호를 붙인 뒤 0 나누기·오버플로를 앞에서 따로 처리했다.
def div(a, b):
    a, b = sx(a, n), sx(b, n)
    if b == 0: return M          # 모든 비트 1
    if a == -(1 << (n-1)) and b == -1:
        return a & M             # 몫 = 피제수
    q = abs(a) // abs(b)         # 0 쪽으로 버림
    return (-q if (a < 0) != (b < 0) else q) & M
RV32M 648개(8개 × 81쌍)와 RV64M 1,300개(13개 × 100쌍)가 모두 기준 모델과 일치했고, 1절 표의 인코딩 13개도 GNU as 출력과 같았다.
M이 없으면 얼마나 드나. 무작위 쌍 1,000개(고정 시드 LCG, a는 32비트 전체, b는 1~65,535)에 곱셈·나눗셈을 하는 루프를 세 가지 -march로 컴파일하고, QEMU를 -icount shift=0으로 띄워 minstret(실행한 명령어 수)으로 셌다. 최적화는 -O2, M이 없는 쪽은 libgcc의 __mulsi3·__divsi3 등을 부른다. 세 빌드의 계산 결과(합계)는 모두 같았다.
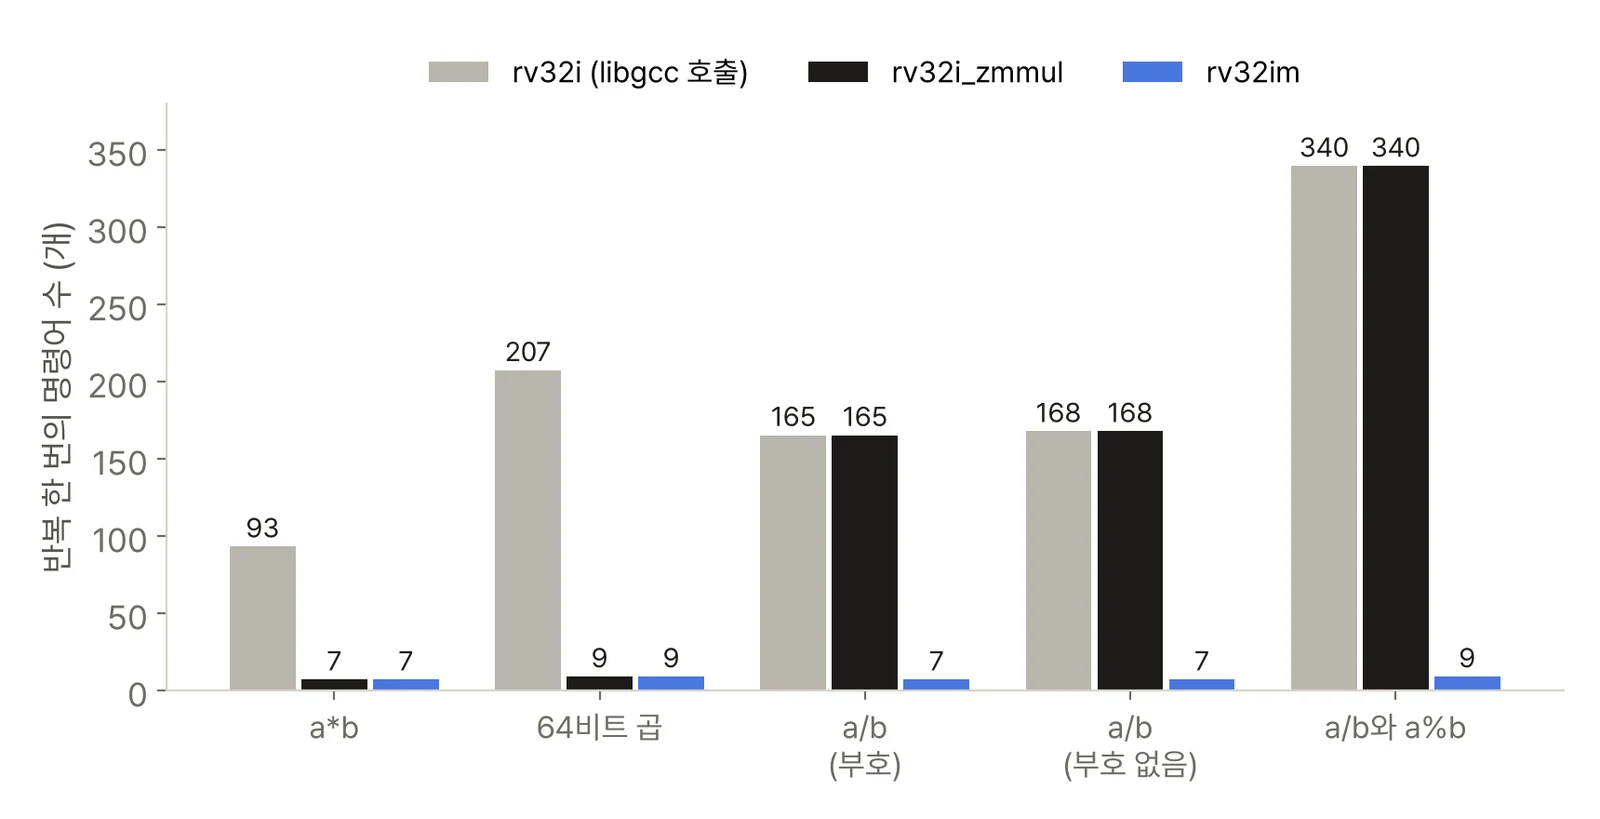
| 연산 (반복 1번) | rv32i | rv32i_zmmul | rv32im |
|---|---|---|---|
a ^ b (기준) |
7.0 | 7.0 | 7.0 |
a * b |
93.2 | 7.0 | 7.0 |
| 64비트 곱 | 207.3 | 9.0 | 9.0 |
a / b (부호) |
165.2 | 165.2 | 7.0 |
a / b, a % b |
339.6 | 339.6 | 9.0 |
기준 루프(xor)를 빼면 곱셈 한 번에 86.2개, 부호 있는 나눗셈 한 번에 158.2개, 몫과 나머지를 함께 구하면 332.6개의 명령어가 더 든다. 하드웨어 곱셈은 xor 자리를 mul 하나가 차지해 명령어 수가 늘지 않았다. 명령어 수일 뿐 사이클 수는 아니다. 실제 코어에서 mul·div가 몇 사이클 걸리는지는 구현에 달렸고, 특히 나눗셈은 여러 사이클이 흔하다.
7. 붙여 쓰는 순서와 Zmmul
상위·하위를 함께 구할 때. 64비트 곱 전체(RV64면 128비트)가 필요하면 명세가 권장하는 순서는 이렇다.
mulh[[s]u] rdh, rs1, rs2
mul        rdl, rs1, rs2
# 소스 순서가 같고, rdh는 rs1·rs2와 달라야 한다
div[u]     rdq, rs1, rs2
rem[u]     rdr, rs1, rs2
# rdq는 rs1·rs2와 달라야 한다
이렇게 쓰면 마이크로아키텍처가 두 명령어를 곱셈 한 번(나눗셈 한 번)으로 합칠 수 있다(명령어 융합, macro-op fusion). 조건이 붙는 이유는 간단하다. 첫 명령어가 소스 레지스터를 덮어쓰면 둘째 명령어의 입력이 달라져 같은 곱이 아니게 된다.
GCC 16.2의 실제 출력은 반만 맞았다.
umul64:                 divmod:
  mv    a5,a1             div  a5,a0,a1
  mulhu a1,a0,a1          rem  a0,a0,a1
  mul   a0,a0,a5          sw   a5,0(a2)
ret sw a0,0(a3)divmod는 권장 형태 그대로다(rdq=a5가 소스와 다르고 소스 순서가 같다). 반면 umul64는 mulhu가 결과를 rs2와 같은 a1에 넣었다. 그래서 mul은 복사해 둔 a5를 써야 했고, 두 명령어의 소스가 (a0, a1)과 (a0, a5)로 달라져 융합 조건에 맞지 않는다. 결과 64비트를 a1:a0에 돌려줘야 하는 호출 규약 때문으로 보인다(추정). 함수가 인라인되어 레지스터 제약이 풀리면 달라질 수 있다.
GCC는 상수 나눗셈에도 mulhu를 쓴다. a / 10(부호 없음)은 div 대신 마법 상수 0xcccccccd와 mulhu, srli 3으로 바뀌었다. 상위 절반 곱셈이 나눗셈보다 훨씬 빠른 구현이 많기 때문이다. a / 8(부호 있음)은 음수를 0 쪽으로 버리기 위해 srai·andi·add로 7을 더한 뒤 srai 3을 했다.
Zmmul. M 중 곱셈 명령어(mul mulh mulhsu mulhu, RV64에서 mulw)만 뽑은 확장이다. 인코딩은 M과 같고, M은 Zmmul을 포함한다. 명세는 마이크로컨트롤러처럼 나눗셈이 드물어 나눗셈기 면적이 아까운 경우, 그리고 곱셈기는 하드 블록으로 있지만 나눗셈기는 로직으로 만들어야 하는 FPGA 소프트 코어를 예로 든다. 6절 표의 rv32i_zmmul 열이 정확히 그 모습이다. 곱셈은 rv32im과 같고, 나눗셈은 rv32i처럼 __divsi3·__modsi3을 부른다.
8. 설계 체크리스트: M 확장
| 항목 | 규칙 |
|---|---|
| 디코드 | opcode OP/OP-32, funct7 = 0000001. inst[14]가 곱셈(0)·나눗셈(1) |
mulh 3종 |
피연산자를 33비트로 부호/0 확장해 한 곱셈기로. mulhsu는 rs1만 부호 |
| 0 나누기 | 몫 모든 비트 1, 나머지 = 피제수. div·divu 같다. 예외 없음 |
| 오버플로 | div: −2^(XLEN−1) ÷ −1 → 몫 = 피제수, 나머지 0. 예외 없음 |
| 나머지 부호 | 0이 아니면 피제수 부호. 몫은 0 쪽으로 버림 |
| W 명령어 | 아래 32비트만 쓰고 결과 32비트를 부호 확장. remuw·divuw도 |
| W의 경계값 | L = 32로 판단: divw의 오버플로는 아래 32비트가 0x80000000, 0xffffffff일 때 |
| 트랩 경로 | M 명령어는 불법 명령어 외에 예외를 내지 않는다. 결과 선택기만 있으면 된다 |
| 다중 사이클 | 나눗셈이 여러 사이클이면 결과 쓰기 전까지 rd 의존 명령어를 멈춰야 한다 |
| 융합(선택) | mulh+mul, div+rem을 합칠지는 구현 자유. 소스·rd 조건 확인 |
| Zmmul만 구현 | 구현하지 않은 나눗셈 인코딩은 보통 불법 명령어 예외 |
"트랩 경로" 줄이 설계에 주는 뜻이 크다. 정수 실행 장치 어디에서도 산술 예외가 나오지 않으므로, 곱셈기·나눗셈기를 여러 사이클짜리 별도 장치로 떼어 내도 정밀 예외(27편)를 걱정할 필요가 없다. 결과가 늦게 나올 뿐 "중간에 트랩이 나서 되돌려야 하는" 경우가 없다. 0 나누기 검사는 나눗셈을 시작하기 전에 제수가 0인지 보고 결과를 바로 고르는 조기 종료로 쓰기도 한다. 명세가 정한 것은 결과 값뿐이고, 몇 사이클 만에 낼지는 구현 자유다.
정리
- M 확장은 곱셈 4개, 나눗셈 4개, RV64의 W 명령어 5개다. 곱의 아래 절반은 부호와 무관해
mul하나, 위 절반은mulh·mulhsu·mulhu셋이다. - 부호 있는 나눗셈은 0 쪽으로 버리고 나머지는 피제수 부호를 따른다. 0 나누기(몫 모든 비트 1, 나머지 피제수)와 오버플로(몫 피제수, 나머지 0)는 예외 없이 정해진 값이다.
- W 명령어는 부호 없는
remuw·divuw도 결과를 부호 확장한다. QEMU 실행 1,948개가 기준 모델과 모두 일치했다. - M이 없으면 곱셈 한 번에 명령어 86개, 나눗셈 한 번에 약 160개가 더 든다.
mulh+mul,div+rem순서는 융합을 위한 권장 형태이고, GCC는 나눗셈 쪽만 그 형태로 냈다.
다음 글: 8편에서는 A 확장을 본다. 여러 하트가 같은 메모리를 다룰 때 필요한 원자 명령어, lr.w·sc.w의 예약과 실패 조건, amoswap·amoadd 등 AMO 9종, 그리고 aq·rl 비트의 뜻을 다룬다. 스핀락과 원자 카운터를 두 방식으로 짜서 QEMU에서 하트 여러 개로 경쟁시켜 본다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 13장 "M" 확장(13.1 곱셈, 13.2 나눗셈과 0 나누기·오버플로 표, 13.3 Zmmul), 4장 RV64I(W 명령어). https://github.com/riscv/riscv-isa-manual
- D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 4장 RV32M
- D. Harris, S. Harris, Digital Design and Computer Architecture: RISC-V Edition, 2021. 5.2.6 곱셈, 5.2.7 나눗셈
- GCC libgcc 정수 산술 루틴(
__mulsi3,__divsi3,__modsi3). https://gcc.gnu.org/onlinedocs/gccint/Integer-library-routines.html - QEMU
-icount옵션과virt보드 문서. https://www.qemu.org/docs/master/system/riscv/virt.html