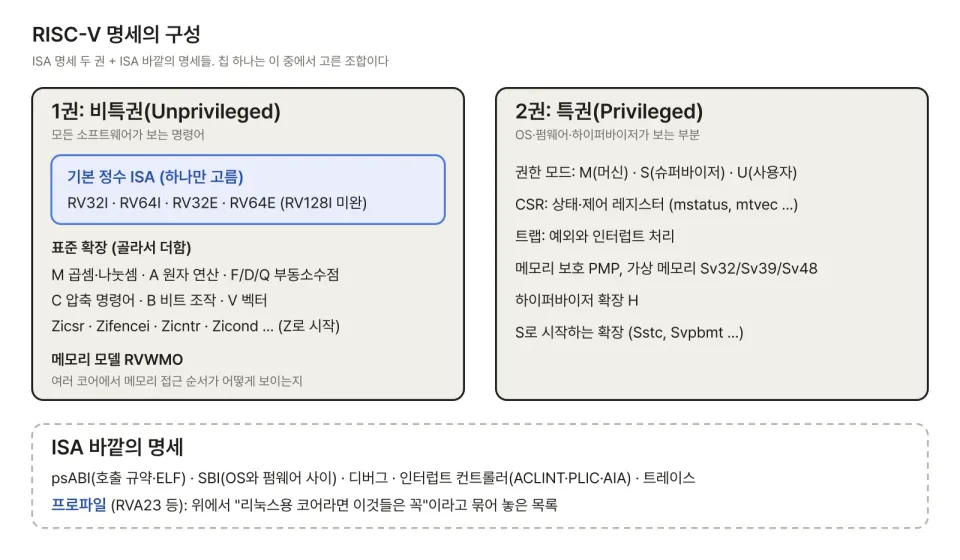
이 글의 핵심 3줄
- Zicsr의 CSR 명령어 6개는 "어느 칸이
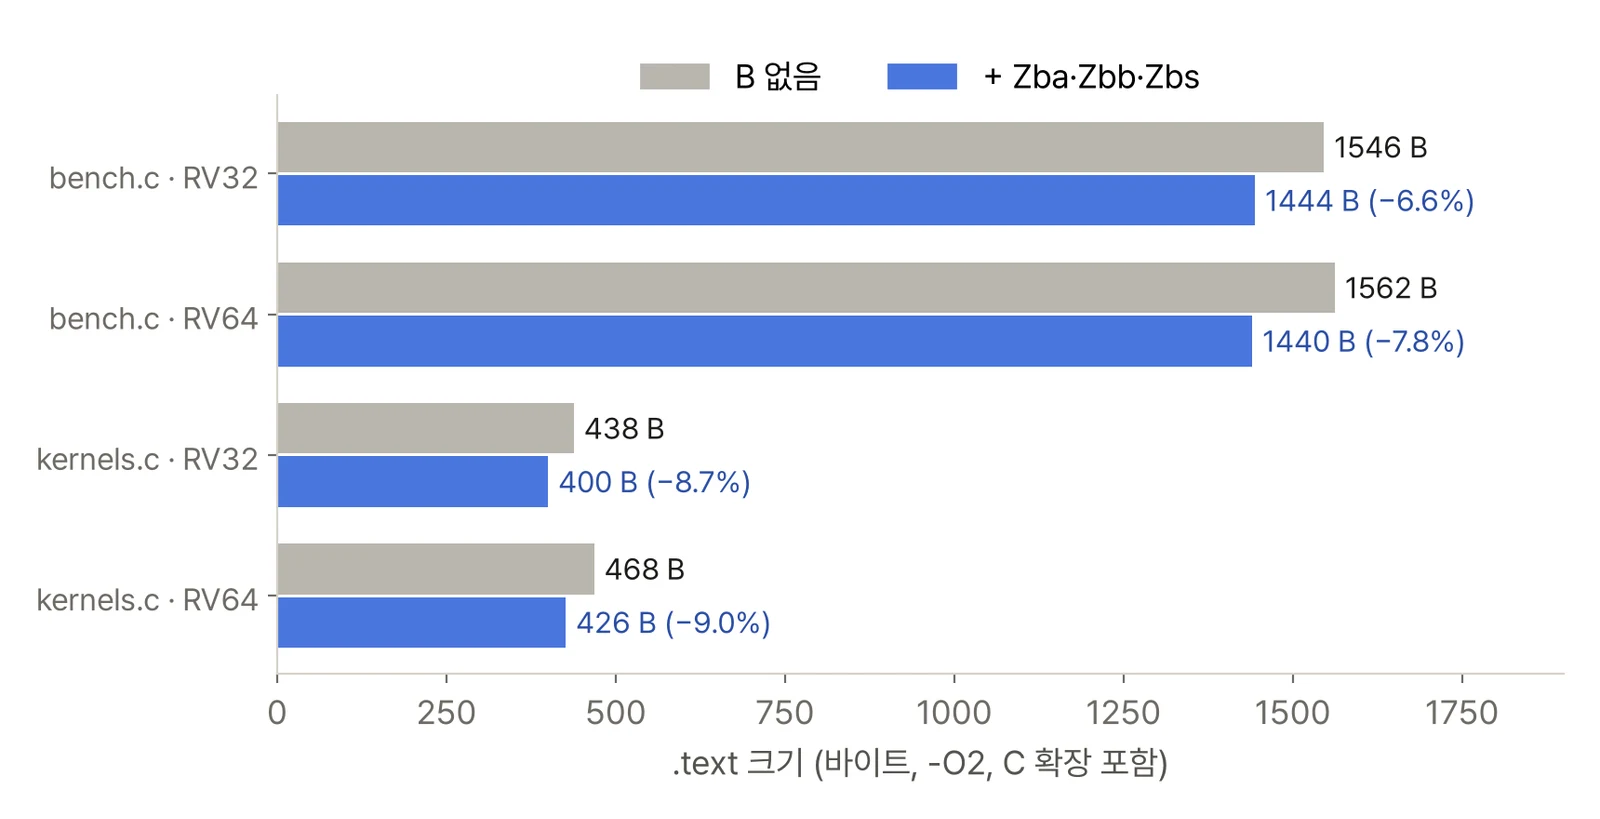
x0인가"로 읽기·쓰기 여부가 갈린다.csrrw는 rd=x0이면 읽지 않고,csrrs·csrrc는 rs1=x0이면 쓰지 않는다. 값이 아니라 칸을 본다. QEMU에서 rs1 레지스터 값이 0이어도 읽기 전용 CSR에csrrs를 하면 불법 명령어 예외가 났다. - B 확장(Zba·Zbb·Zbs)의 비트 조작 명령어를 QEMU에서 RV32 2,772개, RV64 3,720개 조합으로 실행해 Python 기준 모델과 모두 일치함을 확인했다. 같은 C 코드가 B를 켜면 6.6~9.0% 작아졌다.
- Zicond의
czero.eqz·czero.nez는 분기 없는 선택을 명령어 세 개로 만든다. QEMU 11.1.3의 기본 CPU는 Zba·Zbb·Zbs·Zicbom이 켜져 있지만 Zicond는 꺼져 있어-cpu rv32,zicond=true가 필요했다.
앞 편들에서 기본 정수 ISA와 M·A·F·D·C 확장까지 봤다. 12편은 이름이 Z로 시작하는 작은 확장들(Zicsr, Zifencei, Zicntr·Zihpm, B, Zicond, Zicbom)을 묶는다. 각각은 작지만 Zicsr의 읽기·쓰기 규칙은 24편의 CSR 파일 설계로, Zifencei는 22편으로 이어진다.
실습은 QEMU 11.1.3 virt 보드(맥 M1 Max)와 riscv64-elf-gcc 16.2로 했고, mcause를 기록하고 명령어를 건너뛰는 트랩 처리기로 불법 명령어 여부도 확인했다.
1. Zicsr: CSR 명령어 6개
CSR(Control and Status Register)은 12비트 주소로 고르는 특수 레지스터다. 일반 레지스터와 달리 로드·스토어로 접근하지 않고 전용 명령어로만 읽고 쓴다. 명령어는 세 가지 동작에 레지스터판·즉시값판이 있어 6개다(SYSTEM opcode, I 형식, 즉시값 자리에 CSR 주소).
| 명령어 | 동작 (t = 옛 CSR 값) | 즉시값판 |
|---|---|---|
csrrw rd, csr, rs1 |
rd ← t, csr ← rs1 | csrrwi |
csrrs rd, csr, rs1 |
rd ← t, csr ← t | rs1 | csrrsi |
csrrc rd, csr, rs1 |
rd ← t, csr ← t & ~rs1 | csrrci |
즉시값판은 rs1 칸 5비트를 0 확장한 값(uimm, 0~31)을 쓴다. 읽기와 쓰기가 한 명령어 안에서 원자적으로 일어나므로, 인터럽트 허용 비트를 켜면서 옛 값을 받는 일을 끼어들 틈 없이 할 수 있다.
QEMU에서 mscratch(M모드용 임시 CSR)로 손으로 따라가 봤다.
| 순서 | 명령어 | rd (옛 값) | 실행 뒤 CSR |
|---|---|---|---|
| 1 | csrw 0x12345678 |
12345678 |
|
| 2 | csrrw 0xaaaa5555 |
12345678 |
aaaa5555 |
| 3 | csrrs 0x0000000f |
aaaa5555 |
aaaa555f |
| 4 | csrrc 0x0000ff00 |
aaaa555f |
aaaa005f |
| 5 | csrrsi 0x10, csrrci 0x5 |
aaaa005a |
5번에서 0x10을 켜는 것은 이미 1이던 비트라 변화가 없고, 0x5를 지워 f → a가 됐다. 자주 쓰는 의사 명령어는 이 6개로 만든다. csrr rd, csr = csrrs rd, csr, x0, csrw csr, rs = csrrw x0, csr, rs, csrs·csrc는 rd=x0인 csrrs·csrrc다.
2. x0일 때의 규칙: 설계에서 가장 중요한 표
CSR 중에는 읽기만 해도 무언가 바뀌는 것이 있고, 쓰기에도 부작용이 있다. 그래서 명세는 "읽지 않는 경우"와 "쓰지 않는 경우"를 정했다.
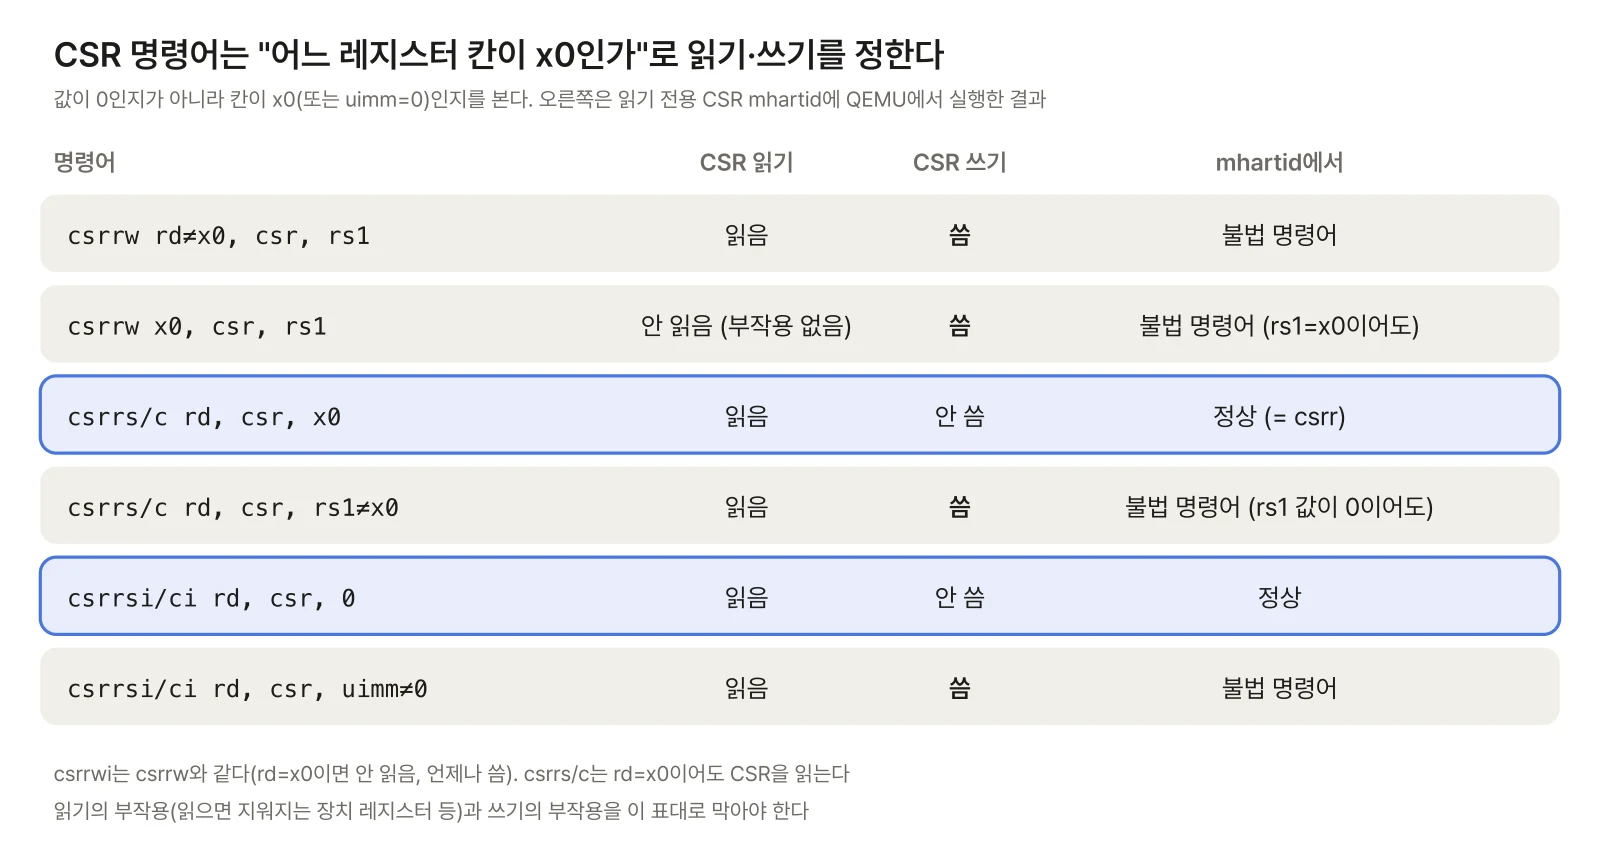
csrrw·csrrwi: rd=x0이면 CSR을 읽지 않는다. 읽기 부작용도 없다. 쓰기는 언제나 한다.csrrs·csrrc: rs1=x0이면 CSR에 쓰지 않는다. 쓰기 부작용도 없고, 읽기 전용 CSR이어도 예외가 나지 않는다. 읽기는 언제나 한다(rd=x0이어도).csrrsi·csrrci: uimm=0이면 쓰지 않는다.
핵심은 값이 아니라 칸을 본다는 점이다. rs1이 x5이고 그 값이 0이면, 비트를 하나도 바꾸지 않지만 명세상 "쓰기를 시도한" 것이다. 읽기 전용 CSR mhartid(코어 번호, 주소 0xF14)로 확인했다.
| 명령어 | QEMU 결과 |
|---|---|
csrrs rd, mhartid, x0 |
0 (정상) |
csrrs rd, mhartid, t (t=0) |
불법 명령어 (mcause=2) |
csrrsi rd, mhartid, 0 |
0 (정상) |
csrrsi rd, mhartid, 1 |
불법 명령어 |
csrrc rd, mhartid, t (t=0) |
불법 명령어 |
csrrw x0, mhartid, x0 |
불법 명령어 |
csrrwi x0, mhartid, 0 |
불법 명령어 |
둘째 줄이 흔히 틀리는 곳이다. 쓰기 여부는 디코드 단계에서 명령어 비트(rs1 칸, rd 칸)만 보고 정하므로, 레지스터 값을 읽기 전에 권한 검사를 끝낼 수 있다.
읽기 전용 여부도 주소 비트에 들어 있다. 특권 명세는 CSR 주소의 [11:10]이 11이면 읽기 전용, [9:8]이 접근에 필요한 최소 특권 수준이라고 정했다. mhartid 0xF14는 [11:10]=11(읽기 전용), [9:8]=11(M모드)이다. 없는 CSR(0x8ff)을 읽어도 불법 명령어가 났다.
WARL(Write Any, Read Legal) 필드도 하나 봤다. mtvec의 아래 2비트 MODE는 0(직접)과 1(벡터)만 정의되어 있고 2·3은 예약이다. QEMU에 0x80001003·0x80001002를 쓰니 쓰기가 통째로 무시되어 옛 값 0x80000030이 남았고, 0x80001001은 그대로 들어갔다. 예약값을 받았을 때 무엇을 남길지는 구현이 고르는 부분이다(23·24편).
실행의 부작용으로 바뀌는 CSR(예: instret)을 CSR 명령어가 읽으면 그 명령어 실행 전 값을 읽고, 쓰면 "증가 대신 쓰기"가 일어난다.
3. Zifencei: 명령어 쪽 동기화
fence.i는 이 하트(hart, 하드웨어 스레드)가 앞서 한 메모리 쓰기를 뒤의 명령어 가져오기가 보도록 보장한다. 자기 수정 코드나 JIT 컴파일러에 필요하다. 명령어 캐시가 따로 있으면 옛 코드가 남아 있을 수 있어서다. 원래 기본 ISA에 있던 것을 따로 뗀 이유는 구현 비용이 코어마다 크게 달라서다. 다른 하트에는 효과가 없다. 구현은 22편에서 다룬다(QEMU에서는 트랩 없이 실행).
4. Zicntr·Zihpm: 카운터
Zicntr은 읽기 전용 64비트 카운터 세 개를 정의한다.
| CSR (주소) | 의사 명령어 | 세는 것 |
|---|---|---|
cycle (0xC00) |
rdcycle |
클럭 사이클 |
time (0xC01) |
rdtime |
실제 시간 (고정 주파수) |
instret (0xC02) |
rdinstret |
완료(retire)된 명령어 |
Zihpm은 하드웨어 성능 카운터 hpmcounter3~hpmcounter31(0xC03~0xC1F) 29개를 더한다. 무엇을 셀지(캐시 미스, 분기 예측 실패 등)는 M모드의 mhpmevent로 고르고, 사건 종류는 구현이 정한다. 이 비특권 CSR들은 M모드 카운터(mcycle·minstret 등)의 읽기 전용 그림자이고, 하위 모드가 읽을 수 있는지는 mcounteren·scounteren이 정한다.
RV32에서는 64비트 카운터를 한 번에 읽을 수 없어서 위 32비트를 cycleh(0xC80) 같은 별도 CSR로 읽는다. 아래 절반이 넘어가는 순간을 피하려고 위-아래-위 순서로 읽고, 두 번 읽은 위 값이 같을 때까지 반복한다.
1:  rdinstreth a1        # 위
    rdinstret  a0        # 아래
    rdinstreth a2        # 위 다시
    bne a1, a2, 1b       # 그 사이 넘어갔으면 다시
QEMU에서 2,000개 명령어 루프(addi·bnez × 1000) 앞뒤로 카운터를 읽었더니 결과가 기대와 달랐다.
| 측정 | 기본 실행 | -icount shift=0 |
|---|---|---|
루프 앞뒤 instret 차이 |
16,000 | 2,004 |
루프 앞뒤 cycle 차이 |
16,000 | 2,004 |
연달아 두 번 rdinstret |
4,000 | 1 |
mcountinhibit.IR=1에서 차이 |
0 | 0 |
기본 실행에서는 연달아 두 번 읽어도 4,000이 나왔고 값이 실행마다 달랐다. QEMU가 명령어를 하나씩 세지 않고 호스트 시간에서 카운터 값을 만들기 때문으로 보인다(추정). -icount shift=0(명령어 하나 = 가상 시간 1 단위)으로 실행하자 정확히 2,004가 나왔다. 두 rdinstret 사이에 있는 rdtime·li·루프 2,000개·rdcycle과 둘째 rdinstret 자신까지 2,004개다. 연달아 읽으면 1이다. "읽는 명령어 실행 전 값"을 읽는다는 2절의 규칙과 맞는다. 이 모드에서는 cycle과 instret이 같았다. QEMU는 명령어당 1사이클로 흉내 내기 때문이다.
mcountinhibit의 IR 비트(비트 2)를 켜면 instret이 멈췄다. minstret에 0을 쓴 직후 rdinstret은 icount 모드에서 1이었다. 명세의 "증가 대신 쓰기" 규칙대로라면 쓰기 명령어 자신은 세지 않으므로 0을 예상했는데, QEMU는 1을 냈다. QEMU가 쓰기 뒤에 그 명령어의 증가를 더하는 것으로 보인다(추정, 확인하지 못함).
time은 클럭 주파수가 바뀌어도 일정하게 증가하는 벽시계로, 보통 메모리 맵 타이머 mtime을 보여 준다. 하드웨어가 직접 내주지 않고 M모드가 트랩으로 흉내 내도 된다.
5. B 확장: Zba·Zbb·Zbs
B 확장(1.0판)은 2021년 비준된 Zba·Zbb·Zbs 세 확장의 묶음이다. 컴파일러가 C 코드에서 자주 만드는 비트 연산 패턴을 한 명령어로 줄인다.
| 확장 | 명령어 | 쓰임 |
|---|---|---|
| Zba (주소) | sh1add sh2add sh3add |
배열 주소 a + i×2·4·8 |
| Zbb (기본) | andn orn xnor |
마스크 연산 |
| Zbb | clz ctz cpop |
앞·뒤 0 세기, 1 세기 |
| Zbb | min max minu maxu |
분기 없는 최소·최대 |
| Zbb | sext.b sext.h zext.h |
부호·0 확장 |
| Zbb | rol ror rori |
회전 |
| Zbb | rev8 orc.b |
바이트 뒤집기, 바이트별 0 검사 |
| Zbs (단일 비트) | bset bclr binv bext (+i) |
비트 하나 켜기·끄기·뒤집기·꺼내기 |
RV64는 32비트판(clzw·cpopw·rolw 등)과, rs1의 아래 32비트를 0 확장해 쓰는 add.uw·sh1add.uw~sh3add.uw·slli.uw가 더 있다(unsigned int 인덱스용).
손으로 두 개만 따라가 보자. orc.b는 바이트마다 0이 아니면 0xff, 0이면 0x00으로 바꾼다. 0xff00ff01에 쓰면 바이트 ff·00·ff·01이 ff·00·ff·ff가 되어 0xff00ffff다. strlen이 4바이트씩 읽으며 0 바이트를 찾을 때 쓴다. rev8은 바이트 순서를 뒤집는다(RV32에서 0xff00ff01 → 0x01ff00ff). 빅엔디언 네트워크 데이터를 읽을 때 쓴다. Zbs의 bset a0, a1, a2는 a1의 (a2 mod XLEN)번 비트를 켠다. 시프트처럼 비트 번호의 아래 5비트(RV64는 6비트)만 본다.
clz·ctz는 입력이 0일 때 XLEN을 낸다. C의 __builtin_clz(0)은 정의되지 않은 동작이라 컴파일러가 0 검사를 따로 넣는데, clz는 0일 때도 답이 정해져 있어서 x ? __builtin_clz(x) : 32가 clz 하나로 컴파일됐다(6절 표).
6. 실습: QEMU 실행을 기준 모델과 대조, 코드 크기
먼저 QEMU가 무엇을 지원하는지 확인했다. 기본 rv32 CPU에서 Zba·Zbb·Zbs 명령어와 cbo.*는 트랩 없이 실행됐지만, czero.eqz는 불법 명령어(mcause=2)였다. -cpu rv32,zicond=true를 주자 실행됐다. misa는 0x401411ad(A·C·D·F·H·I·M·S·U)였다.
시험 프로그램은 경계값(0, 1, −1, 최상위 비트 하나, 그 아래 전부 1, 0x80, 0xff00ff01)과 고정 시드 xorshift 무작위 값 5개, 모두 12개 값으로 레지스터-레지스터 명령어는 모든 쌍(144개)을, 단항·즉시값 명령어는 12개를 실행했다. 결과는 Python으로 직접 쓴 기준 모델(명령어마다 한 줄 람다)과 대조했다.
'rol':   lambda a, b: rol(a, b & sh, X),
'clz':   lambda a, _: X - a.bit_length(),
'orc.b': lambda a, _: int.from_bytes(bytes(
    0xff if x else 0 for x in a.to_bytes(X//8, 'little')),
    'little'),
'czero.eqz': lambda a, b: 0 if b == 0 else a,| 대상 | 명령어 종류 | 실행 수 | 일치 |
|---|---|---|---|
RV32 (rv32,zicond=true) |
31 | 2,772 | 2,772 |
RV64 (rv64,zicond=true) |
42 | 3,720 | 3,720 |
| Zicsr 규칙 (2절 표) | 7 | 7 (명세 기대와 같음) |
코드 크기는 11편의 시험 코드 bench.c와 1편의 kernels.c를 C 확장을 켠 상태에서 B 있이·없이 컴파일해 비교했다.
| 코드 | 명령어 수 (B 없음 → 있음) | 많이 쓰인 B 명령어 |
|---|---|---|
| bench.c RV32 | 523 → 492 | rori 10, sh2add 8 |
| bench.c RV64 | 525 → 493 | roriw 10, sh2add 6 |
| kernels.c RV32 | 167 → 144 | sh2add 11, cpop 1 |
| kernels.c RV64 | 175 → 151 | sh2add 10, cpopw 1 |
rori 10개는 SHA-256의 회전 연산(ROR 매크로)이다. B가 없으면 회전 하나가 srli·slli·or 세 명령어다. sh2add는 int32 배열 접근이고, cpop은 1편의 popcount_sum이 라이브러리 함수 호출 대신 명령어 하나가 된 것이다.
함수 하나씩 보면 차이가 더 분명하다(RV32, -O2).
| C 코드 | B·Zicond 없음 | 있음 |
|---|---|---|
p[i] (uint32) |
slli+add+lw |
sh2add+lw |
x ? clz(x) : 32 |
분기 + 라이브러리 호출 | clz |
x & ~(1u << n) |
li+sll+not+and |
bclr |
bswap32(x) |
라이브러리 호출 | rev8 |
c ? a : 0 |
beqz+mv |
czero.eqz |
c ? a : b |
beqz+mv+mv |
czero.nez+czero.eqz+add |
7. Zicond: 분기 없는 선택
Zicond(1.0판)은 명령어 두 개뿐이다.
czero.eqz rd, rs1, rs2: rs2가 0이면 rd ← 0, 아니면 rd ← rs1.czero.nez rd, rs1, rs2: rs2가 0이 아니면 rd ← 0, 아니면 rd ← rs1.
"조건이 거짓이면 0"만 할 수 있지만, 둘을 합치면 일반적인 선택이 된다. c ? a : b는 czero.eqz t0, a, c(c가 참이면 a, 아니면 0)와 czero.nez t1, b, c(c가 거짓이면 b, 아니면 0)의 합이다. 둘 중 하나는 반드시 0이므로 add나 or로 합치면 된다. GCC도 위 표처럼 정확히 이 세 명령어를 냈다.
왜 x86의 cmov처럼 "rd ← c ? a : b"를 한 명령어로 만들지 않았을까. 그러려면 레지스터를 세 개 읽어야 한다(c, a, b). RISC-V 정수 명령어는 원본 레지스터가 최대 두 개라서, 레지스터 파일 읽기 포트를 늘리지 않으려고 두 개짜리 명령어 둘로 나눴다. 하드웨어는 ALU 출력에 "0 또는 rs1" 선택기 하나만 더하면 된다.
데이터에 따라 무작위로 갈리는 분기는 예측이 자주 틀리므로, 명령어 두세 개를 언제나 실행하는 쪽이 빠를 수 있다.
8. Zicbom: 캐시 블록 관리
CMO(Cache Management Operation) 확장 중 Zicbom은 캐시 블록 단위로 데이터를 정리하는 명령어 세 개를 정의한다. 주소는 rs1 하나로 주고, 그 주소가 속한 캐시 블록 전체에 적용된다.
| 명령어 | 동작 | 쓰임 |
|---|---|---|
cbo.clean |
바뀐 데이터를 메모리에 써 둔다(캐시엔 남김) | DMA가 메모리를 읽기 전 |
cbo.flush |
써 두고 캐시에서 뺀다 | 공유 버퍼를 넘길 때 |
cbo.inval |
쓰지 않고 캐시에서 뺀다 | DMA가 메모리에 쓴 뒤 |
캐시 일관성을 하드웨어가 지키지 않는 DMA 같은 장치와 데이터를 주고받을 때 필요하다. cbo.inval은 아직 쓰지 않은 데이터를 버릴 수 있어서, M모드가 아닌 모드에서는 menvcfg·senvcfg의 CBIE 필드로 허용 여부를 정하고, 허용하지 않으면 불법 명령어, 또는 cbo.flush처럼 동작하게 할 수 있다. 블록 크기는 ISA가 정하지 않고 장치 트리 같은 바깥 정보로 알려 준다. QEMU에서는 세 명령어 모두 트랩 없이 실행됐다(캐시가 없는 에뮬레이터라 효과는 볼 수 없다).
9. 설계 체크리스트: 작은 확장들
| 항목 | 규칙 |
|---|---|
| CSR 읽기 여부 | csrrw(i)는 rd=x0이면 안 읽음. csrrs/c(i)는 언제나 읽음 |
| CSR 쓰기 여부 | csrrs/c는 rs1 칸=x0, csrrs/ci는 uimm=0이면 안 씀. 레지스터 값으로 판단하지 않는다 |
| 읽기 전용 CSR | 주소 [11:10]=11. 쓰기 시도면 불법 명령어. 쓰지 않는 읽기는 정상 |
| 권한 | 주소 [9:8] < 현재 모드면 불법 명령어. 없는 CSR도 불법 |
| WARL | 예약값을 쓰면 무엇을 남길지 구현 선택(QEMU mtvec: 쓰기 무시) |
instret 쓰기 |
쓰는 명령어는 증가 대신 쓰기. 읽는 명령어는 실행 전 값 |
| RV32 카운터 | 위 32비트는 …h CSR. 소프트웨어는 위-아래-위로 읽는다 |
time |
고정 주파수. CSR로 안 내주고 트랩으로 흉내 내도 된다 |
fence.i |
이 하트의 앞선 쓰기를 뒤의 명령어 가져오기가 보게. 다른 하트에는 효과 없음 |
| B 시프트 양 | rol·ror·bset 등은 rs2의 아래 log2(XLEN)비트만 |
clz·ctz |
입력 0이면 XLEN(clzw·ctzw는 32) |
rev8·orc.b |
XLEN 전체에 바이트 단위로. rev8은 RV32·RV64 인코딩이 다르다 |
| Zicond | 원본 레지스터 2개. ALU 출력에 "0 또는 rs1" 선택기 |
cbo.inval |
하위 모드는 menvcfg·senvcfg의 CBIE로 허용·불법·flush 처리 |
정리
- Zicsr의 6개 명령어는 rd·rs1 칸이
x0인지로 읽기·쓰기를 정한다. QEMU에서 값이 0인 레지스터로csrrs를 해도 읽기 전용 CSR에서는 불법 명령어가 났다. - 카운터
cycle·time·instret은 읽기 전용 그림자 CSR이고, RV32는 위 절반을 따로 읽는다. QEMU는-icount없이는 명령어 수를 정확히 세지 않았고,-icount shift=0에서 2,004개 루프가 정확히 2,004로 나왔다. - B 확장 명령어를 RV32 2,772개, RV64 3,720개 조합으로 실행해 기준 모델과 모두 일치했다. 같은 코드가 6.6~9.0% 작아졌고, 회전·배열 주소·비트 세기가 주로 줄었다.
- Zicond는 원본 레지스터 두 개 규칙을 지키며 분기 없는 선택을 세 명령어로 만들고, Zicbom은 일관성이 없는 장치와 데이터를 주고받기 위한 캐시 블록 명령어다.
다음 글: 13편부터는 벡터 확장이다. V 확장의 레지스터 길이 VLEN, 원소 크기 SEW, 레지스터 묶음 LMUL이 무엇이고, vsetvli로 한 번에 처리할 원소 수를 정하는 방식이 어떻게 벡터 길이에 묶이지 않는 코드를 만드는지 본다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 6장 Zifencei, 7장 Zicsr(7.1 CSR 명령어), 8장 카운터(Zicntr·Zihpm), 12장 Zicond, 19장 CMO(Zicbom), 28장 B 확장(Zba·Zbb·Zbs). https://github.com/riscv/riscv-isa-manual
- The RISC-V Instruction Set Manual, Volume II: Privileged Architecture, Version 20240411. 2.1 CSR 주소 규칙, 3.1.7
mtvec, 3.1.10~3.1.12 카운터·mcounteren·mcountinhibit,menvcfg의 CBIE. - RISC-V Bit-Manipulation ISA-extensions, Version 1.0.0, 2021. https://github.com/riscv/riscv-bitmanip
- D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 2장(CSR 명령어), 10장(특권 구조)
- QEMU 문서:
-icount. https://www.qemu.org/docs/master/system/qemu-manpages.html