이 글의 핵심 3줄
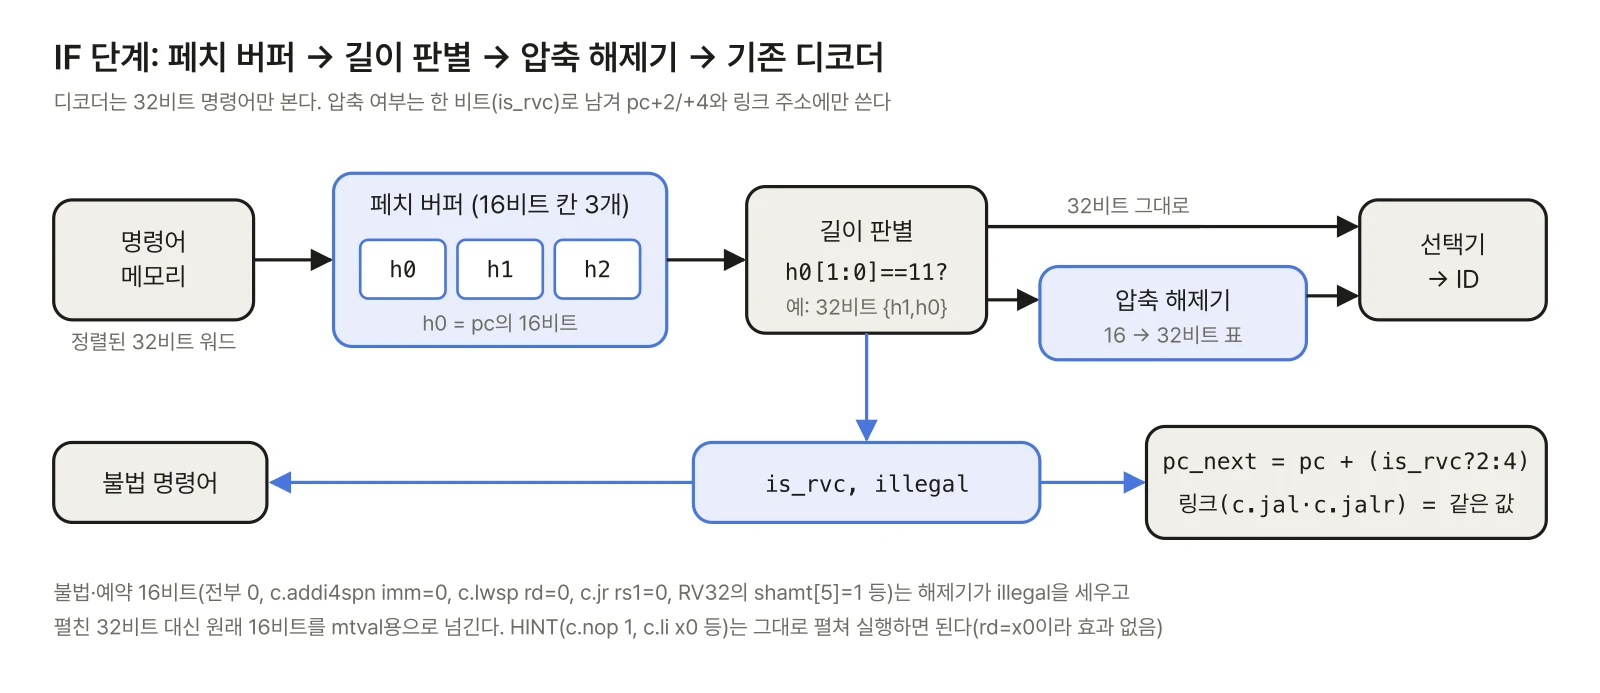
- C 확장은 IF 단계에 페치 버퍼와 압축 해제기를 더하면 끝난다. 16비트 명령어 하나는 언제나 32비트 명령어 하나로 펼쳐지므로 디코더와 실행부는 그대로 두고, 압축 여부 한 비트로 pc+2/+4와 링크 주소만 바꾼다.
- Python 압축 해제기로 16비트 값 49,152개를 전부 펼쳐 GNU objdump와 대조했다. 정상·HINT 28,823개는 모두 같은 뜻이었고, 다른 1,537개는 RV32에서 예약된 인코딩(시프트 양 bit 5 = 1 등)을 objdump가 그냥 해석해 보여 준 경우였다.
- 실제 rv32imc 프로그램을 실행하면 명령어의 36.7%가 두 32비트 워드에 걸친 32비트 명령어였고, 분기 목적지의 96.5%가 4바이트 경계 + 2에 있었다. 16비트 칸 3개짜리 페치 버퍼는 버퍼 없이 매번 다시 읽는 방식보다 워드 읽기를 33,771번에서 23,903번으로 줄였다.
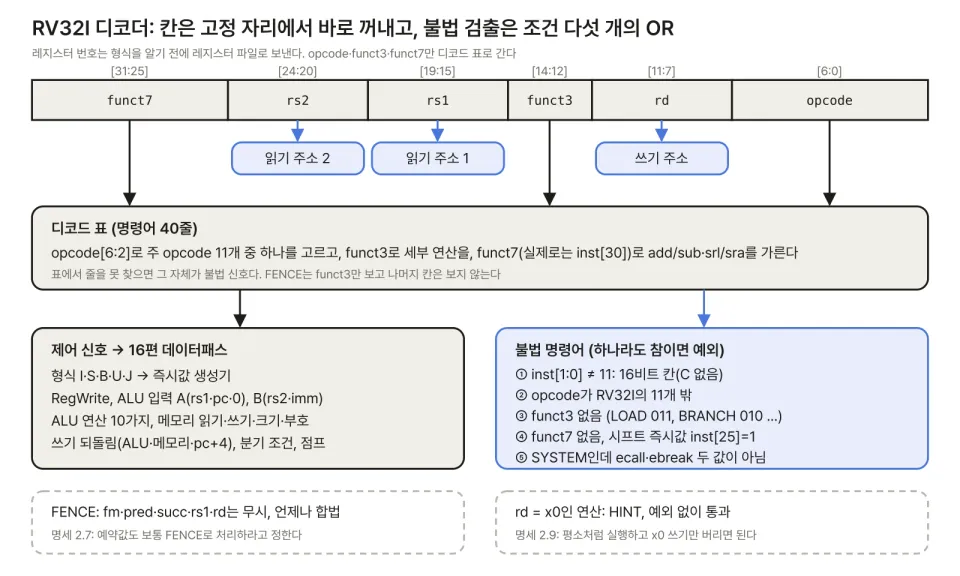
19·20편에서 RV32I 5단 파이프라인 코어에 M과 A를 붙였다. 둘 다 실행 쪽(EX·MEM) 이야기였다. C 확장은 반대로 앞쪽(IF)만 바뀐다. 명령어 형식은 11편에서 봤으니, 이번에는 16비트와 32비트가 섞인 명령어 흐름을 32비트 워드 단위 메모리에서 어떻게 꺼내는지, 16비트를 32비트로 어떻게 펼치는지, 그리고 어떤 16비트 값을 불법으로 처리해야 하는지를 Python 모델로 만들고 GNU objdump·QEMU 실행 기록과 대조한다.
1. C 확장이 코어에 요구하는 것
C 확장이 생기면 32비트 명령어가 4바이트 경계가 아니라 2바이트 경계 어디서나 시작할 수 있다(IALIGN = 16, 비특권 명세 26.1절). 명세가 정한 큰 원칙은 하나다. 모든 압축 명령어는 기본 ISA(또는 F·D)의 32비트 명령어 하나로 펼쳐진다. 명세는 그 이점으로 "하드웨어가 디코드 단계에서 그냥 펼치면 된다"는 점을 직접 든다.
| 바뀌는 곳 | 무엇을 | 왜 |
|---|---|---|
| 페치 | 16비트 단위로 다음 명령어를 꺼냄 | 32비트 명령어가 두 워드에 걸칠 수 있음 |
| 길이 판별 | 첫 16비트의 [1:0]이 11이면 32비트 |
아래 두 비트 00·01·10이 압축 사분면 |
| 압축 해제기 | 16비트 → 32비트 표 | 디코더를 그대로 쓰려고 |
| pc 갱신 | pc + 2 또는 + 4 | 명령어 길이가 둘 |
| 링크 주소 | c.jal·c.jalr은 pc + 2 |
명세가 일부러 적어 둔 예외 |
| 분기 목적지 | 2바이트 정렬이면 정상 | 정렬 예외 조건이 사라짐 |
마지막 줄은 놓치기 쉽다. C가 있으면 분기·점프 목적지가 2의 배수이기만 하면 되고, 명세는 "C 확장이 있으면 어떤 명령어도 명령어 주소 정렬 예외를 내지 않는다"고 적는다. jalr은 목적지의 bit 0을 원래 0으로 지우므로 남는 경우가 없다.
2. 압축 해제기: 16비트를 32비트로
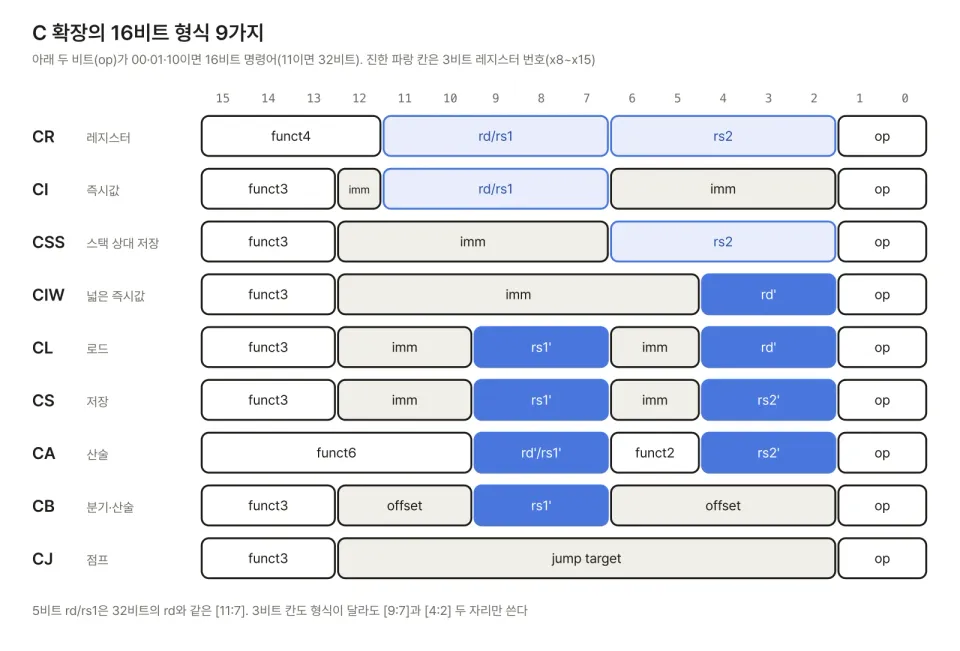
압축 해제기는 순수 조합 회로다. 사분면(op = [1:0])과 funct3([15:13])로 명령어를 고르고, 흩어진 즉시값 비트를 모아 32비트 형식에 다시 놓는다. 3비트 레지스터 칸(rd′·rs1′·rs2′)은 앞에 01을 붙여 x8~x15로 만든다.
실행한 프로그램의 CRC 루프 끝에 있는 0xf77d를 손으로 펼쳐 보자.
| 칸 | 비트 | 값 | 뜻 |
|---|---|---|---|
| op | [1:0] | 01 |
사분면 1 |
| funct3 | [15:13] | 111 |
c.bnez |
| rs1′ | [9:7] | 110 |
x8 + 6 = x14 (a4) |
| offset | [12], [6:5], [2], [11:10], [4:3] | 1, 11, 1, 01, 11 | offset[8], [7:6], [5], [4:3], [2:1] |
offset 비트를 높은 자리부터 늘어놓으면 1_1110_1110, 9비트 부호 있는 값으로 −18이다. 펼친 결과는 bne a4, x0, -18, 기계어 0xfe0717e3이고, 0x80000170에서 −18이면 objdump가 보여 준 목적지 0x8000015e와 같다. 펼친 32비트 명령어의 오프셋도 압축 명령어 자신의 pc 기준이라는 점이 중요하다. pc는 바뀌지 않으므로 분기 주소 계산 회로는 그대로 쓴다.
몇 가지를 더 펼쳐 보면 패턴이 보인다.
| 16비트 | 이름 | 펼친 32비트 |
|---|---|---|
0x4505 |
c.li a0,1 |
addi a0,x0,1 |
0x177d |
c.addi a4,-1 |
addi a4,a4,-1 |
0x8fb9 |
c.xor a5,a4 |
xor a5,a5,a4 |
0x6105 |
c.addi16sp 32 |
addi sp,sp,32 |
0x8082 |
c.jr ra |
jalr x0,0(ra) |
c.jalr만 정확히 대응하지 않는다. 펼치면 jalr x1, 0(rs1)이지만 링크 값은 pc + 4가 아니라 pc + 2다. 명세도 이 점을 짚고 "2와 4 두 오프셋을 지원하는 것은 작은 변경"이라고 한다. 구현에서는 해제기가 내보내는 is_rvc 비트를 링크 주소 덧셈기의 선택 신호로 쓰면 된다. c.jal도 같다.
3. 불법 압축 명령어와 HINT
16비트 공간 중 아래 두 비트가 11이 아닌 값은 49,152개다. 이 중 RV32C(F·D 없음)에서 정상 명령어는 일부뿐이다. 해제기는 나머지에 illegal을 세워야 한다. 모델이 분류한 결과다.
| 분류 | 개수 | 예 |
|---|---|---|
| 정상 | 28,460 | c.lw, c.addi, c.j … |
| HINT (실행해도 효과 없음) | 363 | c.nop 1, c.li x0,5, c.mv x0,ra |
| 불법·예약 | 20,329 | 아래 표 |
불법·예약에는 성격이 다른 것들이 섞여 있다. 하나씩 해제기 조건이 된다.
| 인코딩 | 이유 |
|---|---|
0x0000 (전부 0) |
명세가 정한 불법 명령어(26.5.4절) |
c.addi4spn imm = 0, c.addi16sp imm = 0, c.lui imm = 0 |
예약 |
c.lwsp rd = 0, c.jr rs1 = 0 |
예약 |
c.slli·c.srli·c.srai의 shamt[5] = 1 |
RV32C에서는 커스텀 확장용 |
c.flw·c.fsw·c.fld·c.fsd와 그 sp 버전 |
F·D가 없으면 불법 |
사분면 0 funct3 = 100, 사분면 1의 c.subw·c.addw 자리 |
예약(또는 RV64·Zcb 몫) |
HINT는 "rd = x0이라 효과가 없는" 인코딩이다. 해제기는 이것을 그대로 32비트로 펼치면 된다. c.li x0, 5는 addi x0, x0, 5가 되고, x0 쓰기는 버려지니 저절로 아무 일도 안 한다. 따로 처리할 필요가 없다.
모델의 결과를 objdump와 대조했다. 49,152개 모두를 .insn으로 4바이트 간격에 놓고 어셈블해 objdump가 읽은 줄과, 내 해제기가 펼친 32비트를 같은 주소에 놓고 읽은 줄을 비교했다. mv가 addi rd,rs,0과 add rd,x0,rs 둘 다를 뜻하는 것 같은 별칭 차이는 같은 뜻으로 맞췄다.
| 대조 결과 | 개수 |
|---|---|
| 정상·HINT, 같은 뜻 | 28,823 |
| 둘 다 불법 | 18,792 |
| 내 해제기는 불법, objdump는 해석 | 1,537 |
| 그 밖의 차이 | 0 |
1,537개는 c.slli shamt[5] = 1(1,024개), c.srli·c.srai shamt[5] = 1(512개), c.addi16sp imm = 0(1개)이다. objdump는 이것들을 c.slli zero,0x20, srli s0,s0,0x20, addi sp,sp,0처럼 그냥 보여 줬다. 역어셈블러는 보여 주기 위한 도구라 너그럽게 읽는다. 하드웨어 해제기는 명세대로 불법 처리해야 한다. 커스텀 확장이 없는 코어에서 RV32의 shamt[5] = 1을 시프트 32로 실행하는 것은 흔한 버그다.
4. 페치 버퍼: 워드에 걸친 명령어 꺼내기
명령어 메모리(또는 캐시)는 정렬된 32비트 워드를 준다. 그런데 명령어는 2바이트 경계에서 시작하니, 32비트 명령어의 아래 절반은 한 워드의 위쪽에, 위 절반은 다음 워드의 아래쪽에 있을 수 있다. 경우는 셋이다.
| pc mod 4 | 명령어 | 필요한 워드 |
|---|---|---|
| 0 | 16비트 또는 32비트 | 1개 |
| 2 | 16비트 | 1개(위 절반) |
| 2 | 32비트 | 2개(이 워드의 위 절반 + 다음 워드의 아래 절반) |
가장 단순한 방법은 매 명령어마다 필요한 워드를 다시 읽는 것이다. 걸친 명령어는 두 번 읽는다. 대신 쓰고 남은 16비트를 보관하는 작은 버퍼를 두면, 순서대로 실행하는 동안에는 한 워드를 한 번만 읽는다. 모델의 버퍼는 16비트 칸 3개다. 앞 칸의 [1:0]으로 길이를 보고, 필요한 칸이 다 찼으면 명령어를 내보낸다. 칸이 2개 이상 비면 다음 워드를 읽어 채운다.
def ready(self):
    if not self.q: return 0
    n = 1 if self.q[0][1] & 3 != 3 else 2   # 16비트 칸 수
    return n if len(self.q) >= n else 0

def redirect(self, pc):
    self.q = []; self.fetch_addr = pc & ~3
    self.skip = pc & 2   # 목적지가 +2면 첫 워드 아래 절반 버림
분기·점프로 pc가 바뀌면 버퍼를 비우고 목적지가 든 워드부터 다시 읽는다. 목적지가 4바이트 경계 + 2에 있으면 첫 워드의 아래 절반은 버린다. 이때 목적지 명령어가 32비트라면 첫 워드만으로는 모자라서 한 번 더 읽어야 한다. 페치에 한 사이클 거품이 더 생긴다.
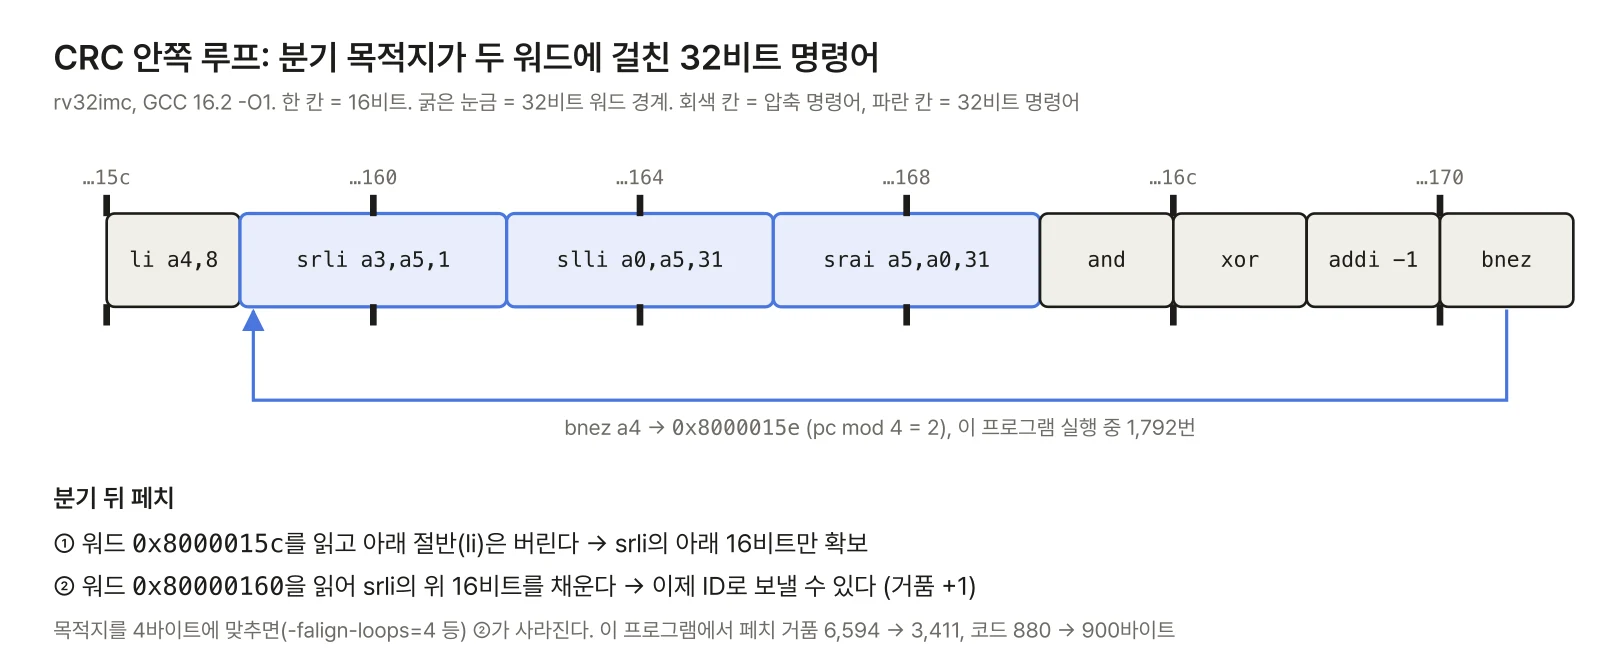
실제 프로그램에서 이 경우가 얼마나 자주 나오는지 쟀다. 정렬·CRC32·문자열 뒤집기·행렬곱을 섞은 C 프로그램(prog.c)을 -march=rv32imc -O1로 빌드했다. .text는 880바이트로, 같은 프로그램의 rv32im 빌드(1,144바이트)보다 23% 작았다.
5. 실습 1: 정적 명령어 스트림을 objdump와 대조
먼저 .text 전체를 페치 버퍼로 처음부터 순서대로 꺼냈다. 꺼낸 명령어마다 주소, 비트, 길이를 riscv64-elf-objdump -d의 줄과 비교하고, 압축 명령어는 내가 펼친 32비트를 다시 objdump로 읽어 원래 줄과 같은 뜻인지 확인했다.
| 항목 | 결과 |
|---|---|
| 꺼낸 명령어 / objdump 명령어 | 286 / 286 |
| 주소 순서 일치 | 예 |
| 주소·비트·길이 일치 | 286 / 286 |
| 압축 명령어 펼침이 같은 뜻 | 132 / 132 |
| 압축 비율 | 46.2% |
| 32비트 명령어 중 두 워드에 걸침 | 67 / 154 (43.5%) |
32비트 명령어의 거의 절반이 걸쳐 있다. 압축 명령어가 하나 끼면 그 뒤 32비트 명령어들은 2바이트 어긋나니 당연한 결과다. 이 프로그램에서 압축 비율 46.2%는 명세가 "보통 50~60%"라고 한 범위보다 약간 낮다.
6. 실습 2: 실행 순서로 페치 횟수 재기
다음은 실제 실행 순서다. QEMU를 명령어 하나당 변환 블록 하나로 돌리고(-accel tcg,one-insn-per-tb=on -d exec,nochain), 실행된 pc를 차례로 기록했다. 기록 끝의 제자리 루프(j 1b, QEMU가 멈출 때까지 도는 횟수가 매번 달랐다)는 잘라 냈다. 이 pc 순서를 페치 버퍼 모델에 넣으면, 다음 pc가 pc + 길이가 아닐 때를 분기로 보고 버퍼를 비운다. 모델이 꺼낸 명령어의 주소가 매번 QEMU의 pc와 같은지 확인하면서 돌렸다.
| 항목 (rv32imc, -O1) | 값 |
|---|---|
| 실행한 명령어 | 24,713 |
| 압축 명령어 비율 | 55.6% |
| 두 워드에 걸친 32비트 명령어 | 9,058 (전체의 36.7%) |
| pc 흐름이 바뀐 횟수 | 3,409 |
| 그중 목적지가 4바이트 경계 + 2 | 3,291 (96.5%) |
| 그중 목적지가 걸친 32비트 명령어 | 3,184 |
목적지가 거의 다 +2 자리에 있는 것은 이 프로그램의 사정이다. 가장 자주 뛰는 목적지 둘이 CRC 안쪽 루프(1,792번)와 정렬 안쪽 루프(1,059번)인데, 둘 다 우연히 +2 자리에 있는 32비트 명령어로 시작했다. 그래서 GCC의 정렬 옵션(-falign-loops=4 -falign-jumps=4 -falign-labels=4)으로 다시 빌드해 같은 측정을 했다.
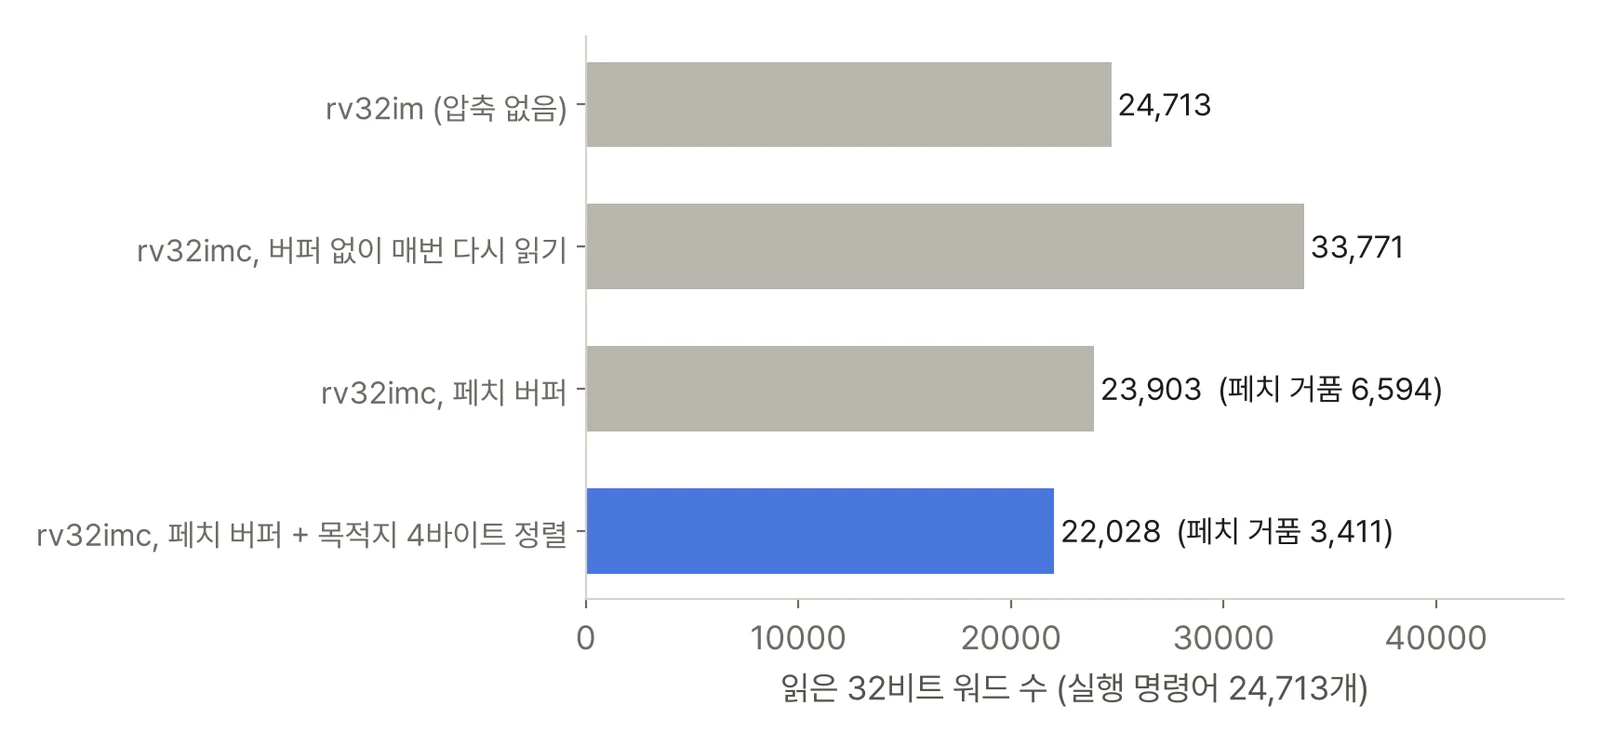
| 구성 | 읽은 워드 | 페치 거품 |
|---|---|---|
| rv32im (압축 없음) | 24,713 | |
| rv32imc, 매번 다시 읽기 | 33,771 | |
| rv32imc, 페치 버퍼 | 23,903 | 6,594 |
| rv32imc, 페치 버퍼 + 목적지 정렬 | 22,028 | 3,411 |
페치 거품은 분기 뒤 첫 명령어가 다 모일 때까지 기다린 사이클이다. 분기마다 최소 1번(목적지 워드 읽기)이고, 목적지가 걸친 32비트 명령어면 1번 더다. 3,409 + 3,184 + 처음 1번 = 6,594로 맞는다. 목적지를 정렬하자 걸친 목적지가 1번으로 줄어 거품이 3,411번이 됐고, 대가로 코드가 880바이트에서 900바이트로, 실행 명령어가 24,738개로 조금 늘었다(정렬용 nop을 지나가는 경우).
rv32im과 rv32imc의 실행 명령어 수가 24,713개로 같다는 점도 눈여겨볼 만하다. 압축은 명령어를 바꾸지 않고 크기만 줄인다. 그런데 버퍼 없이 매번 다시 읽으면 오히려 압축 없는 코드보다 37% 더 읽는다. C 확장으로 명령어 메모리 대역폭을 아끼려면 페치 버퍼가 필수다.
장비는 맥 M1 Max, GCC·binutils는 riscv64-elf 16.2와 2.47, QEMU 11.1.3이다. 모델 전체(16비트 전부 대조 포함) 실행에 약 1초 걸렸다.
7. 설계 체크리스트: C 확장
| 항목 | 규칙 |
|---|---|
| 길이 판별 | 첫 16비트 [1:0] = 11이면 32비트. 48비트 이상 인코딩은 표준에 아직 없음 |
| 레지스터 칸 | rd′·rs1′·rs2′ = x8~x15 (01 붙이기) |
| 즉시값 | 명령어마다 비트 배치가 다르다. 부호 확장 여부도(예: c.lw 오프셋은 0 확장, c.addi는 부호 확장) |
| 링크 주소 | c.jal·c.jalr은 pc + 2 |
| 다음 pc | pc + 2 / pc + 4. 분기 오프셋은 압축 명령어 자신의 pc 기준 |
| 정렬 예외 | C가 있으면 명령어 주소 정렬 예외 없음. misa.C를 끌 수 있게 만들면 그때의 규칙은 특권 명세를 따름 |
| 불법 | 0x0000, imm = 0 예약 3종, c.lwsp·c.jr x0, RV32 shamt[5] = 1, F·D 없을 때 FP 로드·스토어 |
| HINT | 그대로 펼쳐 실행(rd = x0이라 효과 없음) |
| mtval | 불법 명령어 트랩에 명령어 비트를 쓴다면 펼친 32비트가 아니라 원래 16비트 |
| 페치 버퍼 | 남은 16비트를 보관. 분기 시 비우고, 목적지 +2면 아래 절반 버림 |
| 두 워드 걸침 | 둘째 워드가 캐시 줄·페이지 경계를 넘을 수 있다. 둘째 워드의 페치 폴트도 이 명령어의 폴트 |
| LR/SC 루프 | 압축 명령어도 제약 LR/SC 루프 규칙의 "기본 I 명령어"로 친다(26.6절) |
마지막 두 줄 중 페이지 경계 문제는 가상 메모리를 다루는 30편 이후에 다시 나온다. 걸친 명령어의 위 절반이 다음 페이지에 있고 그 페이지가 없으면, 폴트 주소(mtval)는 명령어 시작 주소가 아니라 실제로 실패한 부분을 가리킬 수 있다(특권 명세가 허용하는 범위, 그 편에서 확인).
정리
- C 확장 구현은 IF 단계의 페치 버퍼, 길이 판별, 압축 해제기가 전부다. 디코더와 실행부는 그대로 두고
is_rvc한 비트로 pc+2/+4와c.jal·c.jalr의 링크 주소를 고른다. - 16비트 49,152개를 전부 펼쳐 objdump와 대조했다. 정상·HINT 28,823개가 같은 뜻이었고, objdump가 해석한 1,537개는 RV32C에서 예약된 인코딩이라 하드웨어는 불법으로 처리해야 한다.
- 실제 프로그램에서 실행 명령어의 36.7%가 두 워드에 걸친 32비트 명령어였다. 16비트 칸 3개짜리 페치 버퍼가 워드 읽기를 33,771번에서 23,903번으로 줄여 압축 없는 코드(24,713번)보다 적게 만들었다.
- 분기 목적지가 +2 자리의 32비트 명령어면 페치 거품이 하나 더 생긴다. 이 프로그램에서는 목적지 정렬로 거품이 6,594번에서 3,411번으로 줄고 코드는 20바이트 늘었다.
다음 글: 22편에서는 명령어 쪽의 마지막 문제, FENCE.I와 자기 수정 코드를 다룬다. 명령어 캐시와 데이터 캐시가 나뉜 코어에서 방금 쓴 코드가 왜 안 보이는지, FENCE.I가 무엇을 보장하고 무엇을 보장하지 않는지(같은 하트만), 캐시가 없는 단순한 코어에서도 이번 편의 페치 버퍼를 왜 비워야 하는지를 QEMU와 Python 모델로 확인한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 26장 "C" 확장(26.1 개요, 26.2 형식, 26.4 제어 이동, 26.5 정수 연산과 26.5.4 정의된 불법 명령어, 26.6 LR/SC 순서, 26.7 HINT, 26.8 명령어 표). https://github.com/riscv/riscv-isa-manual
- D. Harris 외, RISC-V System-on-Chip Design, 2023. 압축 명령어 해제기와 페치 구현(CORE-V Wally)
- D. Patterson, A. Waterman, The RISC-V Reader, 2017. 7장 RV32C
- A. Waterman, "Improving Energy Efficiency and Reducing Code Size with RISC-V Compressed", UC Berkeley 석사 논문, 2011
- QEMU 로그 옵션(
-d exec,one-insn-per-tb). https://www.qemu.org/docs/master/devel/tcg.html