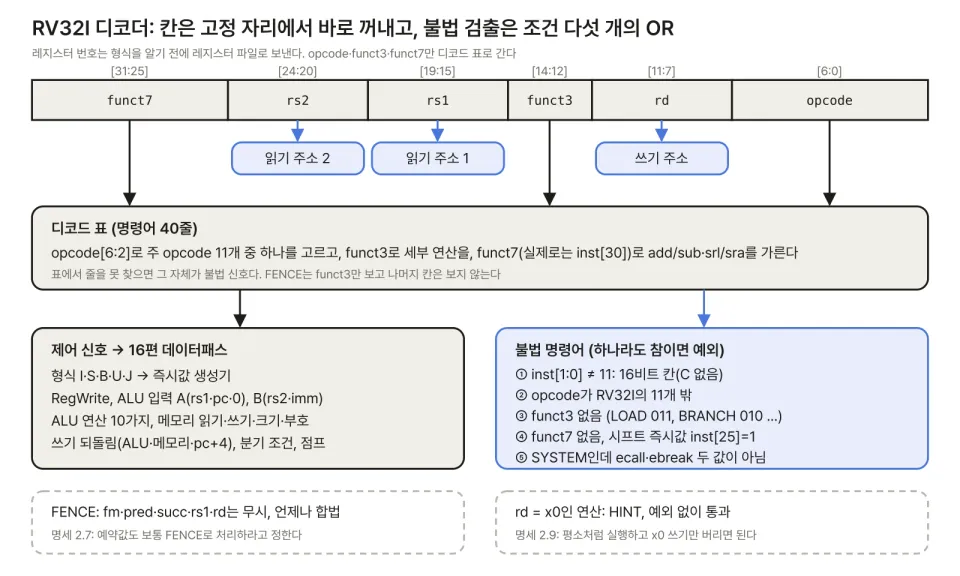
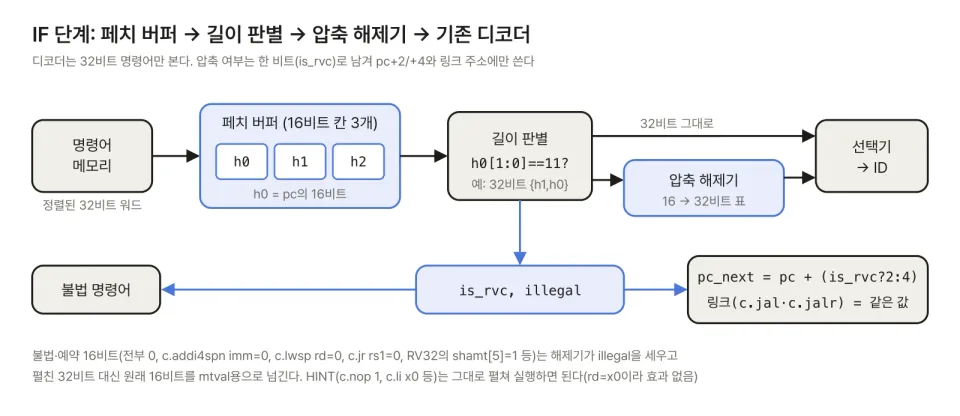
이 글의 핵심 3줄
- C 확장의 16비트 명령어는 새 연산이 아니라 자주 쓰는 32비트 명령어의 줄임말이다. 하나하나가 정확히 한 개의 32비트 명령어로 펼쳐지므로, 하드웨어는 디코더 앞에 압축 해제기만 두면 나머지 파이프라인을 그대로 쓴다.
- 16비트에 담으려고 레지스터 칸을 3비트(
x8~x15)로 줄이고 즉시값 범위를 좁혔다. C 없이 컴파일한 코드에서 레지스터 이름의 57.3%가 이 8개였다. - Python으로 압축 해제기를 짜서 16비트 값 49,152개 전부를 GNU objdump와 대조했다. RV64는 1개, RV32는 1,537개만 달랐고, 모두 명세가 예약·사용자 정의로 둔 인코딩을 objdump가 너그럽게 풀어 준 경우였다. 실제 코드에서는 명령어의 51~69%가 16비트가 되어 코드가 26~34% 줄었다.
지금까지 본 RV32I·RV64I와 M·A·F·D 확장의 명령어는 모두 32비트였다. 11편은 이 명령어 중 자주 쓰는 것을 16비트로 줄인 C 확장(압축 명령어, 2.0판)을 다룬다. 1편의 코드 크기 실험에서 rv32im → rv32imc로 가장 크게 줄어든 그 확장이다. 이번 글은 ISA 쪽, 즉 16비트 형식과 32비트 명령어 대응, 예약 인코딩, 실제 압축률을 다룬다. 압축 해제기를 하드웨어로 만들고 16비트 경계에서 명령어를 가져오는 문제는 21편에서 다룬다.
1. C 확장의 약속: 줄임말일 뿐이다
C 확장의 설계 원칙은 하나다. 모든 16비트 명령어는 정확히 하나의 32비트 명령어로 펼쳐진다. 압축 명령어만의 새 동작은 없다. 그래서 압축 해제기는 순수한 조합 회로이고, 펼친 뒤에는 기존 디코더·ALU·예외 처리가 그대로 동작한다. 컴파일러와 어셈블러도 32비트로 코드를 만든 뒤, 조건이 맞는 명령어를 16비트로 바꾸기만 하면 된다.
두 길이를 가르는 것은 아래 두 비트다. 11이면 32비트, 00·01·10이면 16비트다. 이 세 값을 사분면(quadrant) 0·1·2라 부른다. 2편에서 32비트 opcode의 아래 두 비트가 언제나 11이었던 이유가 이것이다.
C가 있으면 명령어 정렬 조건도 4바이트에서 2바이트로 바뀐다. 32비트 명령어가 2바이트 경계에서 시작해 4바이트 경계를 넘을 수 있다. 분기·점프 목표가 2의 배수이기만 하면 되므로, C가 없는 코어에서 나던 명령어 주소 정렬 예외가 C가 있는 코어에서는 나지 않는다.
2. 16비트 형식 9가지
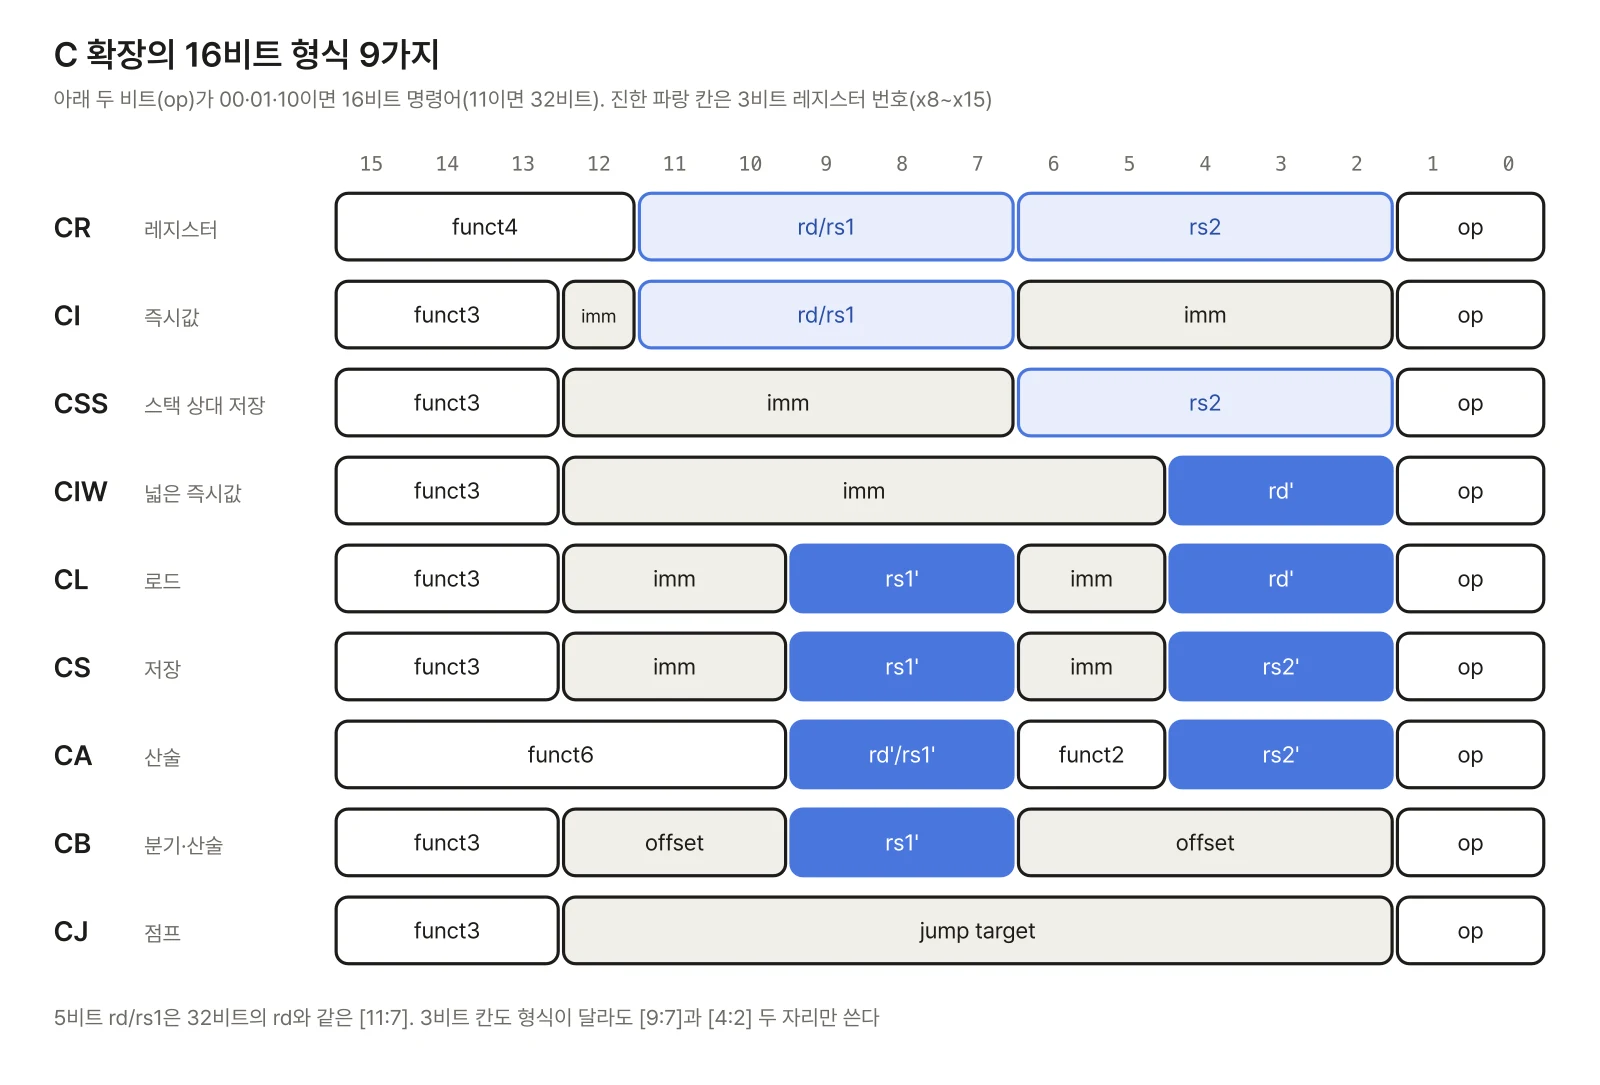
32비트 형식이 6가지였던 데 비해 16비트 형식은 9가지다. 칸이 좁아서 명령어 묶음마다 꼭 필요한 칸만 남겼기 때문이다.
| 형식 | 레지스터 | 대표 명령어 |
|---|---|---|
| CR | rd/rs1, rs2 (5비트) | c.mv c.add c.jr c.jalr |
| CI | rd/rs1 (5비트) + 6비트 즉시값 | c.li c.addi c.lui c.slli c.lwsp |
| CSS | rs2 (5비트) + 6비트 즉시값 | c.swsp c.sdsp |
| CIW | rd' (3비트) + 8비트 즉시값 | c.addi4spn |
| CL·CS | rs1', rd'/rs2' (3비트) + 5비트 즉시값 | c.lw c.sw c.ld c.sd |
| CA | rd'/rs1', rs2' (3비트) | c.sub c.xor c.or c.and |
| CB | rs1' (3비트) + 8비트 오프셋 | c.beqz c.bnez c.srli c.andi |
| CJ | 없음 + 11비트 오프셋 | c.j c.jal |
32비트 형식에서 지킨 원칙이 여기서도 보인다. 5비트 rd/rs1은 32비트의 rd와 같은 [11:7]에 있고, 3비트 칸도 형식과 상관없이 [9:7]과 [4:2] 두 자리에만 나온다. 압축 해제기가 형식을 판별하기 전에 레지스터 번호를 뽑아 둘 수 있다.
3. 3비트 레지스터 칸은 왜 x8~x15인가
16비트에 레지스터 번호 두 개(5비트씩)와 opcode, 즉시값을 다 넣기는 어렵다. 그래서 CIW·CL·CS·CA·CB 형식은 레지스터 칸을 3비트로 줄였다. 3비트로는 8개만 고를 수 있고, 명세는 그 8개를 x8~x15로 정했다. 3비트 값 r'은 레지스터 번호 8 + r'로 읽는다.
왜 하필 이 8개일까. ABI 이름으로 바꾸면 s0·s1·a0~a5다. 함수 인자와 반환값(a0~a5), 가장 먼저 쓰는 보존 레지스터(s0·s1)라 컴파일된 코드에서 가장 많이 나온다. 실제로 세어 봤다.
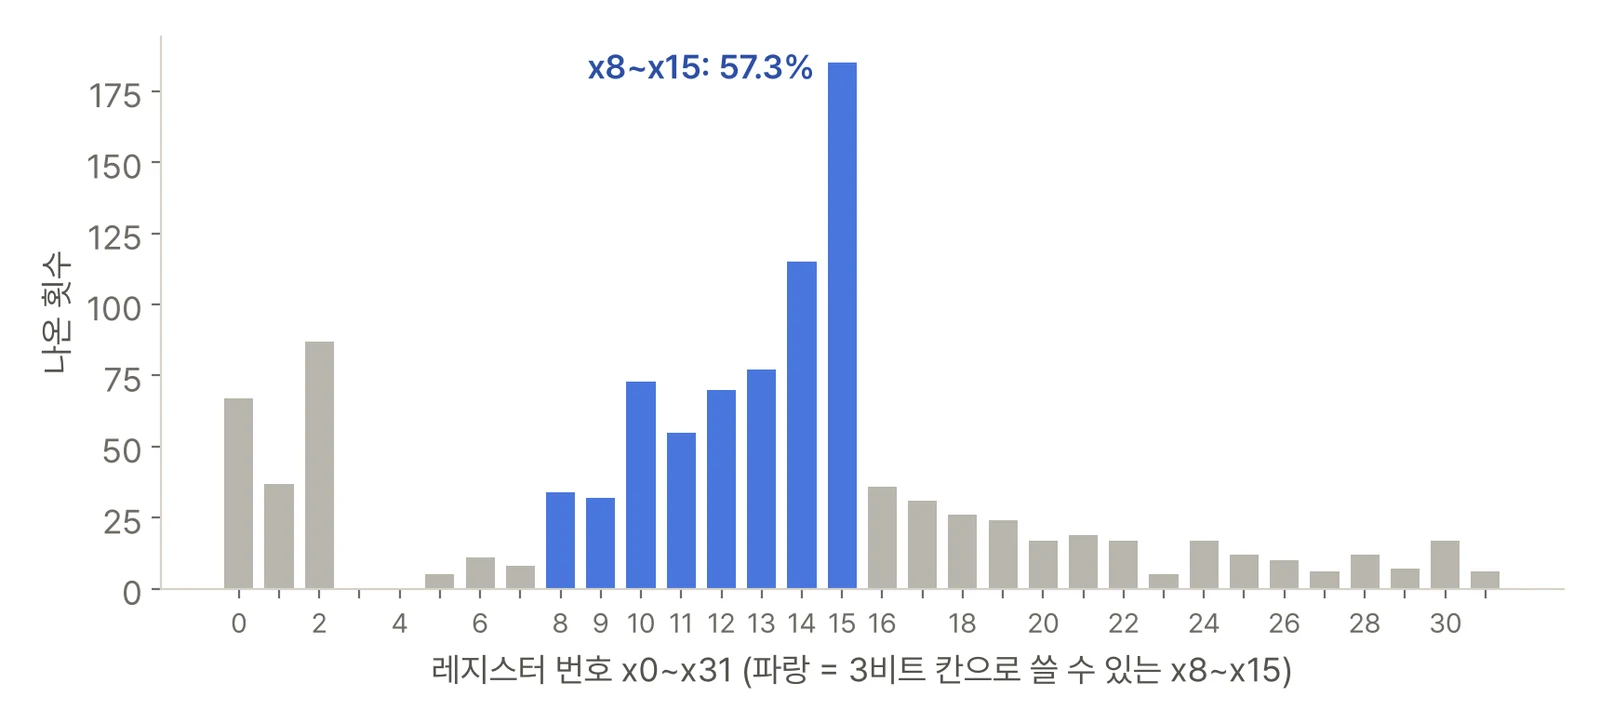
C 없이(rv32im, -O2) 컴파일한 시험 코드에서 레지스터 이름이 1,118번 나왔고, 그중 641번(57.3%)이 x8~x15였다. 32개 중 8개(25%)가 절반 넘게 쓰인 셈이다. 명세는 여기에 두 가지 이유를 더한다. 연속되고 8의 배수에서 시작하는 번호라 압축 해제기가 앞에 01만 붙이면 된다(r' → 01r'). 그리고 정수 레지스터가 16개뿐인 RV32E·RV64E에서도 그대로 쓸 수 있다.
5비트 칸을 남긴 형식도 있다. c.mv·c.add·c.li·c.addi처럼 가장 많이 쓰는 명령어는 어느 레지스터에나 쓸 수 있어야 해서 CR·CI 형식으로 5비트 칸을 지켰다. 그 대신 즉시값이 6비트로 좁다.
4. 32비트 명령어 대응표
명세의 RVC 목록에서 RV32·RV64 공통 명령어와 펼친 모양을 정리했다. 오프셋 즉시값은 대부분 4나 8의 배수만 표현하도록 아래 비트를 생략했다(lw·sw 계열은 4배, ld·sd 계열은 8배).
| 압축 | 펼친 32비트 | 범위·조건 |
|---|---|---|
c.lwsp rd |
lw rd, off(x2) |
off 0~252, rd≠0 |
c.swsp rs2 |
sw rs2, off(x2) |
off 0~252 |
c.lw rd', rs1' |
lw rd', off(rs1') |
off 0~124 |
c.sw rs2', rs1' |
sw rs2', off(rs1') |
off 0~124 |
c.j |
jal x0, off |
±2KiB |
c.jr rs1 |
jalr x0, 0(rs1) |
rs1≠0 |
c.jalr rs1 |
jalr x1, 0(rs1) |
rs1≠0 |
c.beqz rs1' |
beq rs1', x0, off |
±256B |
c.bnez rs1' |
bne rs1', x0, off |
±256B |
c.li rd |
addi rd, x0, imm |
−32~31 |
c.lui rd |
lui rd, imm |
imm≠0, rd≠0·2 |
c.addi rd |
addi rd, rd, imm |
−32~31 |
c.addi16sp |
addi x2, x2, imm |
16의 배수, ≠0 |
c.addi4spn rd' |
addi rd', x2, imm |
4의 배수 4~1020 |
c.slli rd |
slli rd, rd, sh |
|
c.srli·c.srai rd' |
srli·srai rd', rd', sh |
|
c.andi rd' |
andi rd', rd', imm |
−32~31 |
c.mv rd, rs2 |
add rd, x0, rs2 |
rs2≠0 |
c.add rd, rs2 |
add rd, rd, rs2 |
rs2≠0 |
c.sub·xor·or·and |
같은 R 형식, rd'=rs1' | |
c.ebreak |
ebreak |
RV32와 RV64가 다른 자리는 같은 인코딩을 다른 명령어로 쓴다.
| 인코딩 | RV32C | RV64C |
|---|---|---|
| 사분면 1, funct3 001 | c.jal (jal x1) |
c.addiw |
| 사분면 0, funct3 011 | c.flw |
c.ld |
| 사분면 0, funct3 111 | c.fsw |
c.sd |
| 사분면 2, funct3 011·111 | c.flwsp·c.fswsp |
c.ldsp·c.sdsp |
| 사분면 1, CA의 [12]=1 | 예약 | c.subw·c.addw |
RV64에서는 jal보다 addiw가 훨씬 자주 쓰이고, 단정도 로드보다 64비트 로드가 자주 쓰이기 때문에 자리를 바꿨다. 배정도 c.fld·c.fsd·c.fldsp·c.fsdsp는 둘 다 같다.
설계 쪽에서 눈여겨볼 대응이 둘 있다. c.addi4spn과 c.addi16sp는 스택 포인터 전용이다. 함수 앞뒤에서 스택 프레임을 잡고 지역 변수 주소를 만드는 일이 많아서 따로 넣었다. 그리고 c.mv는 addi가 아니라 add rd, x0, rs2로 펼친다. 의사 명령어 mv(= addi rd, rs, 0)와 다르다. 명세는 레지스터 이름 바꾸기(renaming) 하드웨어처럼 mv를 특별히 다루는 코어라면 c.mv를 addi로 펼쳐도 된다고 덧붙인다. 결과 값은 같다.
5. 즉시값 비트는 또 뒤섞여 있다
2편에서 B·J 형식의 즉시값 비트가 뒤섞인 이유를 봤다. 같은 비트를 여러 형식에서 같은 자리에 두어 선택기를 줄이려는 것이다. 16비트 형식에서는 더 심하게 섞였다. 손으로 하나 풀어 보자. 컴파일한 코드에 있던 c.lw s1, 20(a0), 16비트 값 0x4944다.
0x4944 = 010 010 010 1 0 001 00
         f3  [12:10] rs1' [6] [5] rd' op
f3=010 (c.lw), op=00 (사분면 0)
[12:10]=010 → off[5:3] = 2 → 16
[6]=1       → off[2]   = 1 → 4
[5]=0       → off[6]   = 0
rs1' = 010 → x10 (a0),  rd' = 001 → x9 (s1)
off = 16 + 4 = 20 → lw x9, 20(x10) = 0x01452483
오프셋 비트가 5·3·4·2·6 순서가 아니라 [12:10]에 5:3, [6]에 2, [5]에 6으로 흩어져 있다. 32비트 lw와 달리 오프셋이 4의 배수라 off[1:0]은 없다. c.ld는 같은 자리를 [12:10]=5:3, [6:5]=7:6으로 쓴다(8의 배수라 off[2]가 없는 대신 off[7]이 들어감).
스택 포인터를 바꾸는 c.addi16sp는 더 섞였다. 함수 첫 명령어 c.addi16sp sp, -304(0x7169)의 즉시값은 [12]=9, [6]=4, [5]=6, [4:3]=8:7, [2]=5 순서로 흩어져 있다. 풀면 −304이고 펼친 결과는 addi sp, sp, -304(0xed010113)다.
명세는 이렇게 섞은 이유를 "가능한 한 많은 비트를 모든 명령어에서 같은 자리에 두려고"라고 적는다. 예를 들어 CI 형식의 부호 비트는 언제나 [12]다. 대가는 사람이 읽기 어렵다는 것뿐이고, 하드웨어는 비트를 옮기는 배선일 뿐이라 비용이 들지 않는다.
6. 예약·불법 인코딩과 HINT
16비트 공간(사분면 0~2, 49,152개)에는 쓰이지 않는 값이 꽤 있다. 압축 해제기는 이 값을 불법 명령어로 처리해야 한다.
| 인코딩 | 명세의 처리 | RV32 개수 |
|---|---|---|
0x0000 |
영구 불법 명령어 | 1 |
c.addi4spn imm=0 |
예약 | 7 |
c.addi16sp imm=0 |
예약 | 1 |
c.lui imm=0 |
예약 | 31 |
c.lwsp rd=0, c.jr rs1=0 |
예약 | 64 + 1 |
| 사분면 0, funct3 100 | 예약(Zcb가 사용) | 2,048 |
| CA의 [12]=1 | 예약(RV64는 일부 사용) | 256 |
| RV32 시프트 sh[5]=1 | 사용자 정의 확장용 | 1,536 |
0x0000을 불법으로 정한 이유가 재미있다. 지워진 메모리나 0으로 채운 영역으로 잘못 점프하면 곧바로 불법 명령어 예외가 나서 오류를 빨리 잡는다. 32비트 0xffffffff처럼 모든 비트가 1인 값도 불법이다.
예약과 다른 것이 HINT다. rd=x0인 c.li·c.addi·c.mv처럼 결과를 버리는 인코딩은 불법이 아니라 HINT로, 펼친 32비트 명령어를 그대로 실행하면 된다(아무 일도 일어나지 않는다). 나중에 성능 힌트 같은 용도로 쓰기 위해 남긴 자리다. c.addi rd=0, imm=0은 c.nop이다.
C 확장의 빈 자리는 이미 다른 확장이 쓰기 시작했다. 사분면 0의 funct3 100과 CA의 일부는 Zcb(c.lbu·c.mul 등)가 쓴다. 이번 글과 실습은 Zcb 없는 rv32gc·rv64gc 기준이다.
7. 실습 1: 압축 해제기를 objdump와 전수 대조
압축 해제기를 Python으로 짰다. 함수 하나가 16비트 값을 받아 32비트 명령어나 "예약" 사유를 돌려준다. 핵심은 3비트 레지스터 변환과 즉시값 재조립이다.
def expand(c, xlen=32):
    op, f3 = c & 3, b(c, 15, 13)
    rd, rs2 = b(c, 11, 7), b(c, 6, 2)
    rdp, rs2p = 8 + b(c, 4, 2), 8 + b(c, 9, 7)
    imm6 = sx(b(c, 12) << 5 | b(c, 6, 2), 6)
    ...
    if op == 0 and f3 == 2:      # c.lw
        uw = b(c,5) << 6 | b(c,12,10) << 3 | b(c,6) << 2
        return I(uw, rs2p, 2, rdp, LOAD), 'c.lw'
대조 방법은 이렇다. 사분면 0~2의 16비트 값 49,152개를 .insn 2, 값으로 어셈블해 objdump로 풀고, 내 압축 해제기가 펼친 32비트 값을 .insn 4, 값으로 어셈블해 C 없는 아키텍처로 다시 풀어서 두 글을 비교했다. 분기 목표는 주소가 달라지므로 pc 기준 거리로 바꿔 비교했다. 내가 예약으로 본 값은 objdump도 .insn(풀 수 없음)으로 찍어야 일치로 쳤다.
| 대조 | RV32 (rv32gc) |
RV64 (rv64gc) |
|---|---|---|
| 16비트 값 | 49,152 | 49,152 |
| 일치 | 47,615 | 49,151 |
| └ 그중 HINT | 331 | 363 |
| 불일치 | 1,537 | 1 |
불일치는 모두 objdump가 명세보다 너그러운 경우였다. RV64와 RV32 공통의 1개는 c.addi16sp imm=0(0x6101)이다. 명세는 예약이라 했지만 objdump는 addi sp,sp,0으로 풀었다. RV32의 나머지 1,536개는 시프트 양 sh[5]=1인 c.slli·c.srli·c.srai다. RV32에서 32 이상 밀기는 의미가 없어서 명세가 사용자 정의 확장용으로 비워 뒀는데, objdump는 c.slli zero,0x20처럼 풀었다.
처음 대조에서는 불일치가 3천 개를 넘었다. 대부분 표기 차이였다. objdump는 HINT를 c.slli zero,0x0처럼 압축 이름으로 찍고, c.mv는 의사 명령어 mv로 찍는다. 앞의 것은 압축 이름을 펼친 글로 바꿔 비교했고, c.mv는 위에서 본 대로 명세의 펼침이 add라서 mv rd, rs를 add rd, zero, rs로 바꿔 비교했다. 이 과정에서 압축 해제기 쪽 버그는 나오지 않았다.
8. 실습 2: 실제 코드의 압축률
압축률은 코드에 따라 다르다. 두 가지 코드로 쟀다. 하나는 SHA-256, 퀵정렬, 문자열 함수, 10진 출력, 연결 리스트, 해시 표를 담은 시험 코드(bench.c, 약 90줄)이고, 하나는 1편의 kernels.c(함수 7개)다. 같은 파일을 C 있이·없이 컴파일해 .text 크기를 비교했다(GCC 16.2).
| 코드 (옵션) | C 없이 | C 있이 | 16비트 비율 |
|---|---|---|---|
| bench.c (-O2, RV32) | 2,092 B | 1,546 B (73.9%) | 52.2% |
| bench.c (-Os, RV32) | 1,900 B | 1,358 B (71.5%) | 57.1% |
| bench.c (-O2, RV64) | 2,100 B | 1,562 B (74.4%) | 51.2% |
| kernels.c (-O2, RV32) | 668 B | 438 B (65.6%) | 68.9% |
명령어 개수는 C가 있든 없든 같았다(bench.c -O2 RV32에서 둘 다 523개). 1절의 약속대로 압축은 일대일 대응이라 명령어를 줄이지는 않고 길이만 줄인다. 명령어의 절반 이상이 16비트가 되어 코드는 26~34% 작아졌다. bench.c는 QEMU에서 rv32im과 rv32imc로 각각 실행해 출력이 같은지, SHA-256 결과가 Python hashlib과 같은지도 확인했다.
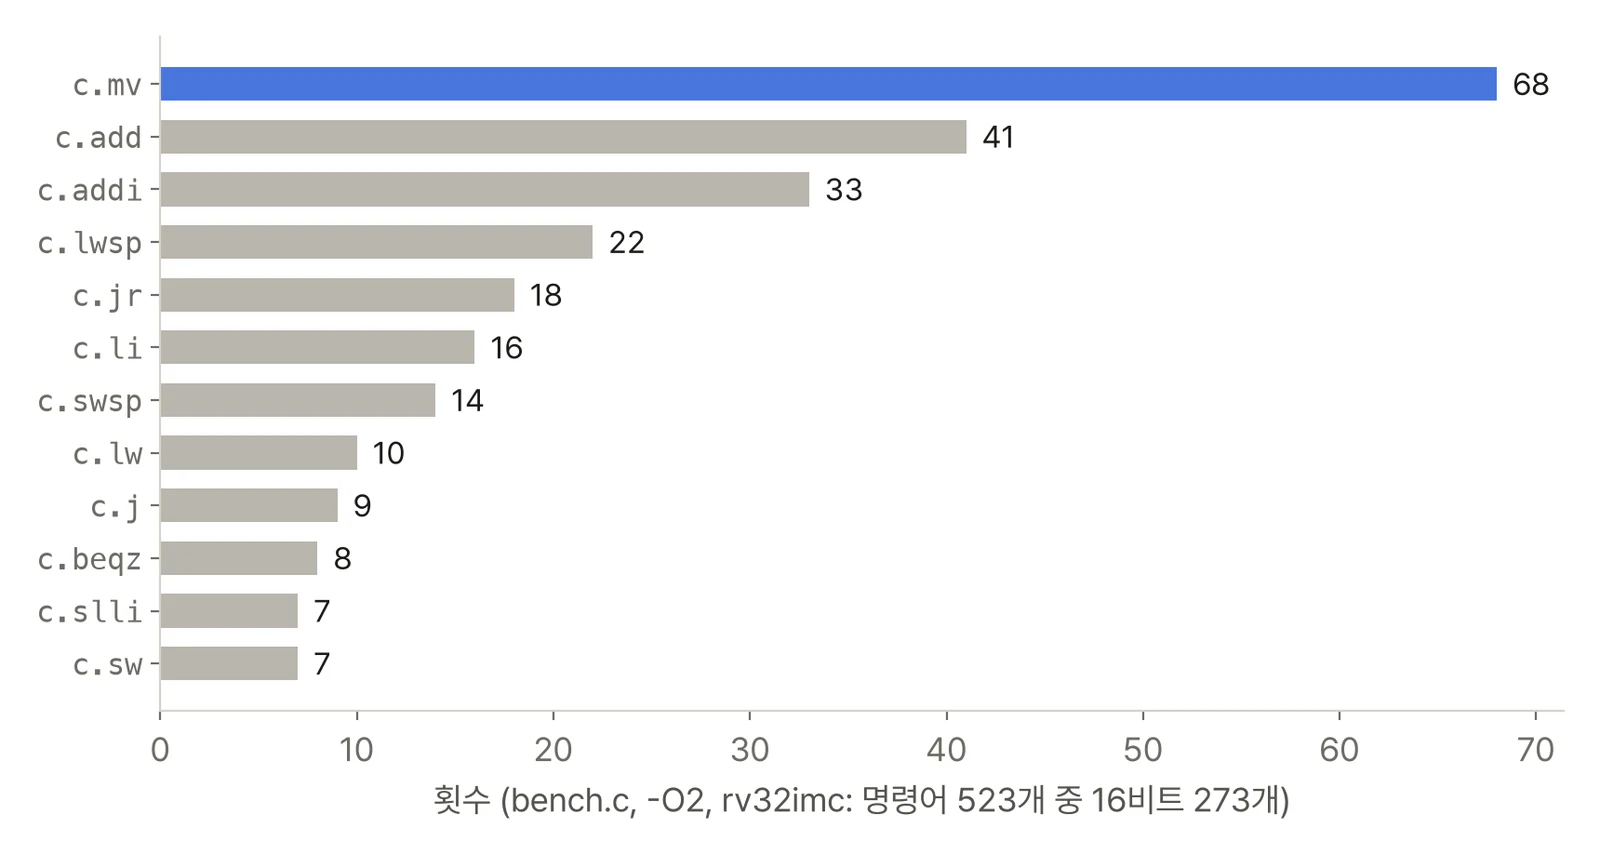
어떤 압축 명령어가 많이 쓰였는지도 봤다. 레지스터 복사 c.mv가 가장 많았고, c.add·c.addi, 스택 로드·저장 c.lwsp·c.swsp, 함수 복귀 c.jr(ret), 상수 c.li가 뒤를 이었다. 5비트 레지스터 칸을 지킨 CR·CI·CSS 형식 명령어가 위를 차지한다. 3비트 칸의 c.lw·c.sw는 10개, 7개였다. RV64에서는 c.sdsp·c.ldsp(64비트 스택 저장·로드)가 26개씩으로 2위였다. 함수 앞뒤에서 레지스터를 저장하고 되살리는 코드다.
9. 설계 체크리스트: 압축 명령어 디코딩
| 항목 | 규칙 |
|---|---|
| 길이 판별 | inst[1:0]≠11이면 16비트. C가 없는 코어는 이것을 불법 명령어로 |
| 정렬 | C가 있으면 명령어 주소는 2의 배수면 된다. 분기 목표 정렬 예외 조건이 바뀐다 |
| 3비트 레지스터 | 번호 = 01 + r'. [9:7]과 [4:2] 두 자리만 |
0x0000 |
불법 명령어(예약 아님, 영구 불법) |
| 0 즉시값 | c.addi4spn·c.addi16sp·c.lui는 imm=0이 예약 → 불법 |
| rd·rs1=0 | c.lwsp·c.ldsp·c.addiw(rd=0), c.jr(rs1=0)은 예약. c.li·c.addi·c.mv·c.add rd=0은 HINT(실행) |
| RV32 시프트 | sh[5]=1은 사용자 정의 확장용. 쓰지 않는다면 불법으로 |
c.jalr과 c.ebreak |
사분면 2 funct3 100, [12]=1, rs2=0에서 rs1=0이면 ebreak |
c.mv |
명세는 add rd, x0, rs2. addi로 펼치는 것도 허용 |
| XLEN별 차이 | funct3 001(c.jal/c.addiw), 011·111(flw/ld 계열) |
mtval |
불법 명령어 예외에서 명령어 비트를 적는다면 16비트 원본(위 16비트 0)을 적는다 |
| F·D 없음 | c.flw·c.fld 계열은 F·D가 없거나 꺼져 있으면 불법 |
마지막 두 줄은 다른 장과 이어진다. mtval에 무엇을 적을지는 특권 명세의 규칙이고(25편), 부동소수점 압축 명령어가 FPU 꺼짐(mstatus.FS=Off)에서 불법이 되는 것은 10편의 규칙이 펼친 32비트 명령어에 그대로 적용되기 때문이다.
정리
- C 확장의 16비트 명령어는 모두 하나의 32비트 명령어로 펼쳐진다. 아래 두 비트가
11이 아니면 16비트이고, 형식은 9가지다. - 3비트 레지스터 칸은 가장 많이 쓰는
x8~x15(s0·s1·a0~a5)를 가리킨다. 시험 코드에서 레지스터 이름의 57.3%가 이 8개였다. 0x0000은 영구 불법이고, 즉시값 0이나 rd=0 같은 일부 인코딩은 예약, 결과를 버리는 인코딩은 HINT다. 압축 해제기 대조에서 objdump와 다른 1,537개(RV32)는 모두 명세상 예약·사용자 정의 자리였다.- 실제 코드에서 명령어의 51~69%가 16비트가 되어 코드가 26~34% 줄었다. 명령어 수는 그대로다.
다음 글: 12편은 작은 확장 묶음이다. CSR을 읽고 쓰는 Zicsr의 csrrw·csrrs·csrrc가 rd나 rs1이 x0일 때 읽기·쓰기 부작용을 어떻게 달리하는지, Zifencei, 카운터(Zicntr·Zihpm), 비트 조작 B 확장(Zba·Zbb·Zbs), 분기 없는 선택 Zicond, 캐시 관리 Zicbom을 QEMU에서 실행해 확인한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 26장 C 확장 2.0판(26.2 압축 형식, 26.3 로드·스토어, 26.4 제어 이동, 26.5 정수 연산과 정의된 불법 명령어, 26.7 HINT, 26.8 RVC 명령어 목록), 27장 Zc* 확장(Zcb). https://github.com/riscv/riscv-isa-manual
- A. Waterman, "Improving Energy Efficiency and Reducing Code Size with RISC-V Compressed," UCB/EECS-2011-63, 2011. https://www2.eecs.berkeley.edu/Pubs/TechRpts/2011/EECS-2011-63.html
- D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 7장 RV32C
- RISC-V ELF psABI(레지스터 ABI 이름). https://github.com/riscv-non-isa/riscv-elf-psabi-doc