이 글의 핵심 3줄
- 벡터 코드에서
if는 분기가 아니라 마스크다. 비교 명령어가v0에 원소마다 1비트를 쓰고, 뒤따르는 명령어가v0.t로 그 비트가 1인 원소만 바꾼다. 꺼진 원소(비활성)와 vl 너머 원소(꼬리)를 지킬지 말지는vtype의 ma·ta 비트가 정한다. - 메모리 접근은 연속(단위 보폭)·일정 간격(보폭)·주소 목록(인덱스)·구조체 필드(세그먼트) 네 모양이 있고, first-fault 로드는 원소 0이 아니면 폴트 대신 vl을 줄인다. RAM 끝 바로 앞의 문자열에서 보통 로드는 접근 폴트(vstart=40)를 냈고, first-fault 로드는 vl을 40으로 줄이고 넘어갔다.
- 마스크 덧셈·게더·합·
vcompress필터 네 커널을 원소 1,000개로 QEMU VLEN 128~1024에서 돌려 Python 기준과 78개 항목이 모두 일치했다. 실행 명령어 수는 VLEN 128에서 스칼라의 31~55%, 1024에서 4~7%였다.
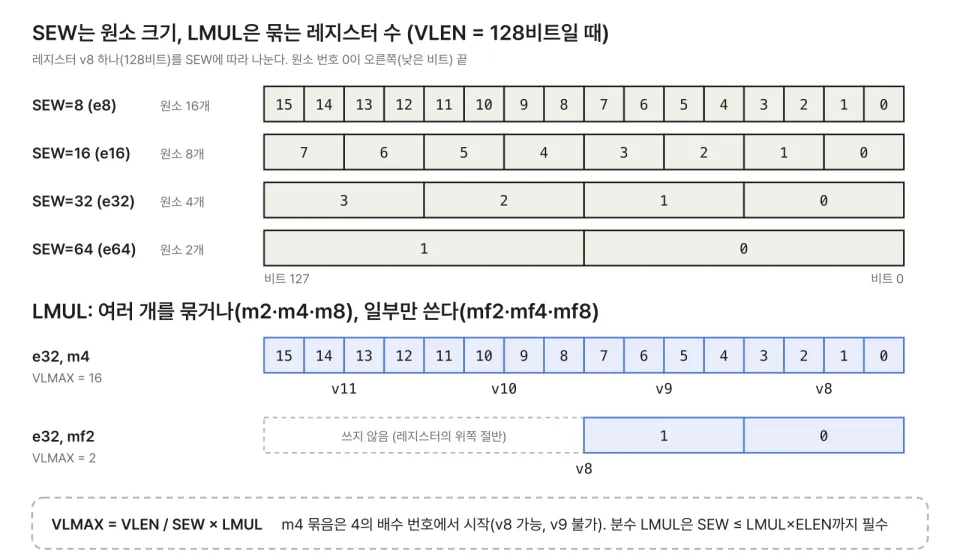
13편에서 벡터 레지스터와 vtype·vl, 그리고 vsetvli로 길이에 묶이지 않는 루프를 짰다. 거기서는 모든 원소에 같은 일을 하고, 메모리를 연속으로만 읽었다. 실제 루프에는 조건문이 있고, 표에서 값을 찾아오고, 배열을 하나의 값으로 줄이고, 원소 순서를 바꾼다. 14편은 V 확장에서 이것을 맡는 나머지 절반이다. 마스크, 로드·스토어 네 가지와 first-fault 로드, 축약, 순열, 그리고 tail·mask agnostic을 차례로 보고, 마지막에 디코더와 레지스터 파일 쪽에서 챙길 규칙을 모은다. 근거는 13편과 같은 비특권 명세 20240411 판 31장(V 1.0)이다.
1. 마스크: v0와 조건부 실행
스칼라 코드는 if (a[i] > 0)를 분기로 만든다. 벡터 명령어 하나는 원소 여러 개를 함께 처리하니, 원소마다 다른 길로 갈 수 없다. 그래서 V 확장은 조건을 마스크로 바꾼다. 비교 결과를 원소당 1비트로 저장하고, 연산은 모든 원소에서 하되 비트가 1인 원소의 결과만 쓴다.
마스크 배치는 단순하다. 마스크 레지스터의 비트 i가 원소 i다. SEW나 LMUL과 상관없이 언제나 그렇다. VLMAX가 가장 큰 경우(e8·m8, VLEN 128에서 128개)도 레지스터 하나의 128비트에 들어간다. 그래서 마스크는 언제나 레지스터 하나다.
명령어에서 마스크를 쓸지는 inst[25]의 vm 비트가 정한다. vm=0이면 v0.t(v0를 마스크로), vm=1이면 마스크 없이 모든 원소다. 마스크로 쓸 수 있는 레지스터는 v0 하나뿐이다. 마스크 레지스터 번호를 적을 칸을 두지 않고 1비트로 줄인 것이다. 대신 마스크를 여러 개 쓰는 코드는 v0로 옮기는 명령어가 더 필요하다.
손으로 따라가 보자. VLEN 128, e32, vl=4에서 c[i] = a[i] > 0 ? a[i] + b[i] : a[i]를 계산한다.
v1 = a = { 5, -3,  0,  8}     (원소 0, 1, 2, 3)
v2 = b = { 1,  1,  1,  1}
vmsgt.vi v0, v1, 0            → v0 = 0b1001
vadd.vv v1, v1, v2, v0.t → v1 = { 6, -3, 0, 9}vmsgt.vi는 원소마다 a > 0을 비교해 원소 0과 3에서 1을 쓴다. 이진수로는 비트 3과 비트 0이 1이라 0b1001이다. vadd는 그 두 원소만 더하고, 원소 1·2는 v1의 원래 값(a)을 남긴다. 이 "남긴다"가 2절의 mask undisturbed다. GCC 16.2는 intrinsics __riscv_vadd_vv_i32m1_mu를 이 모양 그대로 컴파일하면서 vsetvli에 mu를 붙였다.
마스크를 만들고 다루는 명령어는 다음과 같다.
| 종류 | 명령어 | 하는 일 |
|---|---|---|
| 비교 | vmseq vmsne vmslt vmsle vmsgt … |
원소마다 비교, 결과 1비트 |
| 마스크 논리 | vmand.mm vmor.mm vmxor.mm vmandn.mm … |
마스크끼리 비트 연산 |
| 세기·찾기 | vcpop.m, vfirst.m |
1의 개수, 첫 1의 위치(없으면 −1) |
| 앞부분 | vmsbf vmsif vmsof |
첫 1 이전/까지/그 자리만 1 |
| 번호 | viota.m, vid.v |
앞선 1의 개수, 원소 번호 |
마스크 결과를 쓰는 비교 명령어는 마스크 하나를 레지스터 하나에 쓴다(LMUL이 8이라도). 마스크를 쓰는 연산과 대상 레지스터 사이에는 규칙이 하나 있다. 마스크를 쓰는(vm=0) 명령어의 결과 레지스터 그룹은 v0와 겹치면 안 된다. 결과가 마스크(비교)이거나 축약의 스칼라 결과일 때만 예외다. 원소를 쓰는 도중에 자기 마스크를 덮어쓰는 일을 막는 규칙이다.
2. 본체와 꼬리: tail·mask agnostic
명령어 하나가 보는 원소는 세 부분으로 나뉜다.
- prestart: 번호가
vstart보다 작은 원소. 예외 뒤 다시 시작할 때 이미 끝난 부분이다(5절). 건드리지 않는다. - 본체(body):
vstart~ vl−1. 마스크 비트가 1이면 활성(active), 0이면 비활성(inactive). - 꼬리(tail): vl ~ VLMAX−1. 이번 vl 밖의 원소다.
활성 원소는 결과를 쓴다. 문제는 비활성 원소와 꼬리 원소다. vtype의 vma·vta 비트가 이 둘의 정책을 정한다.
- undisturbed(mu·tu): 이전 값을 반드시 지킨다.
- agnostic(ma·ta): 이전 값을 지켜도 되고, 모든 비트를 1로 덮어써도 된다.
agnostic이 왜 필요할까. 레지스터 이름 바꾸기(renaming)를 하는 비순차 코어를 생각하자. vadd.vv v8, …의 결과는 새 물리 레지스터에 쓰인다. 꼬리를 지켜야 한다면 옛 v8의 값을 읽어서 새 레지스터에 옮겨야 한다. 그러려면 읽기 포트가 하나 더 필요하고, 이 명령어가 옛 v8을 만든 명령어를 기다려야 한다(데이터 의존이 생긴다). agnostic이면 그 복사를 하지 않아도 된다. 반대로 단순한 순차 코어는 그냥 안 쓰고 지나가면 되니 undisturbed가 오히려 쉽다. 덮어쓸 값을 0이 아니라 모두 1로 정한 것은, 소프트웨어가 그 값에 기대는 코드를 쓰지 않게 하려는 것이라고 명세는 설명한다.
QEMU에서 확인했다. v8을 7로 채우고, vl=3, 마스크 0b0101(원소 0·2 활성)로 vadd.vv v8, v1, v2, v0.t를 실행한 뒤, vs1r.v(vl과 상관없이 레지스터 전체를 저장)로 네 원소를 모두 읽었다.
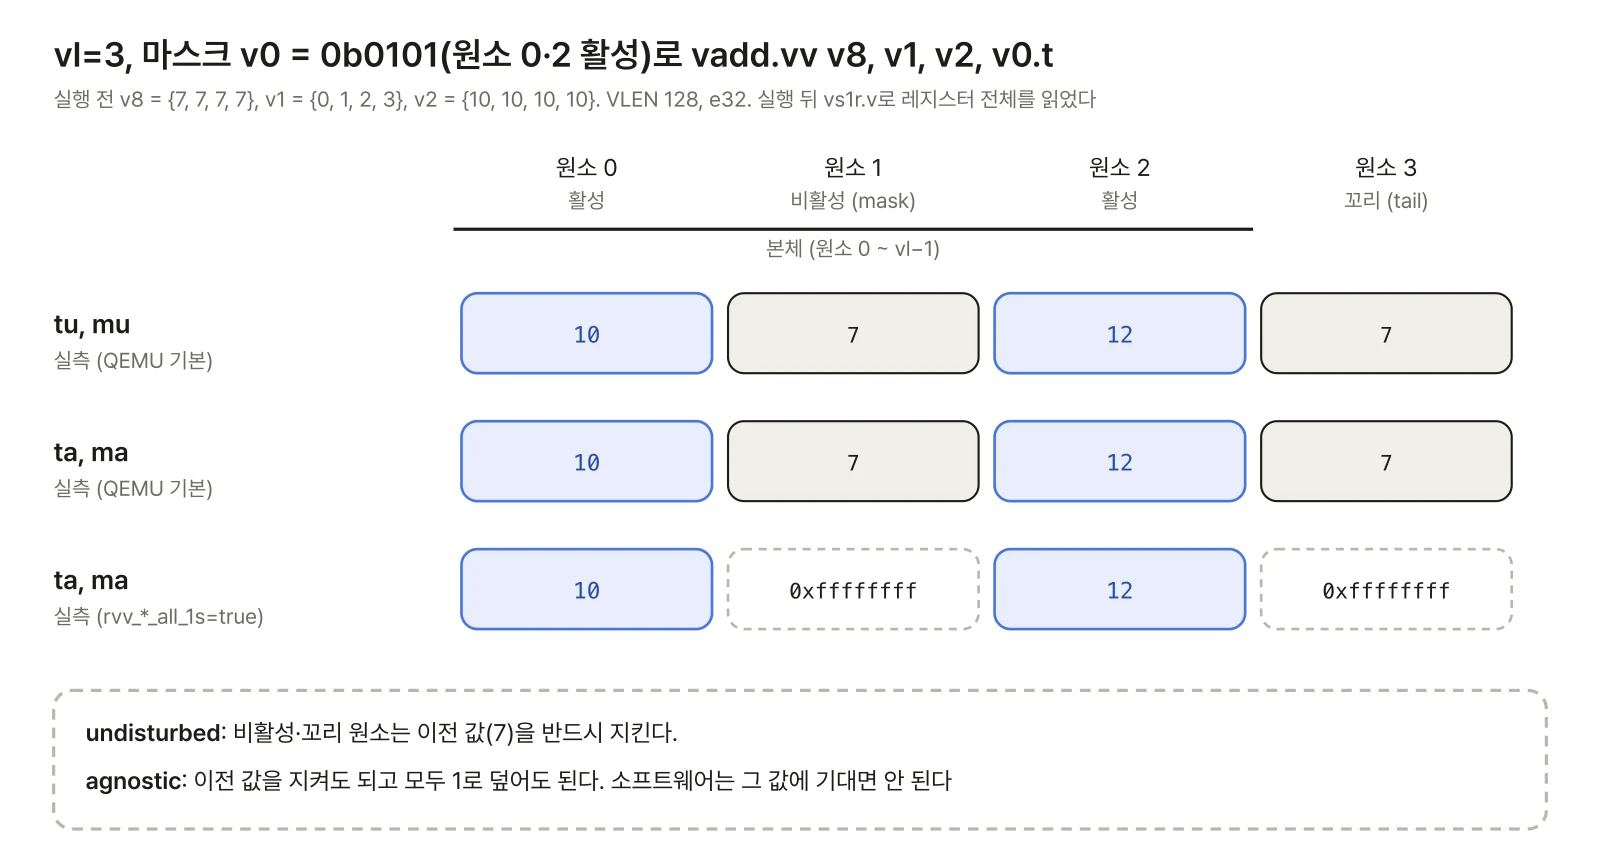
QEMU 기본값은 ta·ma에서도 이전 값을 지켰다. 명세가 허용하는 두 동작 중 하나다. CPU 속성 rvv_ta_all_1s=true,rvv_ma_all_1s=true를 주면 같은 기계어에서 원소 1·3이 0xffffffff가 됐다. 소프트웨어 검증에서는 이 설정으로 돌려서 "agnostic인데 옛 값에 기대는" 버그를 잡을 수 있다. 하나 더, 마스크를 결과로 쓰는 명령어(비교 등)의 꼬리는 vta와 상관없이 언제나 agnostic이다.
3. 로드·스토어 네 가지
13편에서 본 vle32.v는 연속한 원소를 읽는 단위 보폭(unit-stride) 로드였다. 주소를 만드는 방법이 셋 더 있다.
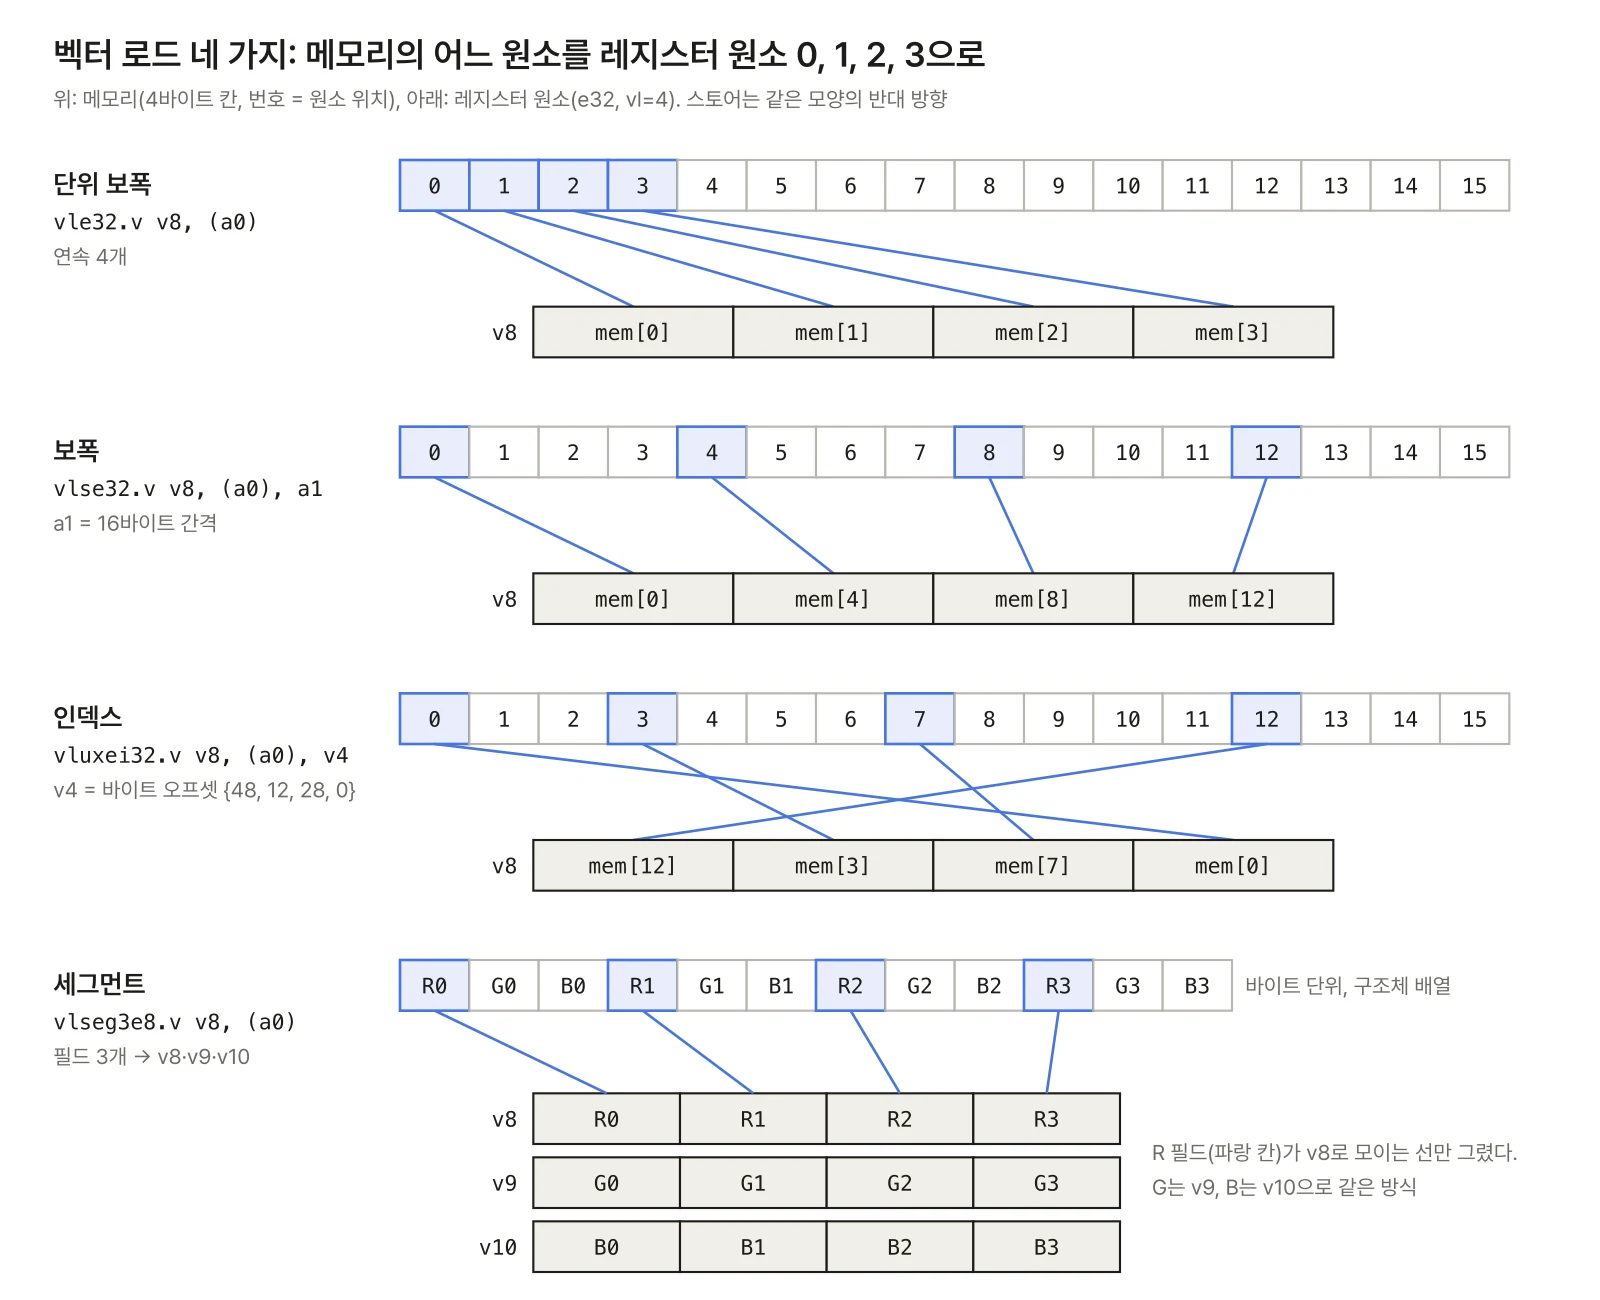
| 종류 | 로드 / 스토어 | 주소 |
|---|---|---|
| 단위 보폭 | vle32.v / vse32.v |
base + i × 4 |
| 보폭 | vlse32.v / vsse32.v |
base + i × rs2 (바이트) |
| 인덱스 | vluxei32.v / vsuxei32.v |
base + vs2[i] (바이트) |
| 세그먼트 | vlseg3e8.v / vsseg3e8.v |
필드 3개를 v, v+1, v+2로 |
보폭(strided) 로드는 행렬의 열처럼 일정 간격으로 떨어진 원소를 모은다. 간격은 정수 레지스터에 바이트 단위로 주고, 0이나 음수도 된다. 실습에서는 16×16 int32 행렬의 3번 열을 간격 64바이트로 읽어 16개(3, 103, 203, …, 1503)가 모두 맞았다.
인덱스(indexed) 로드는 원소마다 주소가 다른 게더(gather)이고, 스토어는 스캐터(scatter)다. 오프셋 벡터 vs2는 바이트 오프셋이라, int32 배열의 첨자라면 4를 곱해 줘야 한다(실습 코드의 vsll). 오프셋의 폭은 명령어 이름의 EEW(ei32면 32비트)이고, 데이터 원소의 폭은 SEW를 따른다. 일반 로드와 반대다. 이름의 u는 순서 없음(unordered), o는 순서 지킴(ordered)이다. 순서는 장치 메모리처럼 접근 순서가 의미 있는 곳에서 중요하다. 같은 주소에 여러 원소를 쓰는 스캐터에서는 ordered여야 마지막 원소의 값이 남는다고 보장된다.
세그먼트(segment) 로드는 RGB 픽셀처럼 필드가 섞인 구조체 배열을 필드별 레지스터로 나눈다. vlseg3e8.v v8, (a0)은 R을 v8, G를 v9, B를 v10에 담는다. 실습에서 64픽셀을 나눴고, vl이 VLEN 128에서 16이라 4번, 256에서 2번, 512 이상에서 1번 돌았다. 필드 수(NFIELDS)는 2~8이고, NFIELDS × EMUL ≤ 8이어야 한다. 레지스터 번호가 v31을 넘어도 예약이다.
인코딩에서 보면 벡터 로드·스토어는 새 opcode를 쓰지 않는다. FP 로드(LOAD-FP, 0000111)와 FP 스토어(STORE-FP, 0100111)의 opcode를 함께 쓰고, width 칸(funct3)으로 가른다.
LOAD-FP width: 000 e8, 101 e16, 110 e32, 111 e64 → 벡터
               001 flh, 010 flw, 011 fld, 100 flq → FP
[31:29] nf    세그먼트 필드 수 − 1
[28]    mew   0 (1은 128비트 이상 원소용 예약)
[27:26] mop   00 단위, 01 인덱스(u), 10 보폭, 11 인덱스(o)
[25]    vm    마스크
[24:20] 단위 보폭에서는 lumop: 00000 보통,
        01000 레지스터 전체, 01011 마스크, 10000 ff
V가 없는 코어도 LOAD-FP를 디코드하므로, F만 있는 코어에서 width가 000·101·110·111이면 불법 명령어로 보내야 한다.
4. first-fault 로드와 strlen
C 문자열의 길이를 벡터로 재려면 문제가 있다. 문자열이 어디서 끝나는지 모르니, 16바이트씩 읽다 보면 끝(NUL) 뒤의 메모리까지 읽게 된다. 그 메모리가 매핑되지 않은 페이지라면 원래 프로그램에는 없던 폴트가 난다.
first-fault 로드(vle8ff.v 등)가 이 문제를 푼다. 규칙은 둘이다.
- 원소 0에서 예외가 나면 보통 로드처럼 트랩을 낸다. vl은 그대로다.
- 원소 1 이후에서 예외가 나면 트랩을 내지 않고, vl을 그 원소 번호로 줄인다. 그 앞까지만 읽은 셈이다.
원소 0을 읽을 수 있으면 적어도 한 개는 진행하니 루프가 멈추지 않고, 진짜 잘못된 주소는 다음 반복에서 원소 0이 되어 트랩이 난다. 명세는 예외가 없어도 구현이 vl을 줄이는 것을 허용한다(vstart=0, vl>0이면 원소 하나는 처리해야 한다). 그래서 코드는 매번 줄어든 vl을 다시 읽어야 한다. GCC는 vle8ff.v 바로 뒤에 csrr a5, vl을 넣었다.
QEMU virt의 RAM은 0x80000000부터 128MiB라 0x88000000에서 끝나고, 그 너머에는 장치가 없다. RAM 끝 40바이트 앞에 30글자 문자열(NUL은 30번, 31~39는 z)을 놓고, e8·m1의 VLMAX만큼씩 읽었다.
| VLEN | VLMAX | vle8ff vl 순서 |
같은 일을 vle8.v로 |
|---|---|---|---|
| 128 | 16 | 16, 16 | 문제없음 |
| 256 | 32 | 32 | 문제없음 |
| 512 | 64 | 40 | 접근 폴트, vstart 40 |
| 1024 | 128 | 40 | 접근 폴트, vstart 40 |
VLEN 512부터는 한 번에 64바이트를 읽으려다 41번째 바이트(0x88000000)에서 막힌다. first-fault 로드는 vl을 40으로 줄이고 그 안에서 30번 NUL을 찾아 30을 돌려줬다. 보통 로드는 mcause 5(로드 접근 폴트), mtval 0x88000000, vstart 40으로 트랩을 냈다. vstart는 다음 절의 정밀 예외 규칙 그대로 "원소 40부터 다시 하면 된다"는 뜻이다. 같은 기계어가 좁은 기계에서는 문제없고 넓은 기계에서만 폴트를 낸다. 길이에 묶이지 않는 코드에서 first-fault 로드가 필요한 이유다.
5. 축약과 순열
축약(reduction)은 벡터를 스칼라 하나로 줄인다. vredsum.vs vd, vs2, vs1은 vs1의 원소 0과 vs2의 활성 원소를 모두 더해 vd의 원소 0에 쓴다. vd의 나머지 원소는 꼬리로 취급한다. vs1의 원소 0을 초기값으로 받으니, 스트립 마이닝 루프에서 누적값을 원소 0에 들고 다닐 수 있다.
vsetivli zero, 1, e32, m1, ta, ma
vmv.s.x  v1, zero          # 누적값 = 0
loop:
  vsetvli    a5, a1, e32, m1, ta, ma
  vle32.v    v2, (a0)
  vredsum.vs v1, v2, v1    # v1[0] += sum(v2[0..vl-1])
  ...
vmv.x.s a0, v1 # 정수 레지스터로vredmax·vredand 같은 정수 축약은 순서와 상관없이 답이 같다. FP 합은 순서에 따라 반올림이 달라지므로 둘로 나뉜다. vfredosum은 원소 순서대로 더하고, vfredusum은 순서를 구현에 맡긴다. 하드웨어는 unordered 쪽에서 덧셈 트리를 자유롭게 짤 수 있다. 실습에서 −1000~1000 무작위 정수 1,000개의 합은 네 VLEN 모두 −22,951로 Python과 같았다.
순열(permutation)은 원소 자리를 옮긴다.
vslideup.vx vd, vs2, k: vd[i+k] = vs2[i]. vd의 원소 0~k−1은 그대로 둔다.vslidedown.vx vd, vs2, k: vd[i] = vs2[i+k]. i+k가 VLMAX 이상이면 0.vrgather.vv vd, vs2, vs1: vd[i] = vs2[vs1[i]]. 첨자가 VLMAX 이상이면 0.vcompress.vm vd, vs2, vs1: 마스크 vs1이 1인 원소만 앞으로 모은다.
8개 원소 {10, …, 17}로 해 보니 slideup 3은 {−1, −1, −1, 10, 11, 12, 13, 14}(앞 3개는 미리 채운 −1이 남음), vid로 만든 {7, 6, …, 0}으로 vrgather를 하니 순서가 뒤집혔다. 흥미로운 것은 slidedown이다. vl=8, e32·m2에서 VLEN 128이면 VLMAX가 8이라 끝 3개가 0이었다. 그런데 VLEN 256 이상에서는 VLMAX가 16 이상이라, vl 너머에 있던 vs2의 원소 8~10(이전 연산이 남긴 값)이 들어왔다. 규칙이 vl이 아니라 VLMAX 기준이기 때문이다. 길이에 묶이지 않는 코드라면 vl 너머 원소는 값을 믿지 말아야 한다.
vcompress는 필터에 쓴다. 양수만 모으는 루프는 이렇게 됐다.
vle32.v      v1, (a1)
vmsgt.vi     v0, v1, 0     # 양수 마스크
vcpop.m      a3, v0        # 개수
vcompress.vm v2, v1, v0    # 양수를 앞으로
vsetvli      zero, a3, e32, m1, ta, ma
vse32.v      v2, (a4)      # 개수만큼만 저장
스칼라였다면 원소마다 분기가 있었을 루프에 분기가 루프 끝 하나뿐이다. 1,000개 중 478개가 남았고, 순서까지 Python과 같았다.
6. 실습: 네 커널, 네 VLEN
13편과 같은 방식이다. vops.c를 -march=rv64gcv -O1로 한 번 빌드하고(.text sha256 앞 16자 cd6ae9d556f31d59), QEMU 11.1.3에서 VLEN 128·256·512·1024로 돌렸다. 시작 코드는 13편처럼 mstatus.VS를 켜고, -icount shift=0으로 minstret을 실행 명령어 수로 썼다. 입력은 시드를 고정한 64비트 LCG로 C와 Python이 같은 값을 만든다. 장비는 맥 M1 Max, riscv64-elf-gcc 16.2다.
size_t vfilter(int32_t *c, const int32_t *a, size_t n) {
  size_t k = 0;
  for (size_t vl; n; n -= vl, a += vl) {
    vl = __riscv_vsetvl_e32m1(n);
    vint32m1_t x = __riscv_vle32_v_i32m1(a, vl);
    vbool32_t p = __riscv_vmsgt_vx_i32m1_b32(x, 0, vl);
    size_t cnt = __riscv_vcpop_m_b32(p, vl);
    __riscv_vse32_v_i32m1(c + k,
        __riscv_vcompress_vm_i32m1(x, p, vl), cnt);
    k += cnt;
  }
  return k;
}
원소 1,000개에서 실행 명령어 수다. 스칼라는 자동 벡터화를 끄고 컴파일한 같은 루프다.
| 커널 | 스칼라 | VLEN 128 | VLEN 1024 |
|---|---|---|---|
| 조건부 덧셈 | 8,448 | 3,010 | 394 |
| 게더 | 8,013 | 2,510 | 330 |
| 합 | 4,011 | 1,760 | 234 |
vcompress 필터 |
6,405 | 3,511 | 459 |
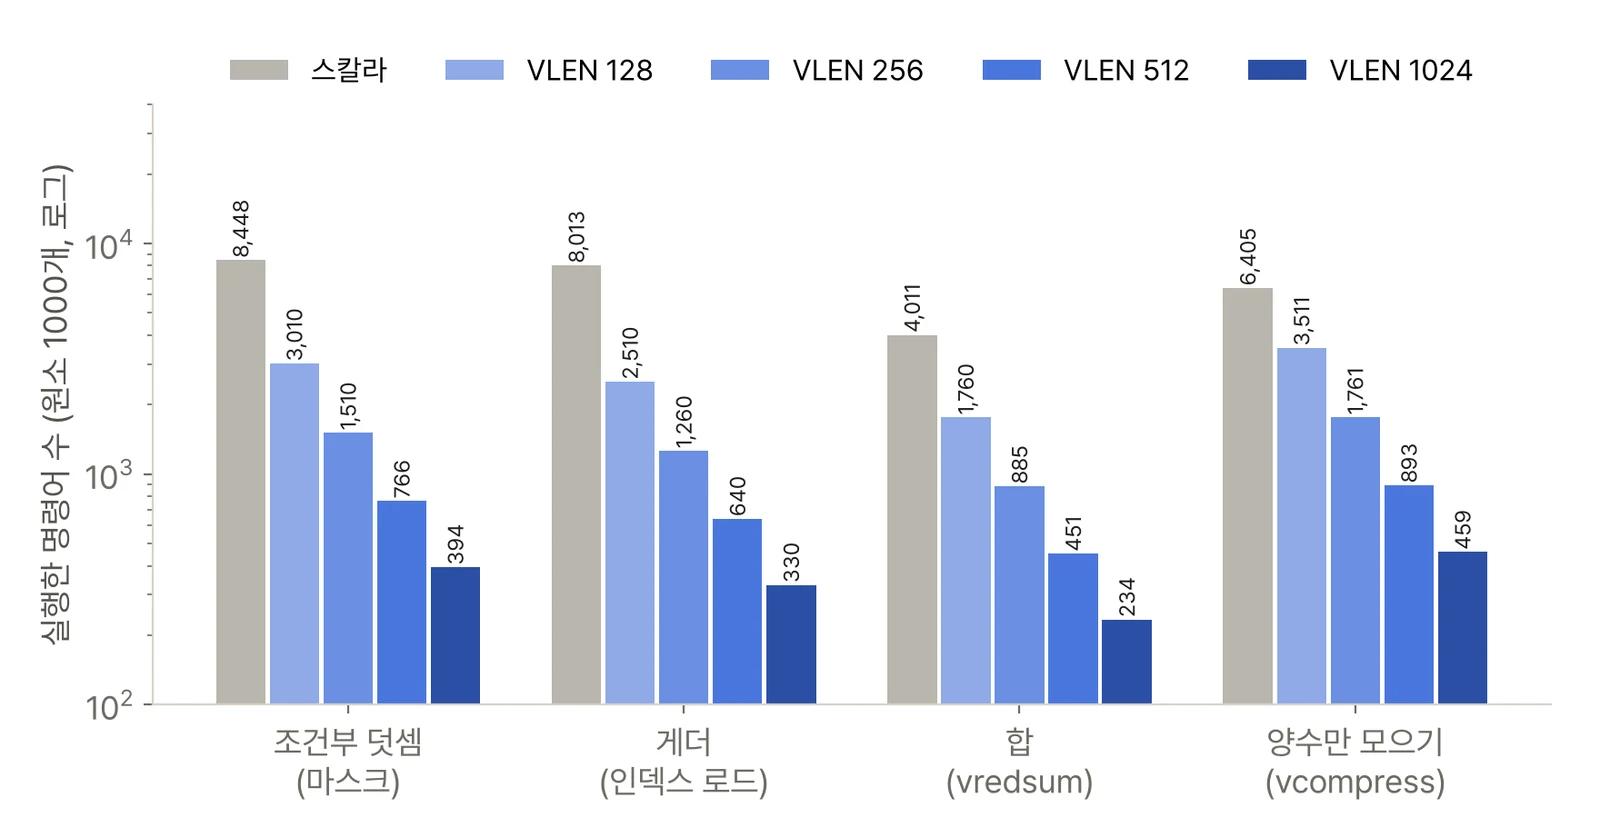
VLEN 128에서 스칼라 대비 31~55%, 1024에서 4~7%다. 필터의 비율이 가장 높다. 스칼라 필터는 음수를 저장하지 않고 건너뛰어 원소당 명령어가 적고, 벡터 필터는 저장할 개수를 맞추려고 vsetvli를 한 번 더 하기 때문이다(반복당 14개). 13편처럼 이것은 명령어 수이지 시간이 아니다. 게더는 원소마다 주소가 달라 실제 하드웨어에서는 원소 몇 개씩만 처리하는 경우가 많다(추정). 명령어 하나가 하는 일이 늘수록 명령어 수와 시간의 차이도 커진다.
정확성은 VLEN마다 19개 항목(마스크 덧셈·게더·필터의 해시와 개수, 스칼라 쪽 결과 3개, 합, 보폭 열, 세그먼트 결과와 반복 수, 순열 3개, tu·mu와 ta·ma 값, strlen 결과, first-fault vl 순서, 보통 로드의 트랩 정보)과 agnostic 1 채우기 2개, 모두 78개가 Python 기준과 일치했다. 처음에는 VLEN 1024에서 QEMU가 끝나지 않았다. ta·ma 시험에서 vs1r.v로 레지스터를 16바이트 배열에 저장했는데, vs1r.v는 vl과 상관없이 VLEN비트(1024면 128바이트)를 다 쓴다. 스택을 덮어써서 복귀 주소가 깨졌던 것이다. 전체 레지스터 로드·스토어는 vtype을 보지 않는다는 규칙을 몸으로 배웠다.
7. 설계 체크리스트: 디코더와 레지스터 파일
| 항목 | 규칙 |
|---|---|
| 그룹 정렬 | vd·vs1·vs2 번호가 각자의 EMUL 배수가 아니면 불법(13편). 인덱스 로드는 오프셋 EMUL = EEW/SEW × LMUL로 따로 계산 |
| v0 겹침 | vm=0인 명령어의 vd 그룹이 v0와 겹치면 예약. 비교(마스크 결과)와 축약의 스칼라 결과는 예외 |
| 순열 겹침 | vslideup·vrgather·vcompress는 vd가 원본(그리고 vcompress의 마스크)과 겹치면 예약 |
| 세그먼트 | NFIELDS × EMUL ≤ 8, 마지막 레지스터 ≤ v31. 아니면 예약 |
| vill | vtype 의존 명령어는 불법. 전체 레지스터 로드·스토어·vmv<n>r과 vset*은 예외 |
| vstart ≠ 0 | 축약, vcompress, vcpop·vfirst 등은 불법 명령어 예외 |
| 예외 시 vstart | 트랩 난 원소 번호를 vstart에 쓴다(QEMU: 40). 명령어가 끝나면 0으로 |
| first-fault | 원소 0만 트랩, 그 뒤는 vl을 줄이고 계속. vl을 쓰는 경로가 vset* 말고 하나 더 생긴다 |
| LOAD-FP 공유 | width 000·101·110·111은 벡터. V가 없으면 불법. mew=1은 예약 |
| 읽기 포트 | 마스크 연산은 v0를 한 번 더 읽는다. undisturbed면 옛 vd도 읽어야 한다(agnostic이면 생략 가능) |
| vl = 0 | vstart와 상관없이 vd의 원소를 하나도 바꾸지 않는다 |
마지막에서 둘째 줄이 레지스터 파일 크기를 정한다. vadd.vv vd, vs1, vs2, v0.t를 mu로 실행하려면 vs1·vs2·v0·옛 vd 네 개를 읽어야 할 수 있다. 3절의 인덱스 스토어는 데이터·오프셋 두 벡터에 마스크까지 읽는다. 많은 구현이 ta·ma를 이용해 옛 vd 읽기를 생략하고, 마스크 레지스터를 따로 복사해 두는 쪽을 고른다고 알려져 있다(추정).
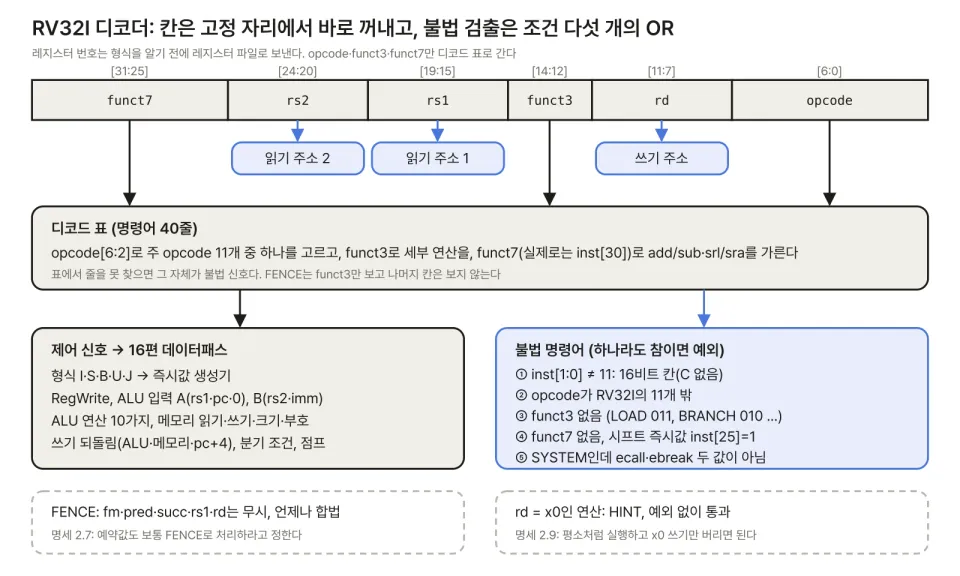
디코더 쪽에서는 "합법인가"가 32비트 명령어만으로 정해지지 않는다는 점을 기억하자. 그룹 정렬과 세그먼트 한계는 vtype.vlmul·vsew가, 축약의 합법성은 vstart가 함께 정한다. 15편의 스칼라 디코더 표에 이 입력을 더하는 것이 벡터 디코더다.
정리
- 조건은 마스크로 바꾼다. 비교가
v0에 원소당 1비트를 쓰고(비트 i = 원소 i), vm=0인 명령어가 그 비트가 1인 원소만 쓴다. 마스크 소스는v0하나다. - 비활성·꼬리 원소는 mu·tu면 지키고, ma·ta면 지키거나 1로 채운다. QEMU 기본은 지켰고,
rvv_*_all_1s를 켜면0xffffffff로 채웠다. agnostic은 이름 바꾸기 코어에서 옛 값 복사를 없애 준다. - 로드·스토어는 단위 보폭·보폭·인덱스·세그먼트 네 가지이고, 벡터 로드는 LOAD-FP opcode를 함께 쓴다. first-fault 로드는 RAM 끝에서 vl을 40으로 줄였고, 보통 로드는 vstart 40으로 트랩을 냈다.
- 마스크 덧셈·게더·합·필터 네 커널이 78개 항목 모두 Python과 같았고, 실행 명령어 수는 VLEN 128에서 스칼라의 31~55%, 1024에서 4~7%였다.
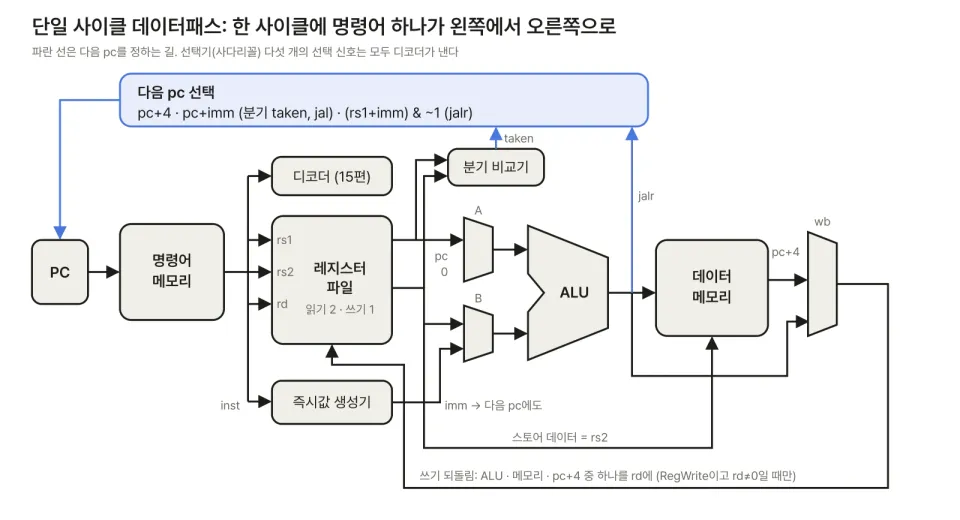
다음 글: 1부(ISA)는 여기서 끝나고, 15편부터 RISC-V 코어를 실제로 만든다. 첫 순서는 디코더다. 2편의 형식 표와 3~14편에서 본 명령어들을 opcode·funct3·funct7 표로 정리하고, 형식을 판별하는 논리, 그리고 없는 opcode·예약된 funct 값·HINT·확장이 꺼졌을 때를 구분하는 불법 명령어 검출을 만든다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 31장 "V" Standard Extension for Vector Operations, Version 1.0: 31.3.4
vtype(vta·vma, vill), 31.3.7vstart, 31.4.5 마스크 배치, 31.5.3 마스킹, 31.5.4 prestart·본체·꼬리, 31.7 로드·스토어(31.7.5 보폭, 31.7.6 인덱스, 31.7.7 first-fault, 31.7.8 세그먼트, 31.7.9 전체 레지스터), 31.14 축약, 31.15 마스크 명령어, 31.16 순열, 31.17 예외 처리. https://github.com/riscv/riscv-isa-manual - RISC-V Vector C Intrinsics 명세 v1.0. https://github.com/riscv-non-isa/rvv-intrinsic-doc
- QEMU RISC-V 문서(
virt보드 메모리 배치, CPU 속성). https://www.qemu.org/docs/master/system/riscv/virt.html - D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 8장 RV32V(비준 이전 초안 기준이라 개념 참고로만)