이 글의 핵심 3줄
- 17편 파이프라인의 남은 손실은 대부분 분기·점프였다. 분기를 EX에서 판단하면 간 분기마다 2사이클을, ID로 앞당기면 1사이클을 잃지만, ID 판단은 비교기·포워딩을 ID로 옮겨야 하고 바로 앞 결과를 비교할 때 스톨이 생긴다. JAL은 디코드만으로 목적지를 알고, JALR은 레지스터 값에 달려 있어 예측이 필요하다.
- 같은 모델에 판단 위치, JAL의 ID 리다이렉트, 정적 예측(뒤로 가면 taken), 명세 2.5의 rd·rs1 힌트를 따르는 리턴 주소 스택(RAS)을 넣어 5개 프로그램의 합계 CPI를 쟀다. 1.368(모두 EX) → 1.332(+JAL ID) → 1.251(+정적 예측) → 1.227(+RAS 8칸), 모두 ID에서 판단하면 1.300이었다.
- RAS 8칸이 fib의
ret21,892개 중 98.3%를 맞혔고, 틀린 예측은 0개였다(모자란 것은 칸이 비었을 때뿐). 정렬 안 된 점프·분기 목적지 다섯 경우는 예외 여부와 mepc·mtval 값이 QEMU와 모두 같았다.
17편에서 포워딩을 넣은 5단 파이프라인의 CPI는 1.37이었고, 1을 넘는 0.37 중 0.36이 분기·점프 때문에 버린 사이클이었다. 이것이 제어 해저드(control hazard)다. 다음 명령어가 어디 있는지 모르는 채로 가져와야 하기 때문에 생긴다. 이 글은 RISC-V의 분기·점프를 파이프라인에서 어떻게 처리하는지 다룬다. 판단을 어느 단에서 하는지, 정적 예측, JAL과 JALR의 차이, 그리고 명세가 레지스터 번호에 숨겨 둔 리턴 주소 스택 힌트다. gshare·TAGE 같은 동적 분기 예측기는 RISC-V에만 해당하는 내용이 아니어서 다른 카테고리로 미룬다.
1. 분기를 어디서 판단하나
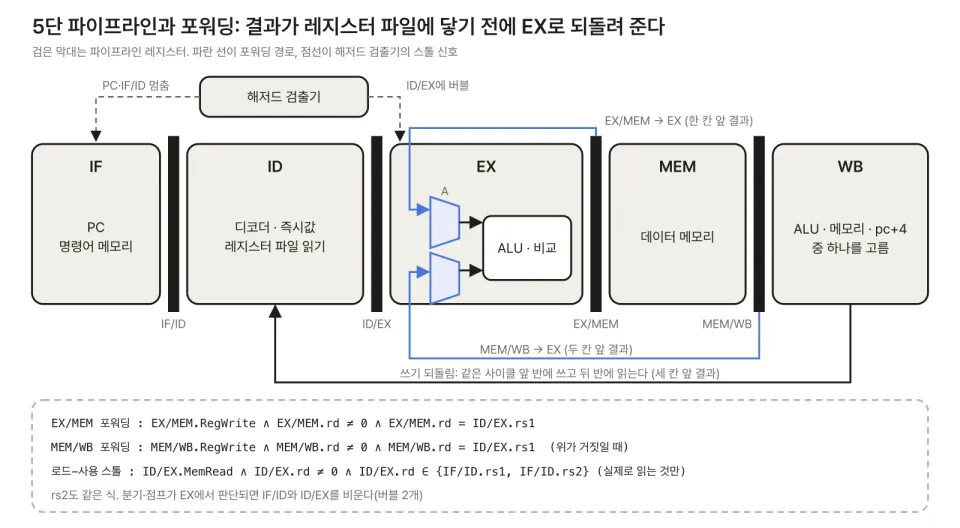
17편 파이프라인은 분기를 EX에서 판단했다. ALU 옆의 비교기가 EX에서 taken을 알고, 그때 IF/ID와 ID/EX에 들어온 두 명령어를 버린다. 간 분기 하나에 2사이클이다.
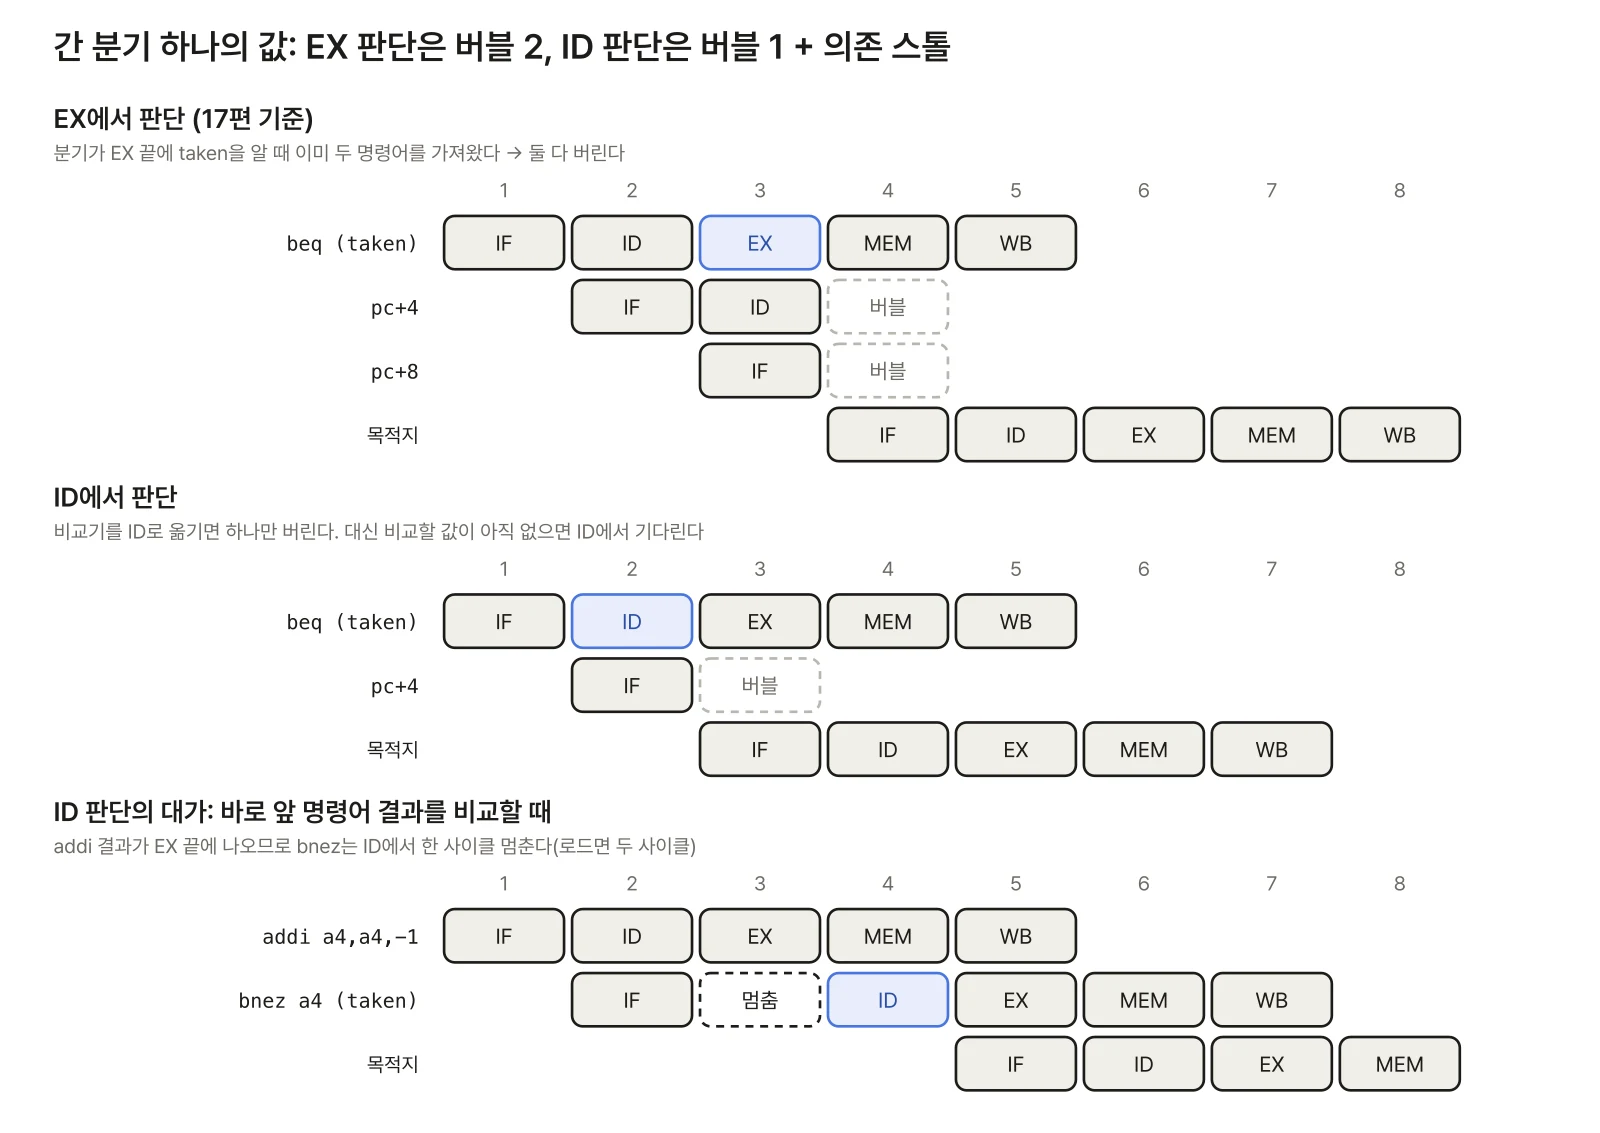
비교기를 ID로 옮기면 버리는 명령어가 하나로 준다. 대가는 세 가지다.
| 대가 | 내용 |
|---|---|
| 하드웨어 | 32비트 비교기(같음·부호 있는·부호 없는 비교)와 pc+imm 덧셈기가 ID로. 포워딩 경로(EX/MEM·MEM/WB → ID)와 그 선택기가 새로 필요 |
| 의존 스톨 | 비교할 값을 바로 앞 명령어가 만들면 그 값은 EX 끝에야 나온다 → 1사이클 멈춤. 로드가 만들면 2사이클 |
| 임계 경로 | ID에 "레지스터 읽기 → 포워딩 선택 → 32비트 비교 → 다음 pc 선택 → PC"가 직렬로 붙는다. ID 단이 가장 긴 단이 되기 쉽다 |
세 번째가 설계에서 가장 아프다. EX에서 판단할 때는 비교기가 ALU와 나란히 있고, 결과는 다음 pc 선택기만 거치면 된다. ID에서 판단하면 레지스터 파일 읽기 시간 위에 비교 시간이 더해진다. 클록 주기가 늘면 CPI에서 얻은 것을 잃는다. 그래서 ID에서 판단하는 설계도 비교를 단순하게 하려고 애쓴다(COD 4.9는 beq의 같음 비교만 ID로 옮기는 예를 든다). RISC-V는 blt·bltu처럼 크기 비교도 있어서 같음 비교만으로는 끝나지 않는다.
손으로 비용을 세어 보자. 17편 CRC-32 안쪽 루프 끝은 이렇다.
800000b4: addi a4,a4,-1
800000b8: bnez a4,800000a0bnez가 바로 앞 addi의 결과를 비교한다. EX 판단에서는 addi의 결과를 EX/MEM 포워딩으로 받아 비교하고, taken이면 2사이클을 버린다. ID 판단에서는 addi가 EX에 있는 동안 bnez가 ID에서 한 사이클 기다리고, 그다음 taken이면 1사이클을 버린다. 합쳐서 2사이클로 똑같다. 이런 루프에서 ID 판단은 이득이 없다.
2. JAL과 JALR
| JAL | JALR | |
|---|---|---|
| 목적지 | pc + J 즉시값 | (rs1 + I 즉시값) & ~1 |
| 언제 알 수 있나 | 디코드하면 (ID) | rs1 값이 있어야 (EX, 또는 포워딩 받는 ID) |
| 주된 쓰임 | 함수 호출 call, 무조건 점프 j |
복귀 ret, 간접 호출, 점프 테이블 |
JAL의 목적지는 명령어 안에 다 있다. 레지스터를 읽을 필요가 없으니 의존 스톨도 없다. ID에서 즉시값을 만들자마자 pc+imm으로 리다이렉트하면 1사이클만 버린다. 이것은 분기 판단 위치와 상관없이 할 수 있는 개선이다. 더 나아가면 IF 단에서 명령어를 미리 들여다보는 프리디코드(predecode)나 분기 목적지 버퍼(BTB)로 0사이클까지 줄일 수 있지만, 이 글의 모델은 ID까지만 다룬다.
JALR은 다르다. 목적지가 레지스터에 있다. 가장 흔한 JALR인 ret(jalr x0, 0(ra))은 함수 끝에서 lw ra, 12(sp)로 ra를 되살린 뒤 몇 명령어 뒤에 나온다. ID에서 계산하려면 ra를 포워딩받아야 하고, 로드가 가까우면 기다려야 한다. EX에서 계산하면 2사이클을 버린다. 어느 쪽이든 손해를 줄이려면 목적지를 레지스터 없이 미리 알아야 하고, 그것이 리턴 주소 스택이다.
JAL·JALR의 목적지가 4의 배수가 아니면 명령어 주소 정렬 예외가 난다(C 확장이 없을 때, 명세 2.5). JALR은 최하위 비트를 지운 뒤에 검사하므로 실제로 보는 것은 bit 1이다. 이 규칙은 5절에서 QEMU와 대조한다.
3. 정적 예측: 뒤로 가면 taken
분기를 기다리는 대신 결과를 짐작하고 먼저 가져오는 것이 예측이다. 지금까지의 "pc+4를 계속 가져오기"도 사실 "언제나 not-taken"이라는 예측이다. 명세 2.5는 소프트웨어 쪽에 이런 권고를 둔다. 자주 지나가는 길을 순서대로 배치하고, 뒤로 가는 분기는 taken, 앞으로 가는 분기는 not-taken으로 예측된다고 가정하라는 것이다. 이것이 BTFN(backward taken, forward not-taken) 정적 예측이다. 하드웨어는 즉시값의 부호 비트(inst[31]) 하나만 보면 된다. 루프의 끝은 뒤로 가는 분기이고, 대부분 반복하니까 맞을 확률이 높다.
모델에서는 ID에서 B 즉시값이 음수면 목적지로 리다이렉트하고(1사이클), 실제 판단은 EX에서 해서 틀리면 2사이클을 버리게 했다. 다섯 프로그램에서 BTFN이 얼마나 맞았는지 단일 사이클 모델의 실행 기록으로 셌다.
| 프로그램 | 뒤로 분기 taken | 앞으로 분기 taken | BTFN 정확도 |
|---|---|---|---|
| qsort | 49.4% (5,687) | 51.6% (790) | 49.3% |
| crc32 | 90.0% (20,494) | 없음 | 90.0% |
| fib | 7/8 | 50.0% (21,891) | 50.0% |
| matmul | 93.5% (67,911) | 7.3% (62,976) | 93.1% |
| sieve | 92.3% (27,252) | 0.0% (7,998) | 94.0% |
qsort가 문제다. while (v[i] < p) i++ 같은 짧은 루프가 많아서 뒤로 가는 분기의 절반 정도만 갔다. 이런 프로그램에서는 BTFN이 not-taken보다 나빠질 수 있다. fib는 n < 2 검사 하나가 앞으로 가는 분기라 반반이다.
4. 리턴 주소 스택과 명세의 힌트
함수 복귀 목적지는 그 함수를 부른 call 바로 다음 주소다. 호출과 복귀는 짝을 이루니, 호출할 때 pc+4를 스택에 넣고(push) 복귀할 때 꺼내면(pop) 레지스터를 읽지 않고도 목적지를 맞힐 수 있다. 이것이 리턴 주소 스택(RAS, return-address stack)이다.
문제는 하드웨어가 "이 JALR이 복귀인가"를 어떻게 아느냐다. 다른 ISA 중에는 점프 명령어에 힌트 비트를 따로 둔 것도 있다. RISC-V는 비트를 쓰지 않고 레지스터 번호로 알린다. 표준 호출 규약의 복귀 주소 레지스터 x1(ra)과 대체 링크 레지스터 x5(t0)가 기준이다. 명세 2.5의 규칙은 다음과 같다.
- JAL: rd가 x1 또는 x5일 때만 push.
- JALR: 아래 표.
| rd가 x1/x5 | rs1이 x1/x5 | rd=rs1 | RAS 동작 |
|---|---|---|---|
| 아니오 | 아니오 | - | 없음 |
| 아니오 | 예 | - | pop |
| 예 | 아니오 | - | push |
| 예 | 예 | 아니오 | pop 후 push |
| 예 | 예 | 예 | push |
실제 코드에 대 보면 다음과 같다.
| 코드 | 인코딩 | RAS |
|---|---|---|
call f |
jal ra, f |
push |
ret |
jalr x0, 0(ra) |
pop |
| 간접 호출 | jalr ra, 0(a5) |
push |
| 점프 테이블 | jalr x0, 0(a5) |
없음 |
| 코루틴 전환 | jalr ra, 0(t0) |
pop 후 push |
| 먼 호출 | auipc ra, … + jalr ra, …(ra) |
push |
마지막 두 줄이 재미있다. rd와 rs1이 서로 다른 링크 레지스터면 "돌아가면서 동시에 부르는" 코루틴 전환이라 pop과 push를 둘 다 한다. 같은 링크 레지스터면 push만 한다. 명세는 그 이유로 lui ra, …; jalr ra, …(ra)와 auipc ra, …; jalr ra, …(ra)를 하나로 합쳐 실행하는 매크로 연산 결합(macro-op fusion)을 든다. 이 쌍은 사실상 "먼 곳 호출"이지 복귀가 아니기 때문이다. x5가 대체 링크 레지스터인 이유도 명세에 있다. 압축 코드에서 레지스터 저장·복원 같은 짧은 루틴(millicode)을 부를 때 ra를 건드리지 않으려는 것이고, x5는 x1과 인코딩이 한 비트만 달라 디코드가 싸다.
모델의 RAS는 ID에서 동작한다. JAL·JALR이 ID를 통과할 때 위 표대로 push·pop하고, pop하는 JALR은 꺼낸 주소로 바로 리다이렉트한다(1사이클). 진짜 목적지는 EX에서 계산해 다르면 다시 리다이렉트한다(2사이클). 스택이 비었으면 예측하지 않는다. 칸이 넘치면 가장 오래된 것을 버린다. 이 5단 파이프라인에서는 분기가 EX에서 판단된 뒤에야 다음 명령어가 ID를 통과하므로, 잘못된 길의 명령어가 RAS를 건드리는 일이 없다. 더 깊은 파이프라인이라면 예측이 틀렸을 때 RAS를 되돌리는 장치가 필요하다.
def _ras_update(self, d, pc):
    rd_l, rs_l = d.rd in (1, 5), d.rs1 in (1, 5)
    pop = (d.j == 'jalr' and rs_l
           and (not rd_l or d.rd != d.rs1))
    push = d.j in ('jal', 'jalr') and rd_l
    top = None
    if pop and self.ras: top = self.ras.pop()
    if push:
        self.ras.append((pc + 4) & 0xFFFFFFFF)
        if len(self.ras) > self.o['ras']: self.ras.pop(0)
    return top
5. 실습: 구성별 CPI와 정렬 예외
17편 모델에 선택 사항을 더해 다섯 구성을 만들었다. 모든 구성에서 다섯 프로그램의 결과가 QEMU와 같았다(UART, pc 열, 최종 레지스터).
| 구성 | 내용 | 합계 CPI |
|---|---|---|
| A | 분기·JAL·JALR 모두 EX (17편) | 1.368 |
| B | A + JAL을 ID에서 | 1.332 |
| C | B + BTFN 정적 예측 | 1.251 |
| D | C + RAS 8칸 | 1.227 |
| E | 분기·JAL·JALR 모두 ID에서 판단 | 1.300 |
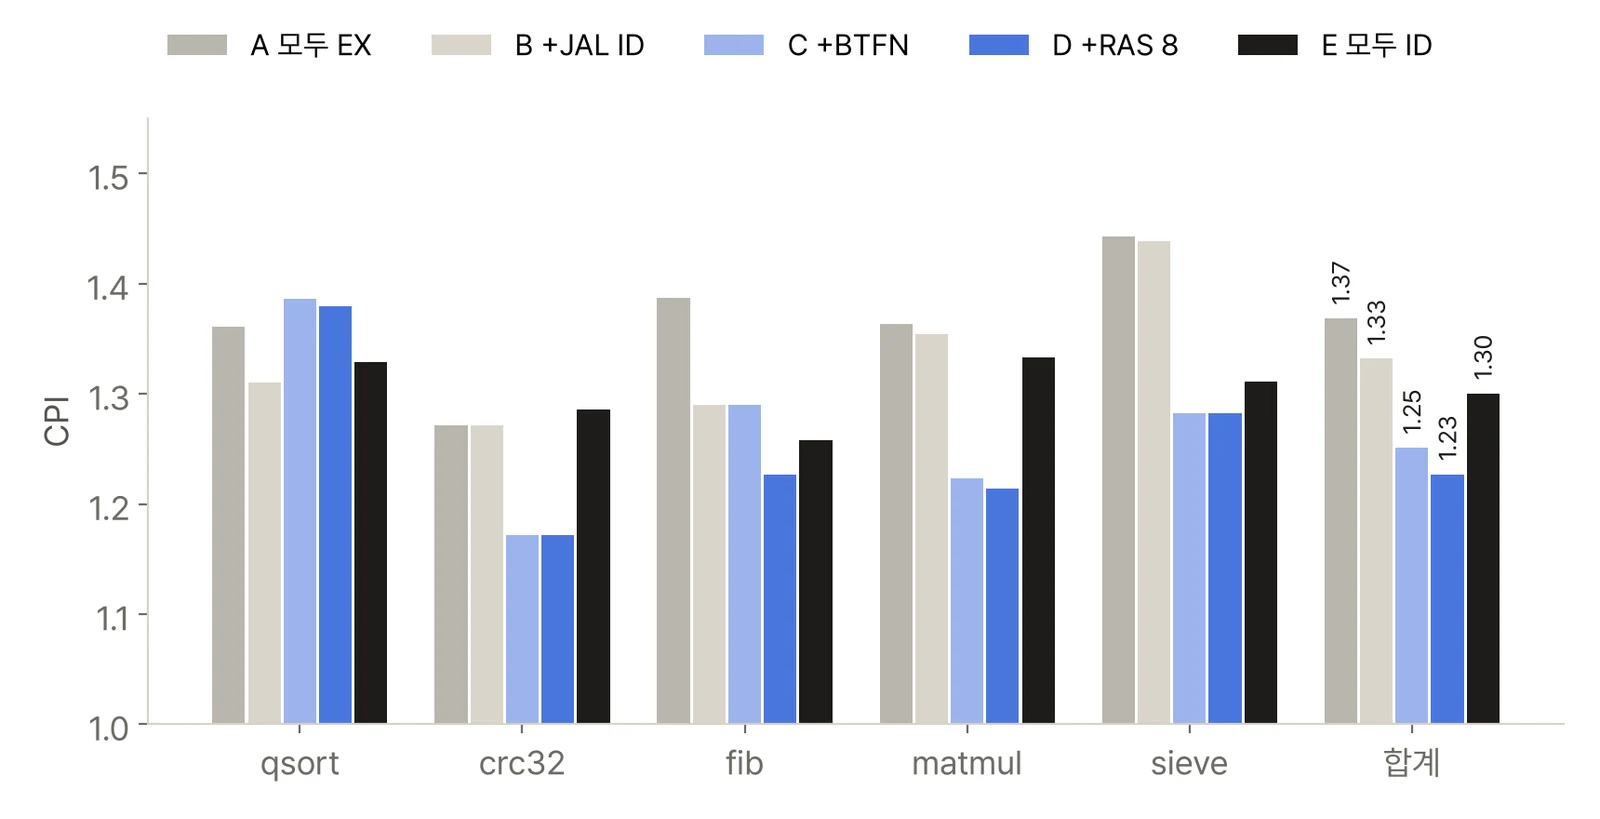
잃은 사이클을 원인별로 보면 각 구성이 무엇을 바꿨는지 보인다(5개 합계, 명령어 1,076,364개).
| 원인 | A | C | D | E |
|---|---|---|---|---|
| 분기 플러시 | 251,732 | 164,724 | 164,724 | 125,866 |
| ID 의존 스톨 | 0 | 0 | 0 | 118,136 |
| JAL 플러시 | 78,862 | 39,431 | 39,431 | 39,431 |
| JALR 플러시 | 52,512 | 52,512 | 26,633 | 26,256 |
- B: JAL을 ID에서. JAL 39,431개가 각각 1사이클씩 덜 버렸다. 디코드에 덧셈기 하나를 더하는 값으로는 가장 쉬운 개선이다.
- C: BTFN. 분기 손실이 87,008사이클 줄었다. crc32·matmul·sieve처럼 루프가 긴 프로그램이 크게 좋아졌고(matmul 1.354 → 1.224), qsort는 1.310에서 1.386으로 나빠졌다. 3절 표 그대로다.
- D: RAS. JALR 손실이 거의 반으로 줄었다. 복귀가 맞으면 1사이클만 버리기 때문이다. fib가 1.290에서 1.227이 됐다.
- E: 모두 ID. 분기 플러시는 125,866(간 분기 하나에 1)으로 가장 적지만 ID 의존 스톨이 118,136사이클 생겼다. 1절의
addi; bnez같은 모양이 그만큼 흔하다는 뜻이다. crc32는 오히려 나빠졌고(1.272 → 1.286), matmul은 1.364에서 1.333으로 조금 좋아지는 데 그쳤다. 게다가 E는 임계 경로가 길어진다. CPI만 보면 C·D가 E보다 낫고, 하드웨어도 ID에 비교기를 두지 않아도 된다.
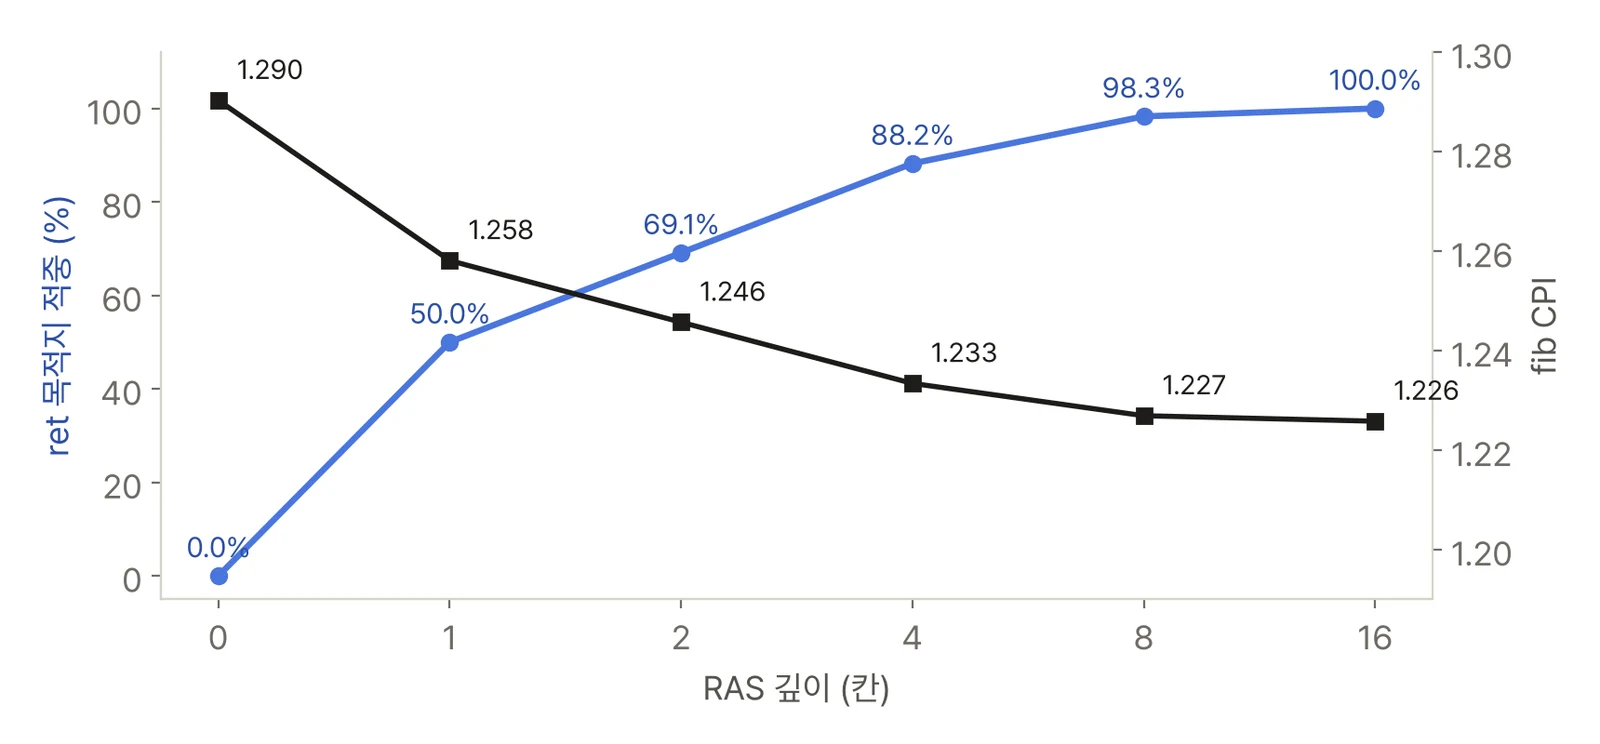
RAS 깊이는 재귀가 깊은 fib로 쟀다. fib(20)의 호출 깊이는 20단 정도라 8칸으로는 가장 깊은 곳에서 복귀할 때 칸이 빈다. 8칸에서 21,892개 중 21,515개(98.3%)를 맞혔고, 남은 377개는 칸이 비어 예측하지 않은 경우였다. 깊이와 상관없이 틀린 예측은 0개였다. 호출 규약을 지키는 코드에서는 push·pop이 정확히 짝을 이루기 때문이다. qsort는 4칸에서 265개 중 259개, 8칸에서 모두 맞혔다.
마지막으로 x0을 다시 확인했다. 17편에서 포워딩 조건의 rd≠0을 빼도 컴파일한 프로그램은 모두 맞았다. 점프가 EX에서 판단되어 점프와 목적지 명령어가 파이프라인 안에서 만나지 않았기 때문이다. 구성 B(JAL만 ID)에서는 여전히 다섯 개가 맞았다. 구성 E에서는 qsort와 fib가 끝나지 않았다. ret이 ID에서 판단되면, 목적지 첫 명령어가 EX에 들어갈 때 ret은 WB에 있다. fib의 마지막 ret 다음 명령어는 main의 li a4,28(addi a4, x0, 28)인데, x0 자리에 ret의 pc+4(0x8000004c)가 포워딩되어 출력 루프의 반복 횟수가 망가졌다. 판단 위치를 바꾸는 것만으로 숨어 있던 버그가 드러난 것이다.
정렬 안 된 목적지는 다섯 경우를 어셈블리로 짜서 QEMU(-cpu rv32,c=false, C 확장을 꺼야 정렬 예외가 난다)와 비교했다. QEMU는 -d int 로그에서 예외 원인·mepc·mtval을 꺼냈다.
| 경우 | QEMU | 모델(단일·EX·ID) |
|---|---|---|
| 안 간 분기, 목적지 pc+6 | 예외 없음 | 예외 없음 |
jalr, 목적지 라벨+1 |
예외 없음 | 예외 없음 |
jalr, 목적지 라벨+2 |
mepc 0x8000002c |
같음 |
| 간 분기, 목적지 pc+6 | mepc 0x80000024 |
같음 |
jal, 목적지 pc+6 |
mepc 0x80000024 |
같음 |
예외가 난 세 경우 모두 원인은 0(명령어 주소 정렬), mepc는 점프·분기 명령어 자신의 주소, mtval은 정렬 안 된 목적지였다(jalr은 0x80000032, 나머지 둘은 0x8000002a). 두 번째 줄이 명세 그대로다. 라벨+1은 홀수지만 JALR이 최하위 비트를 지우므로 정렬된 주소가 된다. 첫 줄도 명세 그대로다. 분기가 가지 않으면 목적지가 이상해도 예외가 없다. 그래서 정렬 검사는 taken이 정해진 뒤에야 할 수 있고, 판단 위치(EX 또는 ID)에서 함께 해야 한다.
6. 설계 체크리스트: 분기·점프
| 항목 | 규칙 |
|---|---|
| 분기 판단 위치 | EX: 간 분기마다 2사이클. ID: 1사이클 + 의존 스톨(앞 ALU 1, 앞 로드 2), ID에 비교기·포워딩, 임계 경로 증가 |
| JAL | 목적지가 명령어 안에 있다. ID에서 리다이렉트(1사이클), 프리디코드·BTB면 0 |
| JALR 목적지 | (rs1+imm)의 bit 0을 지운 값. imm은 2배 하지 않는다 |
| 정렬 예외 | taken 분기·JAL·JALR의 목적지 bit 1이 1이면(C 없을 때) 그 점프에서 예외. mepc=점프 pc, mtval=목적지. 안 간 분기는 검사하지 않는다 |
| 링크 값 | rd ← pc+4. rd=x0이어도 파이프라인 안에서는 pc+4가 실려 다닌다(포워딩에 rd≠0 필수) |
| 정적 예측 | BTFN은 inst[31]만 보면 된다. 짧은 루프가 많은 코드에서는 not-taken보다 나쁠 수 있다 |
| RAS push | JAL·JALR의 rd가 x1 또는 x5 |
| RAS pop | JALR의 rs1이 x1 또는 x5이고, rd가 링크 레지스터가 아니거나 rd≠rs1 |
| rd=rs1=링크 | push만(auipc ra; jalr ra, …(ra) 결합 대비) |
| RAS 넘침·빔 | 흔한 선택은 원형 버퍼(오래된 것 덮어쓰기), 비면 예측하지 않음. 깊은 파이프라인은 잘못된 길에서의 갱신을 되돌려야 한다 |
| 예측 검증 | 예측한 다음 pc를 파이프라인 레지스터에 싣고, 판단 단에서 실제 값과 비교해 다르면 플러시 |
정리
- 분기를 EX에서 판단하면 간 분기마다 2사이클, ID에서 판단하면 1사이클을 잃는다. ID 판단은 비교기·포워딩을 ID로 옮겨야 하고 의존 스톨과 긴 임계 경로를 부른다. 이번 측정에서는 의존 스톨이 118,136사이클로 아낀 플러시를 대부분 상쇄했다.
- JAL은 디코드에서 목적지를 알아 ID 리다이렉트로 1사이클이면 되고, JALR은 레지스터에 의존해 예측이 필요하다. 목적지가 4의 배수가 아니면 그 점프에서 예외이고, QEMU와 다섯 경우가 같았다.
- 명세 2.5는 RAS의 push·pop을 rd·rs1이 x1/x5인지로 정한다. RAS 8칸이 fib 복귀의 98.3%를 맞혔고 틀린 예측은 없었다.
- 합계 CPI는 1.368(모두 EX) → 1.332(+JAL ID) → 1.251(+BTFN) → 1.227(+RAS)이었고, 모두 ID에서 판단하면 1.300이었다.
다음 글: 19편에서는 M 확장을 구현한다. 곱셈기와 나눗셈기를 파이프라인에 어떻게 붙이는지(여러 사이클 걸리는 연산과 스톨), 그리고 명세가 정한 0 나누기·오버플로 결과를 그대로 만드는 방법을 본다. 16편에서 matmul의 분기 31%를 만든 __mulsi3 반복문이 mul 하나로 바뀌면 이 묶음의 숫자가 어떻게 달라지는지도 잰다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 2.5 제어 이동 명령어(JAL·JALR, 리턴 주소 스택 힌트 표, 정렬 예외, 정적 예측 권고). https://github.com/riscv/riscv-isa-manual
- The RISC-V Instruction Set Manual, Volume II: Privileged Architecture, Version 20240411. 3장 기계 수준 ISA(mcause 예외 코드, mepc, mtval)
- D. Patterson, J. Hennessy, Computer Organization and Design: RISC-V Edition, 2판, 2020. 4.9 제어 해저드(분기 판단을 ID로 옮기기, 정적 예측)
- D. Harris, S. Harris, Digital Design and Computer Architecture: RISC-V Edition, 2021. 7.5.3 해저드(제어 해저드)
- QEMU RISC-V CPU 속성(
-cpu rv32,c=false)과 로그(-d int). https://www.qemu.org/docs/master/system/target-riscv.html