이 글의 핵심 3줄
- RISC-V 벡터 확장(V)은 레지스터 폭을 ISA에 박지 않는다. 벡터 레지스터 32개의 길이 VLEN은 구현이 정하고, 프로그램은
vsetvli로 "남은 원소가 n개, 원소는 32비트"라고 알려 이번에 처리할 개수 vl을 하드웨어에게서 받는다. - 한 번에 다루는 최대 원소 수는 VLMAX = VLEN / SEW × LMUL이다. SEW는 원소 폭, LMUL은 레지스터를 몇 개 묶어 쓸지(1/8~8)를 뜻한다. 이 셋과 vl이 벡터 명령어 전부의 동작을 정한다.
- 정수 100개를 더하는 같은 기계어를 QEMU의 VLEN 128·256·512·1024에서 돌리니 루프가 25·13·7·4번 돌았고 실행 명령어는 313·169·97·61개였다(스칼라 루프는 813개). 결과는 네 경우 모두 Python 기준과 같았다.
1편에서 V를 한 글자 확장 목록의 하나로, 그리고 RVA23 프로파일이 필수로 넣은 확장으로만 짚고 넘어갔다. 2~5편의 기본 정수 ISA, 7편의 곱셈, 10편의 부동소수점, 11편의 압축 명령어는 모두 한 번에 값 하나를 다루는 스칼라 명령어였다. 12편의 B 확장도 한 레지스터 안의 비트를 다룰 뿐이다. 13·14편은 한 명령어로 원소 수십 개를 처리하는 V 확장을 다룬다. 이번 편은 그 바탕인 벡터 레지스터와 vtype·vl, 그리고 같은 코드가 어떤 폭의 하드웨어에서도 도는 원리(벡터 길이에 묶이지 않는 코드)를 본다. 마스크·로드스토어 종류·축약·순열은 14편이다. 근거는 비특권 명세 20240411 판의 31장 "V" Standard Extension for Vector Operations, Version 1.0이다.
1. 왜 고정 폭 SIMD가 아닌가
x86의 SSE는 128비트, AVX는 256비트, AVX-512는 512비트 레지스터를 쓴다. 폭이 바뀔 때마다 새 명령어와 새 레지스터가 생겼고, 프로그램도 다시 컴파일하거나 폭마다 따로 짜야 했다. 고정 폭 SIMD에는 꼬리 문제도 있다. 원소 100개를 4개씩 처리하면 25번으로 딱 떨어지지만, 102개라면 남는 2개를 스칼라 루프로 따로 처리해야 한다.
RISC-V V는 레지스터 폭을 ISA에 적지 않는다. 폭 VLEN은 구현이 정하는 상수이고, 코드는 그 값을 몰라도 된다. 루프가 매번 "남은 원소 수"를 하드웨어에 알려 주면 하드웨어가 "이번에는 vl개 하겠다"고 답한다. 넓은 하드웨어는 한 번에 많이, 좁은 하드웨어는 조금씩 처리하고, 마지막 반복에서 vl이 남은 수만큼 줄어 꼬리도 따로 처리할 필요가 없다. 1970년대 Cray 같은 벡터 컴퓨터의 방식(벡터 길이 레지스터)을 되살린 것이다.
설계자 쪽에서 보면 이 결정은 선택지를 넓힌다. 작은 MCU는 VLEN=128에 원소를 한 사이클에 하나씩 처리해도 되고, 서버 코어는 VLEN=512에 레인을 여러 개 둘 수도 있다. 둘 다 같은 바이너리를 돌린다.
2. 벡터 레지스터와 VLEN·ELEN
V 확장은 벡터 레지스터 32개(v0~v31)를 더한다. 정수·FP 레지스터와 따로 있는 새 레지스터 파일이다. 레지스터마다 VLEN비트이고, 구현이 정하는 상수는 둘이다.
- VLEN: 벡터 레지스터 하나의 비트 수. 2의 거듭제곱이고 2^16 이하다.
- ELEN: 연산 하나가 다룰 수 있는 원소의 최대 비트 수. 2의 거듭제곱이고 8 이상, VLEN 이하다.
정식 V 확장(31.18의 표준 벡터 확장 중 V)은 VLEN ≥ 128, ELEN = 64를 요구한다. 그보다 작은 임베디드용 묶음은 Zve32x·Zve64d 같은 이름으로 따로 있다. 실제로 -march=rv64gcv로 컴파일한 ELF의 확장 문자열에는 zvl128b(VLEN ≥ 128 보장)와 zve64d가 들어 있었다.
벡터 상태를 담는 CSR은 일곱 개다.
vstart  0x008  예외 뒤 다시 시작할 원소 번호
vxsat   0x009  고정소수점 포화 플래그
vxrm    0x00A  고정소수점 반올림 모드
vcsr    0x00F  vxrm·vxsat 묶음
vl      0xC20  이번에 처리할 원소 수 (읽기 전용)
vtype   0xC21  SEW·LMUL·정책 (읽기 전용)
vlenb 0xC22 VLEN/8 (읽기 전용 상수)vl과 vtype은 CSR 명령어로 쓸 수 없다. 오직 vsetvli 계열 명령어(그리고 14편의 first-fault 로드)만 바꾼다. vlenb를 읽어 보니 QEMU의 VLEN 128·256·512·1024에서 각각 16·32·64·128이 나왔다.
벡터 유닛은 꺼진 채로 시작할 수 있다. mstatus.VS(비트 10:9)가 0(Off)이면 벡터 명령어와 벡터 CSR 접근이 모두 불법 명령어 예외다. FP의 mstatus.FS와 같은 구조로, 운영체제가 벡터를 쓰지 않는 프로세스에서 레지스터 32×VLEN비트를 저장·복원하지 않게 해 준다. 그래서 이번 실습의 시작 코드는 main 전에 csrs mstatus로 VS를 1(Initial)로 켰다. 끈 채로 vsetvli를 실행하면 7절처럼 mcause=2가 나왔다.
3. SEW·LMUL·VLMAX
레지스터 하나를 몇 비트 원소로 나눌지가 SEW(selected element width)다. 8·16·32·64비트 중 고른다. 그리고 레지스터 몇 개를 한 묶음(레지스터 그룹)으로 쓸지가 LMUL(length multiplier)이다. 1·2·4·8이면 레지스터를 묶고, 1/2·1/4·1/8이면 레지스터의 일부만 쓴다. 한 명령어가 다룰 수 있는 최대 원소 수는 다음과 같다.
레지스터 비트 수를 원소 폭으로 나누면 레지스터 하나에 든 원소 수이고, 거기에 묶은 레지스터 수를 곱한 것이다. VLEN=128, SEW=32, LMUL=4라면 128/32×4 = 16이다.
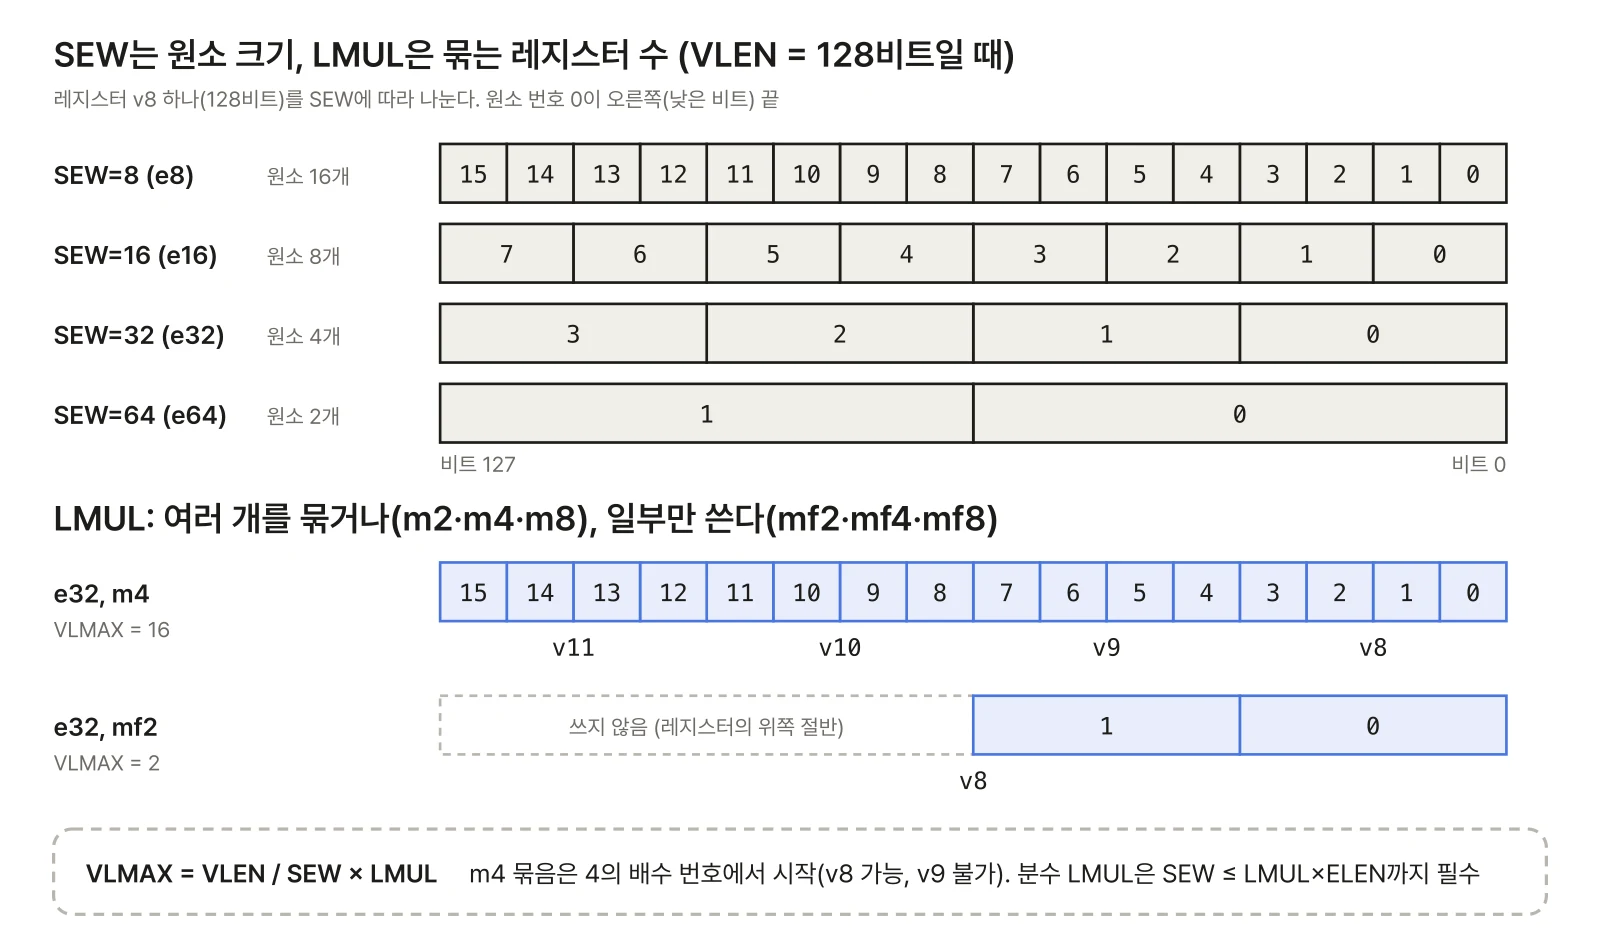
LMUL=4일 때 그룹 이름은 맨 아래 레지스터 번호로 부른다. v8이라고 쓰면 v8~v11이고, 원소 0~3이 v8, 4~7이 v9에 차례로 놓인다. 그래서 그룹은 LMUL의 배수 번호에서만 시작할 수 있다. LMUL=2인데 v1을 쓰면 예약된 인코딩이다.
분수 LMUL은 폭이 다른 원소를 섞을 때 쓴다. 8비트를 32비트로 넓히는 연산을 생각해 보자. e32·m1의 VLMAX가 4라면, 같은 원소 4개를 담는 8비트 쪽은 128비트 레지스터의 1/4만 있으면 된다(e8·mf4, VLMAX = 128/8×1/4 = 4). 분수 LMUL이 없으면 좁은 쪽이 레지스터 하나를 통째로 차지해 나머지를 버리거나, 넓은 쪽이 레지스터를 여럿 묶어야 한다.
QEMU에서 vsetvl로 SEW 네 가지 × LMUL 일곱 가지를 모두 설정하고 돌려받은 VLMAX다.
| 설정 | VLEN 128 | VLEN 512 | 비고 |
|---|---|---|---|
| e8, m1 | 16 | 64 | |
| e8, mf8 | 2 | 8 | 가장 작은 단위 |
| e32, m1 | 4 | 16 | |
| e32, m4 | 16 | 64 | v8~v11 묶음 |
| e32, mf2 | 2 | 8 | |
| e32, mf4 | vill | vill | 32 > 1/4 × 64 |
| e64, m8 | 16 | 64 | |
| e64, mf2 | vill | vill | 64 > 1/2 × 64 |
명세는 분수 LMUL에서 SEW ≤ LMUL × ELEN인 조합만 반드시 지원하라고 한다. 그 밖의 조합은 구현이 지원하지 않아도 되고, 지원하지 않는 vtype을 받으면 vtype.vill 비트를 세운다. QEMU는 28개 조합 중 정확히 이 규칙을 벗어난 6개(e16·mf8, e32·mf8, e32·mf4, e64·mf8~mf2)에서 vill을 세웠고, 나머지 22개의 VLMAX는 네 VLEN 모두에서 위 식과 같았다.
4. vtype 인코딩과 vsetvli 세 형태
vtype CSR의 비트 배치는 다음과 같다.
비트      이름    뜻
XLEN-1    vill    지원하지 않는 설정이면 1
XLEN-2:8  (예약)  0이어야 한다
7         vma     마스크 정책 (14편)
6         vta     꼬리 정책 (14편)
5:3       vsew    000 e8, 001 e16, 010 e32, 011 e64
2:0       vlmul   000 m1, 001 m2, 010 m4, 011 m8,
101 mf8, 110 mf4, 111 mf2vlmul의 100은 예약이다. 이 값을 설정 명령어 세 가지가 쓴다. 셋 다 opcode OP-V(1010111)에 funct3 111을 쓰고, 맨 위 비트로 구분한다.
vsetvli  rd, rs1, vtypei  [31]=0, [30:20]=vtypei(11비트)
vsetivli rd, uimm, vtypei [31:30]=11, [29:20]=vtypei,
                          [19:15]=uimm(AVL 0~31)
vsetvl   rd, rs1, rs2     [31:25]=1000000, rs2=vtype
vsetvli t0, x0, e32, m1, ta, ma를 손으로 인코딩해 보자. vtypei는 vma=1, vta=1, vsew=010, vlmul=000이라 1101 0000 = 0x0d0이다. 여기에 rs1=0, funct3=111, rd=5(t0), opcode=1010111을 붙인다.
[31] [30:20]      rs1   f3  rd    opcode
 0   00011010000 00000 111 00101 1010111
= 0x0d0072d7
7절에서 VS를 끄고 이 명령어를 실행했을 때 QEMU가 mtval에 남긴 값이 정확히 0x0d0072d7이었다.
AVL(application vector length, 처리하고 싶은 원소 수)은 rs1 레지스터 값이다. 레지스터 번호가 x0일 때는 뜻이 바뀐다.
- rs1 = x0, rd ≠ x0: AVL을 무한대(~0)로 본다. 결과 vl = VLMAX. "이 설정의 VLMAX를 알려 줘"라는 관용구다.
- rs1 = x0, rd = x0: 지금 vl을 그대로 두고
vtype만 바꾼다. VLMAX가 바뀌는 경우는 예약이다.
vsetivli는 AVL을 5비트 즉시값으로 준다. 원소 수가 작고 정해져 있을 때(예: 4×4 행렬) 레지스터를 아낀다. vsetivli rd, 31, e8, mf8의 결과는 VLEN 128에서 2, 1024에서 16이었다. AVL 31보다 VLMAX가 작으니 VLMAX가 나온 것이다. vsetvl은 vtype을 레지스터로 받는다. 문맥 전환 후 복원처럼 설정을 실행 중에 정할 때 쓴다. 이번 실습의 28개 조합 시험도 vsetvl로 루프를 돌렸다.
5. AVL에서 vl이 정해지는 규칙
vsetvli는 AVL과 VLMAX를 보고 vl을 정해 rd와 vl CSR에 쓴다. 명세의 규칙(31.6.3)은 셋이다.
남은 원소가 VLMAX 이하이면 그만큼만 처리한다. VLMAX의 두 배 이상 남았으면 꽉 채워 처리한다. 그 사이에서는 구현에게 자유를 준다. AVL이 VLMAX보다 조금 많을 때, 이번에 VLMAX를 다 쓰면 다음 반복에 몇 개만 남는다. 대신 반씩 나누면 두 반복의 일이 고르게 된다. 명세는 이 선택을 구현에 맡겼다. 또 같은 AVL·vtype이면 언제나 같은 vl이 나와야 한다(결정적).
VLEN 128, e32·m1(VLMAX=4)에서 AVL 0~40을 넣어 본 결과다.
| AVL | 명세가 허용하는 vl | QEMU |
|---|---|---|
| 0~4 | AVL 그대로 | 0~4 |
| 5 | 3~4 | 4 |
| 6 | 3~4 | 4 |
| 7 | 4 | 4 |
| 8 이상 | 4 | 4 |
QEMU는 언제나 vl = min(AVL, VLMAX)를 골랐다. 네 VLEN에서 AVL 41개씩, 164개가 모두 이 식과 같았다. 실제 하드웨어는 다른 값을 고를 수 있으니, 코드는 vl을 반드시 돌려받은 값으로 써야 한다. "VLMAX씩 줄어든다"고 가정한 코드는 다른 칩에서 틀린다. AVL=0이면 vl=0이고, vl=0인 벡터 명령어는 원소를 하나도 건드리지 않는다.
6. 스트립 마이닝: 길이에 묶이지 않는 루프
긴 배열을 vl개씩 잘라 처리하는 방식을 스트립 마이닝(strip mining)이라 한다. c[i] = a[i] + b[i]를 intrinsics로 짠 루프를 GCC 16.2가 이렇게 컴파일했다(루프 부분).
loop:
  vsetvli a5, a3, e32, m1, ta, ma  # vl = f(남은 n)
  vle32.v v1, (a1)       # a에서 vl개
  vle32.v v2, (a2)       # b에서 vl개
  vadd.vv v1, v1, v2
  vse32.v v1, (a4)       # c에 vl개
  slli    a6, a5, 2      # 바이트 수 = vl*4
  add     a1, a1, a6
  add     a2, a2, a6
  add     a4, a4, a6
  sub     a3, a3, a5     # n -= vl
  addi    a0, a0, 1      # 반복 횟수 세기
  bnez    a3, loop
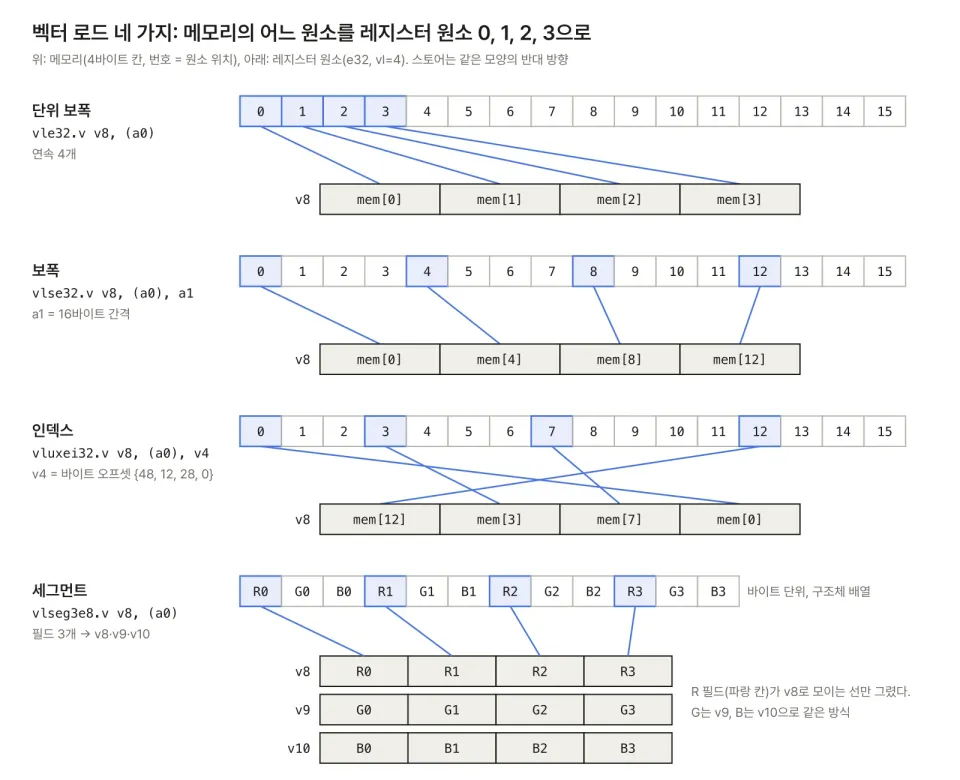
이 12개 명령어 어디에도 VLEN이 없다. vle32.v는 단위 보폭(unit-stride) 로드로, 주소에서 4바이트 원소 vl개를 연속으로 읽어 레지스터 그룹의 원소 0부터 채운다. vse32.v는 그 반대다. 원소 폭은 명령어에 적힌 EEW(여기서는 32)를 쓰고, 개수는 vl을 따른다. 로드·스토어의 다른 종류는 14편에서 본다.
vsetvli의 결과 a5가 포인터 증가량과 남은 수 감소량을 정한다. 하드웨어가 vl을 몇으로 고르든 루프는 맞게 끝난다. 원소 100개를 넣으면 반복마다 vl은 이렇게 됐다.
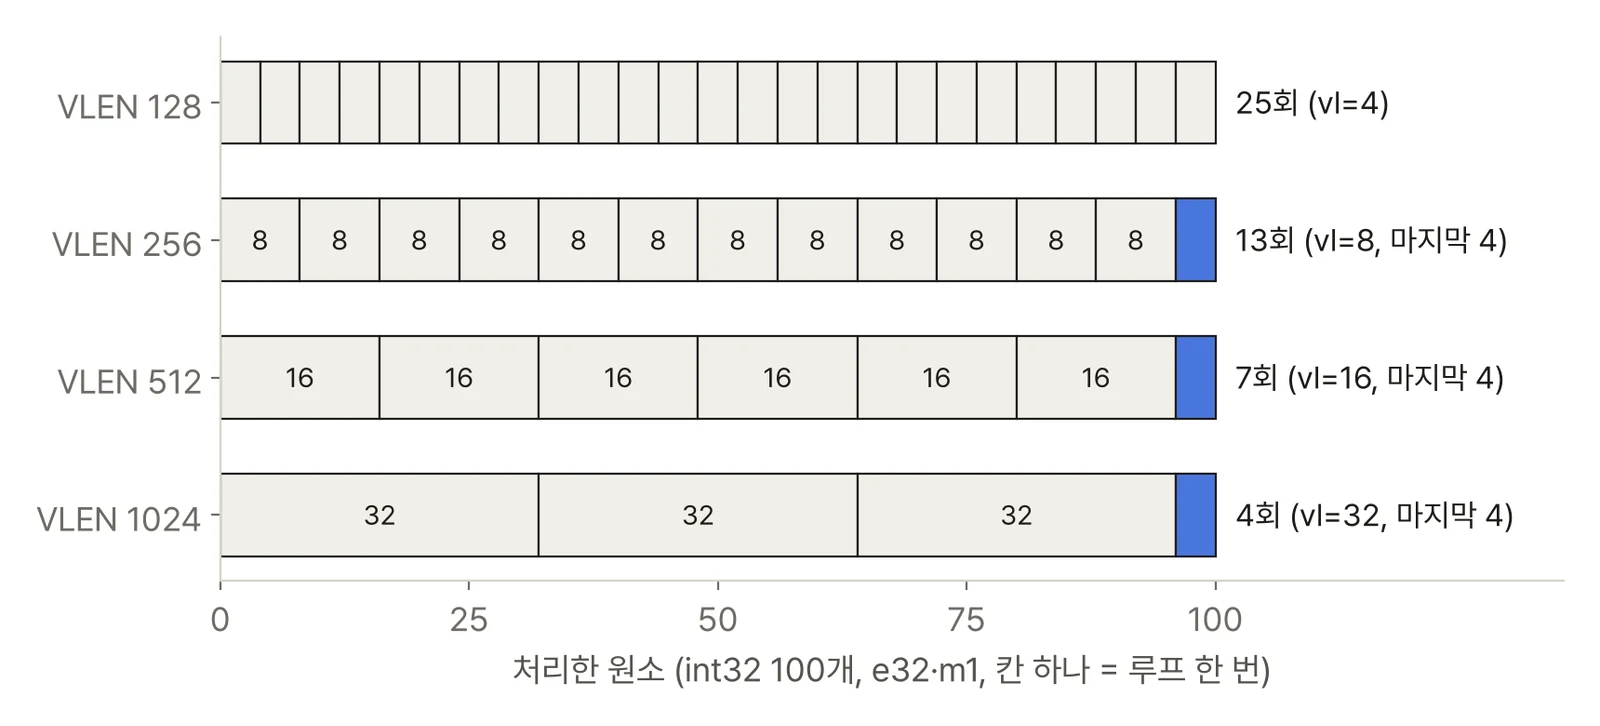
마지막 반복에서 vl이 남은 4로 줄었다. 고정 폭 SIMD라면 이 4개를 스칼라 꼬리 루프로 처리했을 것이다.
7. 실습: 같은 기계어를 VLEN 네 가지로
vlen.c 하나를 -march=rv64gcv -mabi=lp64d -O1로 한 번만 빌드하고, 같은 ELF를 QEMU 11.1.3 virt의 -cpu rv64,v=true,vlen=N,elen=64로 VLEN만 바꿔 돌렸다(.text의 sha256 앞 16자 b32fb1ef7eb4fe84). riscv_vector.h는 컴파일러가 주는 헤더라 newlib 없이 -ffreestanding에서도 그대로 컴파일됐다. 실행 명령어 수는 QEMU를 -icount shift=0으로 돌려 minstret을 함수 앞뒤에서 읽은 차이다. 장비는 맥 M1 Max, 컴파일러는 riscv64-elf-gcc 16.2다.
uint64_t vadd_m1(int32_t *c, const int32_t *a,
                 const int32_t *b, size_t n) {
  uint64_t it = 0;
  while (n) {
    size_t vl = __riscv_vsetvl_e32m1(n);
    vint32m1_t x = __riscv_vle32_v_i32m1(a, vl);
    vint32m1_t y = __riscv_vle32_v_i32m1(b, vl);
    __riscv_vse32_v_i32m1(c,
        __riscv_vadd_vv_i32m1(x, y, vl), vl);
    a += vl; b += vl; c += vl; n -= vl; it++;
  }
  return it;
}vadd_m4는 이름의 m1을 m4로 바꾼 것뿐이고, vcopy는 e8·m8로 1,000바이트를 복사한다. 스칼라 비교 대상은 같은 덧셈을 자동 벡터화를 끄고 컴파일한 루프다(원소당 명령어 8개).
| VLEN | m1 반복 (명령어) | m4 반복 (명령어) | 복사 1000B 반복 |
|---|---|---|---|
| 128 | 25 (313) | 7 (97) | 8 |
| 256 | 13 (169) | 4 (61) | 4 |
| 512 | 7 (97) | 2 (37) | 2 |
| 1024 | 4 (61) | 1 (25) | 1 |
m1 명령어 수는 언제나 12 × 반복 + 13이다. 반복당 12개는 위 루프이고, 13개는 호출·복귀와 루프 앞뒤다. 스칼라 루프는 VLEN과 상관없이 813개였다. VLEN이 두 배가 될 때마다 반복이 거의 반으로 줄고, LMUL=4는 레지스터 넷을 묶어 같은 VLEN에서 VLMAX를 네 배로 늘린다. m4는 레지스터를 8개(a·b용 그룹 둘)나 쓰니, 레지스터가 모자라는 큰 루프에서는 m1이 나을 수 있다.
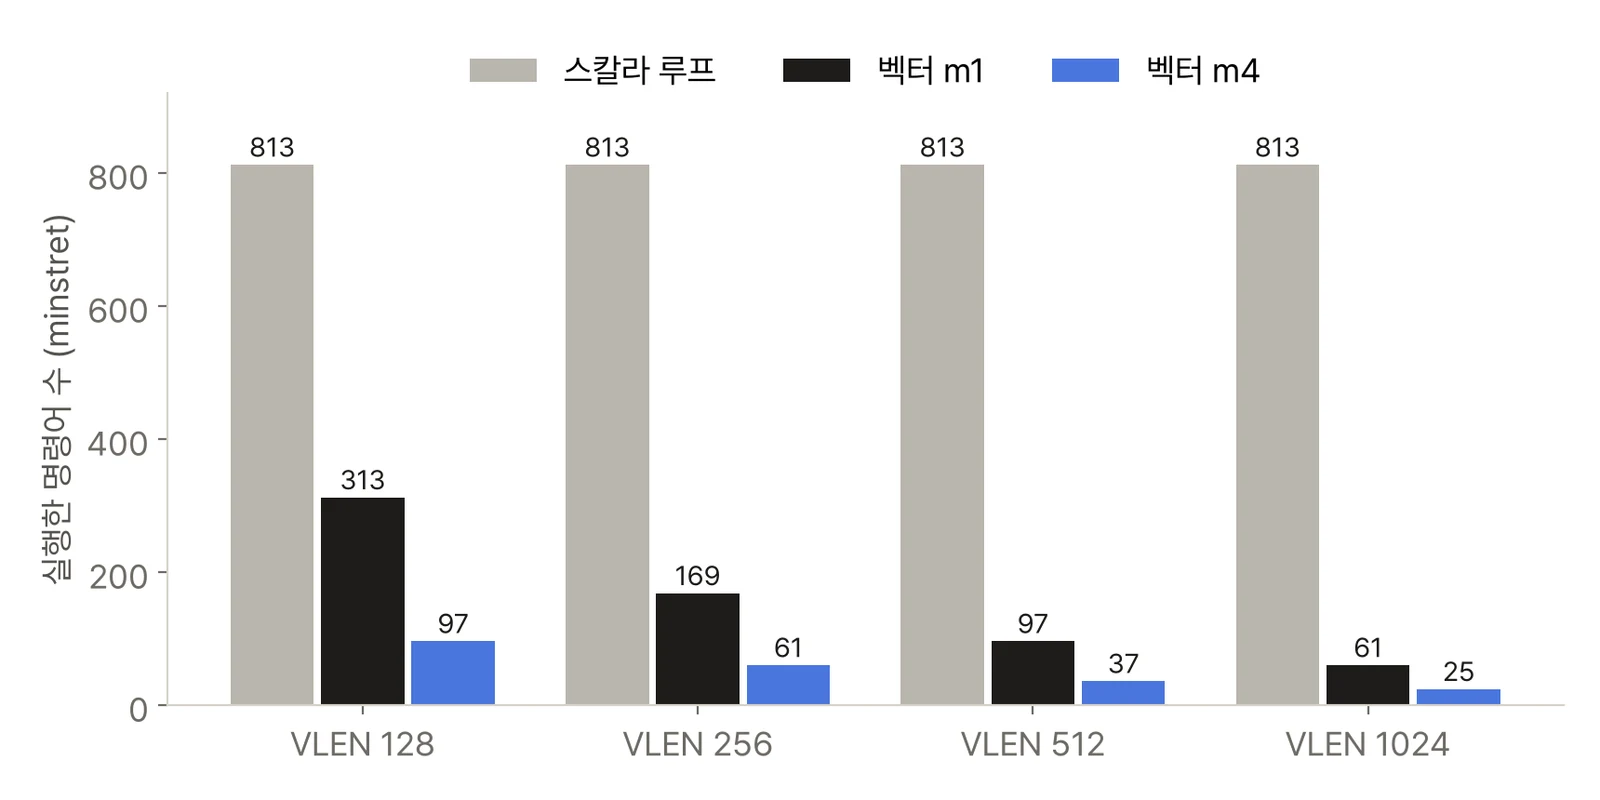
여기서 명령어 수는 성능이 아니다. QEMU는 벡터 명령어 하나를 명령어 하나로 센다. 실제 하드웨어에서 vadd.vv 하나가 몇 사이클 걸리는지는 레인 수에 달렸다. VLEN=512인데 레인이 하나라면 원소 16개를 16사이클에 처리할 수도 있다(추정). 다만 명령어를 가져오고 디코드하는 횟수가 줄어드는 것은 레인 수와 상관없는 이득이다.
출력은 Python 기준 모델과 대조했다.
| 시험 | 개수 | 일치 |
|---|---|---|
| VLMAX·vill (28 조합 × VLEN 4) | 112 | 112 |
| AVL → vl (41 × VLEN 4) | 164 | 164 |
| 반복 횟수·vl 순서 | 16 | 16 |
| 덧셈 결과 100개, 복사 1000B | 8 | 8 |
불법인 경우 네 가지도 트랩 처리기로 확인했다. 처리기는 mcause·mtval을 적고 mepc를 4 늘려 다음 명령어로 돌아간다.
| 경우 | 결과 |
|---|---|
VS=Off에서 vsetvli |
mcause 2, mtval 0x0d0072d7 |
m2에서 vadd.vv v1,v2,v4 |
mcause 2 (v1이 홀수) |
e64·mf8을 vsetvl |
vl 0, vtype 0x8000…0(vill) |
vill 상태에서 vadd.vv |
mcause 2 |
둘째 줄은 흥미롭다. GNU as는 vadd.vv v1,v2,v4를 아무 경고 없이 0x022200d7로 인코딩했다. 어셈블러는 실행 때의 LMUL을 모르기 때문이다. 같은 기계어가 m1에서는 합법이고 m2에서는 불법이다. 같은 자리에서 vadd.vv v2,v4,v6(모두 짝수)는 트랩이 나지 않았다. vtype의 예약 비트 8을 1로 해서 vsetvl해도 vill이 섰다.
8. 설계 체크리스트: vtype·vl과 디코더
| 항목 | 규칙 |
|---|---|
| VS=Off | 벡터 명령어와 벡터 CSR 접근(vl·vtype·vlenb 읽기 포함) 모두 불법 명령어 |
| VS 갱신 | 벡터 레지스터나 벡터 CSR을 바꾸면 VS를 Dirty(3)로 |
vl·vtype 쓰기 |
CSR 명령어로 쓰면 불법(읽기 전용). vset*과 first-fault 로드만 쓴다 |
| vill 판정 | vsew·vlmul 예약값, 예약 비트 ≠ 0, 지원 안 하는 분수 LMUL이면 vill=1, 나머지 비트 0, vl=0 |
| vill 이후 | vtype에 의존하는 벡터 명령어는 불법. vset*과 전체 레지스터 로드·스토어·이동은 실행 가능 |
| AVL 규칙 | VLMAX < AVL < 2·VLMAX 구간은 구현 선택. 흔한 선택은 min(AVL, VLMAX)(QEMU) |
| x0 특례 | rs1=x0이면 AVL=~0(rd≠x0) 또는 vl 유지(rd=x0). rs1 값을 읽기 전에 레지스터 번호로 판별 |
| 그룹 정렬 | 레지스터 번호가 LMUL의 배수가 아니면 불법. 디코더 혼자 못 정하고 vtype.vlmul을 함께 봐야 한다 |
| 리셋 | vill=1, 나머지 0, vl=0을 권장(명세가 강제하지는 않음) |
vlenb |
VLEN/8 상수. 하드웨어에서는 배선된 상수 |
그룹 정렬 줄이 벡터 디코더를 스칼라 디코더와 다르게 만든다. 스칼라는 32비트만 보고 합법 여부를 정하지만, 벡터는 현재 vtype(LMUL, 그리고 vill)이 디코드 입력이 된다. 파이프라인 코어라면 앞서 가는 vsetvli가 아직 vtype을 쓰지 않았을 수 있다. vtype을 레지스터처럼 이름 바꾸기(renaming)하거나, vsetvli 뒤에서 벡터 명령어를 멈추는 것이 흔한 선택이다(추정). 15편의 디코더에서 다시 다룬다.
정리
- V 확장은 VLEN비트 벡터 레지스터 32개와
vl·vtype등 CSR 7개를 더한다. VLEN은 구현이 정하고(V는 128 이상), 코드에는 나타나지 않는다.mstatus.VS를 켜야 쓸 수 있다. - VLMAX = VLEN / SEW × LMUL. LMUL은 1/8~8이고, 그룹은 LMUL 배수 번호에서만 시작한다. QEMU는 SEW > LMUL × ELEN인 6개 조합에서 vill을 세웠다.
vsetvli는 AVL과 VLMAX로 vl을 정한다. VLMAX와 2·VLMAX 사이는 구현 선택이라 코드는 돌려받은 vl만 믿어야 한다. QEMU는 164개 모두 min(AVL, VLMAX)였다.- 같은 기계어 12개짜리 루프가 VLEN 128·256·512·1024에서 25·13·7·4번 돌았다. 실행 명령어는 313·169·97·61개, 스칼라 루프는 813개였다.
다음 글: 14편에서는 V 확장의 나머지 절반을 본다. v0를 마스크로 쓰는 조건부 연산, 단위 보폭·보폭·인덱스(gather/scatter)·세그먼트 로드스토어, 페이지 끝에서 멈추지 않는 first-fault 로드로 짠 strlen, vredsum 같은 축약과 vslideup·vrgather·vcompress 같은 순열, 그리고 tail·mask agnostic이 하드웨어에 주는 자유를 QEMU에서 실행해 확인한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 31장 "V" Standard Extension for Vector Operations, Version 1.0: 31.2 구현 상수(VLEN·ELEN), 31.3 프로그래머 모델(
mstatus.VS,vtype,vl,vlenb), 31.4 원소 배치, 31.6 설정 명령어(31.6.3 vl 설정 규칙), 31.7.4 단위 보폭 로드스토어, 31.18 표준 벡터 확장(Zvl·Zve). https://github.com/riscv/riscv-isa-manual - The RISC-V Instruction Set Manual, Volume II: Privileged Architecture, Version 20240411. 3.1.6
mstatus(VS 필드). - RISC-V Vector C Intrinsics 명세 v1.0 (
__riscv_접두어 API). https://github.com/riscv-non-isa/rvv-intrinsic-doc - D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 8장 RV32V. 비준 이전 초안을 바탕으로 해서 명령어 이름과 인코딩이 1.0과 다르다. 벡터 길이 레지스터의 개념 설명으로만 참고했다.
- QEMU RISC-V 문서(
virt보드, CPU 속성v·vlen·elen). https://www.qemu.org/docs/master/system/target-riscv.html