이 글의 핵심 3줄
- RV32I의 나머지 절반은 흐름 제어와 메모리 접근이다. 분기 6종(
beqbnebltbgebltubgeu), 점프 2종(jaljalr), 로드 5종, 스토어 3종에fence·ecall·ebreak가 더해지면 RV32I 40개가 다 모인다. jalr는 목적지의 최하위 비트를 지운다. QEMU에서0x80000021로 뛰었더니0x80000020에 내려앉았다. 정렬 안 된 로드·스토어는 명세가 실행 환경에 맡겼고, QEMU는 트랩 없이 처리했다. 반면 C 확장을 끈 CPU에서 2바이트 어긋난 점프는 mcause 0 예외가 났다.- 분기·로드·스토어·트랩 결과 56개를 Python 기준 모델과 GNU as 인코딩에 대조해 모두 일치했다. 마지막에 디코더와 로드·스토어 유닛의 체크리스트를 정리했다.
3편에서 ALU가 할 일(정수 연산과 lui·auipc)을 봤다. 4편은 RV32I의 남은 명령어를 다룬다. 프로그램의 흐름을 바꾸는 분기와 점프, 메모리를 읽고 쓰는 로드와 스토어, 그리고 메모리 순서를 정하는 fence와 실행 환경을 부르는 ecall·ebreak다. 이 편이 끝나면 RV32I 명령어를 모두 본 셈이고, 15편부터 만들 디코더의 입력 표가 완성된다.
이번에도 QEMU 11.1.3의 virt 보드에서 베어메탈로 실행해 확인했다. 트랩이 나는 경우를 보려고 M모드 트랩 핸들러를 하나 달아 mcause·mepc·mtval을 찍었다. 장비는 맥 M1 Max, 컴파일러는 riscv64-elf-gcc 16.2다.
1. 분기: 두 레지스터를 비교하고 바로 뛴다
x86이나 ARM은 비교 명령어가 플래그를 세우고, 분기 명령어가 그 플래그를 읽는다. RISC-V에는 플래그가 없다(3편). 대신 분기 명령어 하나가 두 레지스터를 비교하고, 참이면 뛴다. 명세는 이 선택의 이유로 파이프라인에 잘 맞고, 플래그 상태가 없으며, 코드가 짧아진다는 점을 든다.
| 명령어 | 조건 | 비교 방식 | -1, 1 일 때 |
|---|---|---|---|
beq |
rs1 == rs2 | 같음 | 안 뜀 |
bne |
rs1 ≠ rs2 | 같음 | 뜀 |
blt |
rs1 < rs2 | 부호 있음 | 뜀 |
bge |
rs1 ≥ rs2 | 부호 있음 | 안 뜀 |
bltu |
rs1 < rs2 | 부호 없음 | 안 뜀 |
bgeu |
rs1 ≥ rs2 | 부호 없음 | 뜀 |
오른쪽 열은 rs1=0xffffffff, rs2=1을 QEMU에서 실제로 넣어 본 결과다. 부호 있게 읽으면 −1 < 1이라 blt가 뛰고, 부호 없이 읽으면 4,294,967,295 ≥ 1이라 bgeu가 뛴다. 이 외에 (1, −1), (0x80000000, 0x7fffffff), (5, 5) 세 쌍을 더해 6×4 = 24가지를 실행했고, 모두 Python 기준 모델과 같았다.
bgt·ble·bgtu·bleu는 없다. 피연산자 순서를 바꾸면 되기 때문이다. bgt a0, a1, L은 어셈블러가 blt a1, a0, L로 바꾼다. beqz·bnez·bltz 같은 것도 x0와 비교하는 의사 명령어다. 명세에는 재미있는 관용구도 하나 있다. 부호 있는 배열 인덱스 검사(0 ≤ i < n)는 bltu 하나로 된다. 음수 i는 부호 없이 읽으면 아주 큰 수라 n보다 크기 때문이다.
목적지와 거리
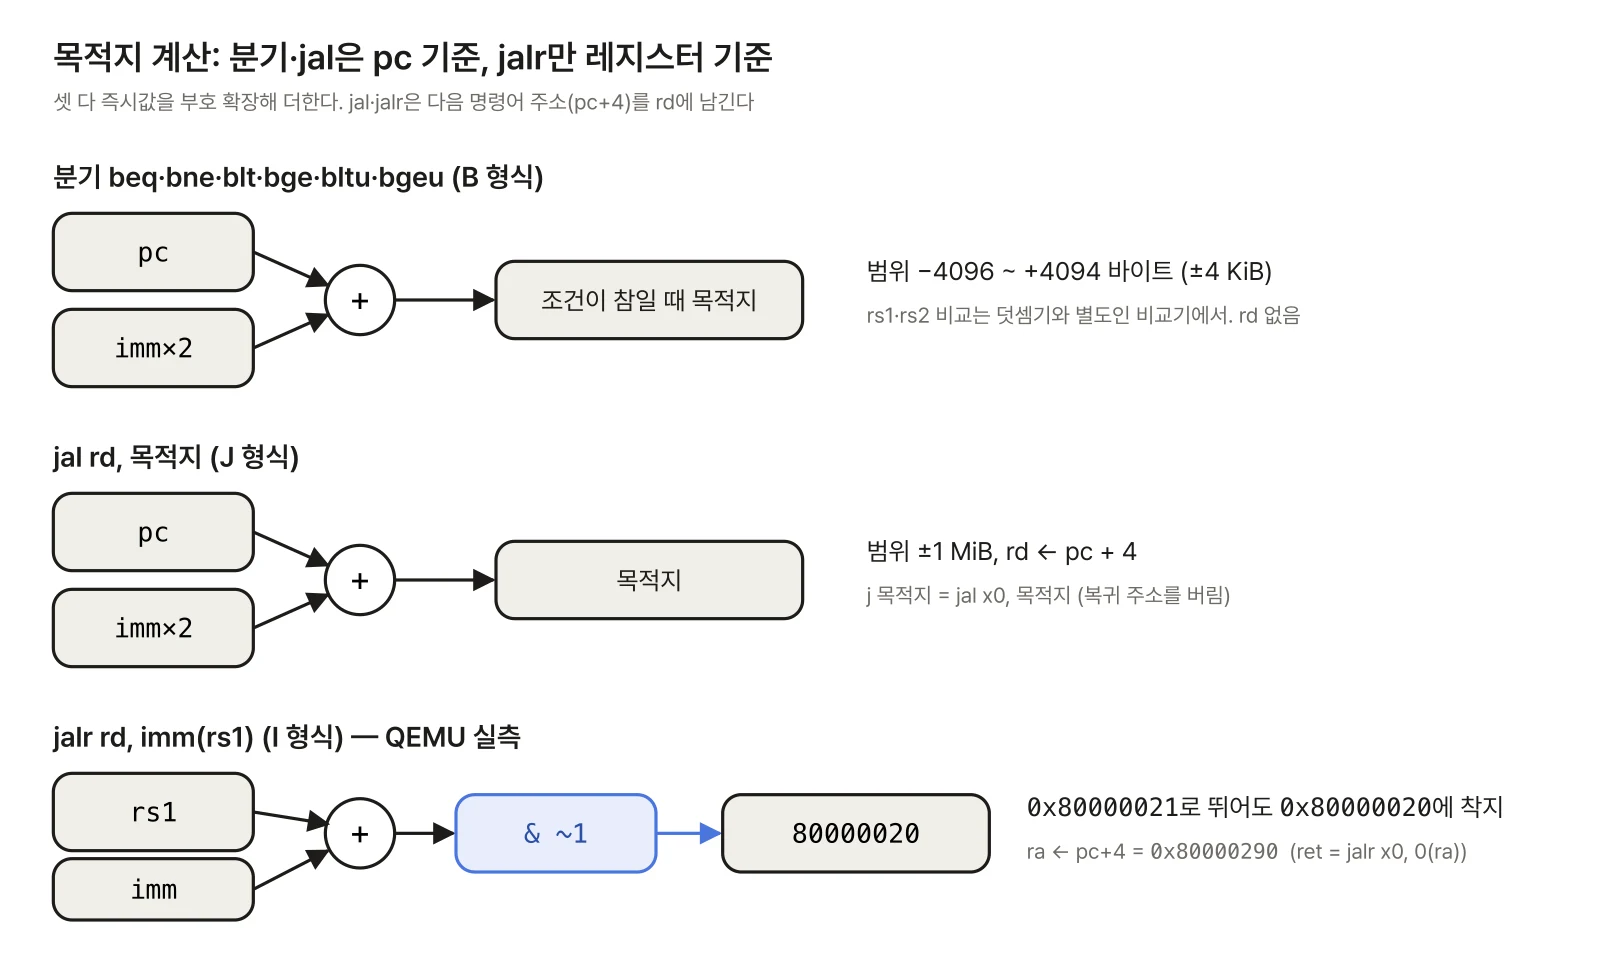
분기는 B 형식이다. 12비트 즉시값이 2바이트 단위 거리를 나타내므로, 실제로는 13비트 부호 있는 값(최하위 비트는 항상 0)이 된다. 목적지는 그 분기 명령어 자신의 주소에 이 거리를 더한 곳이다. 범위는 −4096 ~ +4094 바이트, 즉 ±4 KiB다.
한계를 넘으면 어떻게 될까. 목적지를 +4094, +4096, −4096, −4100 바이트에 두고 GNU as로 어셈블해 봤다.
거리    어셈블러 결과          기계어
+4094   beq 그대로             7eb50fe3
+4096   bne +8, j 목적지       00b51463 0000106f
-4096   beq 그대로             80b50063
-4100   bne +8, j 목적지       00b51463 ff9fe06f
범위 밖이면 어셈블러가 조건을 뒤집은 분기로 j 하나를 건너뛰게 바꿨다. j는 ±1 MiB까지 닿으므로 거리 문제가 풀린다. 기계어에서 즉시값을 다시 꺼내 보니 7eb50fe3은 +4094, 80b50063은 −4096이었다. B 형식으로 담을 수 있는 양 끝 값이다.
명세는 정적 예측에 대한 권고도 남겼다. 처음 만나는 분기는 "뒤로 가면 뜀, 앞으로 가면 안 뜀"으로 예측된다고 가정하고 코드를 배치하라는 것이다. 반복문의 끝은 뒤로 가는 분기라 대개 뛰고, 예외 처리 같은 드문 경로는 앞으로 빼 둔다. 동적 예측기가 없는 작은 코어라면 즉시값의 부호 비트(inst[31]) 하나로 이 예측을 할 수 있다.
2. jal과 jalr: 호출, 복귀, 꼬리 호출
jal rd, 목적지(jump and link)는 J 형식으로, pc에서 ±1 MiB 안으로 뛰고 다음 명령어 주소(pc+4)를 rd에 남긴다. 함수 호출이면 rd는 ra(x1)다. 복귀 주소가 필요 없으면 rd에 x0를 쓴다. 이것이 의사 명령어 j다.
jalr rd, imm(rs1)(jump and link register)은 I 형식으로, 목적지를 레지스터에서 가져온다.
rs1에 부호 확장한 12비트 즉시값을 더한 뒤 최하위 비트를 0으로 지운다. 명세는 이 결정이 하드웨어를 조금 단순하게 하고, 함수 포인터의 최하위 비트에 다른 정보를 담을 수 있게 해 준다고 설명한다. jalr의 즉시값은 분기와 달리 2를 곱하지 않는다. 즉시값 형식을 하나 더 만들지 않으려는 선택이다.
QEMU로 확인했다. tgt라는 작은 함수의 주소에 1을 더해 홀수 주소 0x80000021을 만들고 jalr ra, 0(t0)로 뛰었다. tgt는 0x80000020에 있고, 받은 ra를 그대로 돌려준다. 결과는 정상 복귀였고, 돌려받은 ra는 0x80000290으로 jalr 다음 명령어의 주소(차이 4)였다. 즉시값 쪽에 1을 넣은 jalr ra, 1(t0)도 똑같이 tgt에 내려앉았다.
이 두 명령어로 함수 호출의 모든 모양이 만들어진다.
| 의사 명령어 | 실제 명령어 | 쓰임 |
|---|---|---|
j L |
jal x0, L |
무조건 점프 |
jal L |
jal ra, L |
가까운 함수 호출 |
ret |
jalr x0, 0(ra) |
복귀 |
jr t0 |
jalr x0, 0(t0) |
간접 점프(switch 표 등) |
call f |
auipc ra, … + jalr ra, …(ra) |
먼 함수 호출 |
tail f |
auipc t1, … + jalr x0, …(t1) |
꼬리 호출 |
실제 컴파일 결과를 보자. 함수 twice(x)는 add3(add3(x))를 돌려준다.
twice:
  addi sp,sp,-16
  sw   ra,12(sp)      # ra를 덮어쓸 테니 저장
  jal  add3           # 첫 호출: ra = 다음 주소
  lw   ra,12(sp)      # 내 복귀 주소 되살리기
  addi sp,sp,16
  j    add3           # 마지막 호출: 꼬리 호출
두 번째 add3는 jal이 아니라 j다. add3가 끝나면 어차피 twice도 바로 끝나므로, ra에 twice를 부른 쪽의 주소를 되돌려 놓고 그냥 뛰어 버린다. 그러면 add3의 ret이 곧바로 원래 호출자로 돌아간다. 이것이 꼬리 호출(tail call)이다. 함수 포인터로 부르는 indirect는 lw a5, … 뒤에 jalr a5(= jalr ra, 0(a5))가 됐다. QEMU에서 twice(10)은 16, indirect(10)은 14로 맞게 나왔다.
컴파일 직후 객체 파일(.o)에서는 두 호출이 모두 auipc ra + jalr ra 두 명령어였다. 컴파일 시점에는 add3가 얼마나 멀리 있을지 모르기 때문이다. 링커가 실제 거리를 알고 나서 ±1 MiB 안이면 jal 하나로 줄였다(링커 완화, 6편에서 자세히).
jal·jalr가 어떤 레지스터를 쓰는지는 하드웨어에게 힌트가 된다. 명세는 rd나 rs1이 x1·x5일 때 복귀 주소 스택(RAS)에 넣고 빼는 규칙을 표로 정해 두었다. jal ra는 넣기(push), ret은 빼기(pop)다. 분기 예측기를 다루는 18편에서 이 표를 구현한다.
3. 로드와 스토어
RV32I는 로드·스토어 구조다. 메모리를 만지는 명령어는 로드와 스토어뿐이고, 주소는 언제나 rs1 + 부호 확장한 12비트 즉시값이다. 로드는 I 형식, 스토어는 S 형식이다.
로드는 다섯 가지다. lw는 4바이트, lh·lhu는 2바이트, lb·lbu는 1바이트를 읽는다. 32비트보다 좁은 값을 레지스터에 넣을 때 위를 무엇으로 채울지가 u의 유무로 갈린다. u가 없으면 읽은 값의 맨 윗비트를 복사(부호 확장)하고, u가 있으면 0으로 채운다(영 확장).
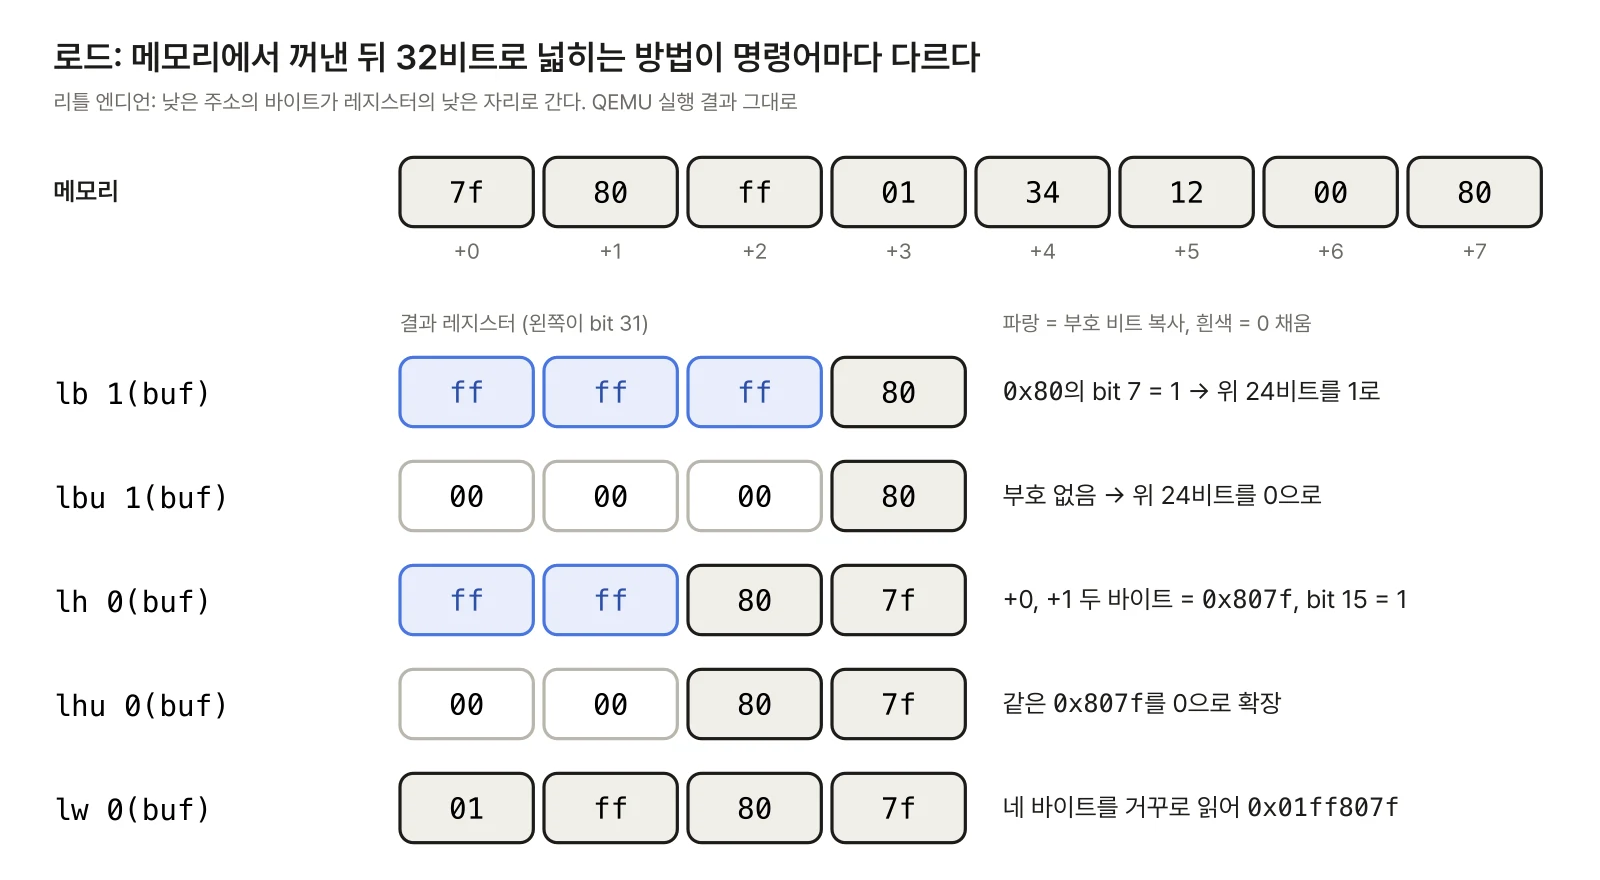
메모리에 7f 80 ff 01 34 12 00 80을 두고 QEMU에서 읽었다. lb로 +1의 0x80을 읽으면 맨 윗비트가 1이라 0xffffff80(−128)이 되고, lbu로 읽으면 0x00000080(128)이다. lw는 네 바이트를 낮은 주소부터 레지스터의 낮은 자리에 채워 0x01ff807f가 된다. 이것이 리틀 엔디언이다. 명세는 엔디언을 실행 환경이 정한다고 하지만, 명령어 인출은 언제나 리틀 엔디언이고 데이터도 기본은 리틀 엔디언이다(빅 엔디언은 특권 명세의 mstatus.MBE 같은 선택 비트로만 켜진다).
lwu가 없는 이유는 RV32에서는 lw가 레지스터를 꽉 채워 확장할 자리가 없기 때문이다. RV64에서는 lwu가 생긴다(5편).
스토어는 sw·sh·sb 셋이다. rs2의 아래 4·2·1바이트를 메모리에 쓴다. 부호·영 확장은 필요 없다. 그래서 sbu 같은 것은 없다. 0x11223344가 든 워드의 +1에 sb로 0xcafeabcd를 쓰면 아래 바이트 0xcd만 들어가 0x1122cd44가 되고, 이어 +2에 sh로 0xcafebeef를 쓰면 0xbeefcd44가 됐다.
설계에서 놓치기 쉬운 규칙이 하나 있다. rd가 x0인 로드도 예외와 부수 효과는 그대로 내야 한다. 값은 버리지만, 읽기 자체가 장치 레지스터를 비우는 MMIO 주소라면 읽기는 일어나야 한다. "rd=x0이면 로드를 건너뛴다"는 최적화는 틀린 구현이다.
4. 정렬 안 된 접근: 명세는 실행 환경에 맡겼다
lw의 주소가 4의 배수가 아니면 "정렬 안 된(misaligned)" 접근이다. 명세(2.6절)의 규칙은 이렇다.
- 자연 정렬된 접근은 어떤 경우에도 주소 정렬 예외를 내면 안 된다.
- 정렬 안 된 접근의 동작은 실행 환경(EEI)이 정한다. 하드웨어가 처리하든, 보이지 않는 M모드 트랩으로 소프트웨어가 흉내 내든, 둘을 섞든 상관없다.
- 실행 환경이 보장하지 않으면 접근은 성공하거나, 주소 정렬 예외 또는 접근 오류(access fault) 예외를 낸다. 부작용이 있는 영역처럼 흉내 내면 안 되는 곳에서는 접근 오류를 낼 수 있다.
- 정렬 안 된 접근은 성공하더라도 원자적이라는 보장이 없고, 아주 느릴 수 있다.
명세가 하나로 정하지 않은 이유도 적혀 있다. 정렬 안 된 접근 전용 명령어(MIPS의 lwl·lwr 같은)는 ISA를 복잡하게 하므로, 보통 로드·스토어로 쓰게 두고 하드웨어 지원은 구현이 고르게 했다. 참고로 응용 프로세서 프로파일(RVA22·RVA23)은 캐시 가능한 주 메모리에서 정렬 안 된 접근을 지원하라고 요구한다(Zicclsm). 다만 속도는 보장하지 않으니 트랩 흉내여도 된다.
QEMU는 어떻게 할까. 16바이트 버퍼 00 11 22 … ff에서 여러 어긋난 주소를 읽고 썼다.
| 접근 | 주소 | 결과 | 트랩 |
|---|---|---|---|
lw |
+1 | 44332211 |
없음 |
lw |
+2 | 55443322 |
없음 |
lh |
+1 | 00002211 |
없음 |
lw |
+6 | 99887766 |
없음 |
sw |
+5 | 두 워드에 걸쳐 씀 | 없음 |
트랩 핸들러를 달아 뒀지만 한 번도 불리지 않았다. QEMU 11.1.3의 virt는 일반 로드·스토어의 정렬 안 된 접근을 그냥 처리했다. 8바이트 경계를 넘는 lw +6도, 두 워드에 걸치는 sw +5(b2c3d444, bbaa99a1로 나뉘어 들어감)도 리틀 엔디언 그대로였다. 실제 칩은 다를 수 있다. 작은 마이크로컨트롤러 코어는 대개 mcause 4(로드 주소 정렬)나 6(스토어 주소 정렬) 예외를 내고, 필요하면 M모드 소프트웨어가 바이트 단위로 나눠 흉내 낸다. 그래서 QEMU에서 잘 돌던 코드가 실제 보드에서 트랩으로 멈추는 일이 생긴다.
명령어 주소 정렬은 다르다
명령어 쪽은 규칙이 분명하다. jal·jalr·조건이 참인 분기의 목적지가 4바이트 정렬이 아니면 명령어 주소 정렬 예외(mcause 0)가 난다. 단, C 확장처럼 16비트 명령어가 있는 기계에서는 2바이트 정렬이면 합법이라 이 예외가 날 수 없다. 그리고 이 예외는 목적지를 인출할 때가 아니라 점프 명령어에서 난다. 조건이 거짓인 분기는 목적지가 어긋나 있어도 예외가 없다.
QEMU의 기본 CPU는 C 확장이 켜져 있다(misa = 0x401411ad). C를 끈 CPU(-cpu rv32,c=false, misa = 0x401411a9)로 jalr를 목적지+2로 보냈다.
| 상황 | mcause | mepc | mtval |
|---|---|---|---|
C 끔, jalr → +2 |
0 (명령어 주소 정렬) | jalr 자신 |
목적지 0x80000022 |
C 켬, jalr → +2 |
2 (불법 명령어) | 0x80000022 |
0 |
ecall (M모드) |
11 | ecall 자신 |
0 |
ebreak |
3 | ebreak 자신 |
ebreak 주소 |
C를 끈 경우 mepc는 jalr 명령어(0x80000374)를 가리켰고 mtval에는 잘못된 목적지가 들어갔다. C를 켠 경우는 점프 자체는 합법이어서 nop(0x00000013)의 윗부분 0x0000을 16비트 명령어로 해석했고, 모두 0인 16비트 명령어는 불법이라 mcause 2가 났다. 같은 실수가 CPU 설정에 따라 다른 예외로 드러난다.
5. fence, ecall, ebreak
fence는 메모리 접근 순서를 정한다. "fence 앞의 이런 접근이, fence 뒤의 저런 접근보다 먼저 보여야 한다"를 적는다. 앞(predecessor)과 뒤(successor) 각각 4비트로 I(장치 입력), O(장치 출력), R(메모리 읽기), W(메모리 쓰기)를 고른다.
 31..28  27..24      23..20      19..15 14..12 11..7 6..0
 fm      PI PO PR PW SI SO SR SW rs1    000    rd    0001111
어셈블러가 만든 기계어를 이 배치로 직접 계산한 값과 대조했다.
fence rw,rw   0330000f   pred=RW   succ=RW
fence         0ff0000f   pred=IORW succ=IORW
fence w,r     0120000f   pred=W    succ=R
fence.tso     8330000f   fm=1000, RW,RW
pause 0100000f pred=W succ=없음fence.tso는 fm 필드가 1000인 fence rw,rw다. 쓰기 뒤 읽기의 순서만 풀어 준 약한 fence라서, 명세는 fm을 무시하고 fence rw,rw로 구현해도 맞다고 한다. pause(Zihintpause)는 succ가 비어 있는 fence 인코딩을 재활용한 HINT다. 기본 구현은 rs1·rd 필드와 예약된 fm·pred·succ 조합을 무시하고 일반 fence로 처리해야 한다. 그래서 pause를 모르는 옛 코어에서도 문제없이 돈다. QEMU에서 다섯 가지 모두 트랩 없이 지나갔다.
하드웨어 입장에서 순서대로 한 번에 하나씩 메모리에 접근하는 단순한 코어라면 fence는 사실상 nop이다. 명세도 단순한 구현은 pred·succ를 무시하고 언제나 보수적인 fence를 해도 된다고 적었다. 스토어 버퍼가 있으면 비울 때까지 기다리는 정도가 흔한 구현이다(추정). 정확한 의미는 메모리 모델을 다루는 9편에서 본다.
ecall과 ebreak는 SYSTEM opcode(1110011)를 쓰고, 즉시값 0과 1로 갈린다. ecall은 실행 환경(운영체제, SBI 펌웨어)에 서비스를 요청하고, ebreak는 디버거로 제어를 넘긴다. GCC는 __builtin_trap()도 ebreak로 만든다. 둘 다 정밀한 예외를 일으키는데, 4절의 표처럼 mepc는 명령어 자신의 주소다. 그래서 트랩 핸들러가 mepc에 4를 더하지 않으면 같은 ecall로 돌아가 무한 반복한다. 이 실습의 핸들러도 mepc += 4를 했다.
ecall의 mcause는 부른 모드에 따라 8(U), 9(S), 11(M)로 다르다. ebreak의 mtval은 특권 명세가 0 또는 해당 주소를 쓰도록 허용하는데, QEMU는 ebreak의 주소를 썼다. 특권 처리 자체(모드 전환, mret)는 25편에서 다룬다.
6. 실습: 실행 결과를 기준 모델과 대조
트랩 핸들러는 GCC의 interrupt 속성으로 짰다. 레지스터 저장과 mret을 컴파일러가 만들어 준다.
__attribute__((interrupt("machine"), aligned(4)))
void handler(void) {
  uint32_t c, e, v;
  __asm__ volatile("csrr %0, mcause\n"
                   "csrr %1, mepc\n"
                   "csrr %2, mtval"
                   : "=r"(c), "=r"(e), "=r"(v));
  show(" trap", c, e, v);
  ntrap++;
  /* 트랩 낸 명령어 건너뛰기 (C 없음 가정) */
  __asm__ volatile("csrw mepc, %0" : : "r"(e + 4));
}
/* main 첫 줄: csrw mtvec, handler */
분기는 "뛰면 1, 안 뛰면 0"을 남기는 매크로로 실행했다.
#define BR(op, a, b) ({ uint32_t t_;          \
  __asm__ volatile("li %0,1\n " op " %1,%2,1f\n" \
                   " li %0,0\n1:"              \
: "=&r"(t_) : "r"(a), "r"(b)); t_; })csrr·csrw를 쓰려면 Zicsr이 필요해 -march=rv32i_zicsr_zihintpause로 빌드했다. 결과는 Python 기준 모델(분기 조건, 리틀 엔디언 바이트 조립과 부호 확장, 스토어 바이트 마스크, fence 필드 조립, B 형식 즉시값 복원)과 대조했다.
| 시험 | 개수 | 일치 |
|---|---|---|
| 분기 6종 × 입력 4쌍 | 24 | 24 |
jalr 최하위 비트·ra = pc+4 |
3 | 3 |
| 로드 9 + 스토어 3 | 12 | 12 |
| 정렬 안 된 로드 값·트랩 없음 | 5 | 5 |
| 트랩 mcause·mtval | 3 | 3 |
| 분기 즉시값·fence 인코딩·호출 결과 | 9 | 9 |
모두 56개, 전부 일치했다. C를 켠 CPU에서 어긋난 점프를 했을 때 핸들러가 mepc += 4로 넘어가면서 16비트 조각들을 연달아 불법 명령어로 만났다(3번 트랩). 핸들러가 "명령어 길이 4"를 가정한 탓이다. 실제 핸들러는 mepc의 명령어 아래 2비트를 보고 길이를 정해야 한다.
7. 설계 체크리스트: 분기·점프와 로드·스토어 유닛
| 항목 | 규칙 |
|---|---|
| 분기 비교 | funct3로 고른다. blt·bge는 부호 있음, bltu·bgeu는 부호 없음 |
| 분기 목적지 | 분기 자신의 pc + 13비트 부호 있는 거리. 비교와 별도 덧셈기가 흔하다 |
| 분기 정렬 예외 | 조건이 참이고 목적지가 4바이트 정렬이 아닐 때만. C가 있으면 없음 |
jalr 목적지 |
(rs1 + imm) & ~1. bit 1은 C가 없을 때 정렬 검사 |
jalr rd = rs1 |
jalr ra, 0(ra): rs1을 먼저 읽고 rd에 pc+4를 써야 한다 |
| 점프 예외 위치 | 정렬 예외는 점프·분기 명령어에서. 목적지 인출의 접근 오류는 목적지에서 |
| 로드 크기 | funct3[1:0] = 0·1·2 → 바이트·하프·워드, funct3[2] = 1이면 영 확장 |
| 로드 rd = x0 | 값만 버린다. 예외와 MMIO 부수 효과는 그대로 |
| 스토어 레인 | 주소 아래 2비트와 크기로 바이트 활성 4비트. 데이터는 rs2 아래 바이트를 레인에 복제(흔한 선택) |
| 정렬 안 된 접근 | 실행 환경에 맡김. 작은 코어는 mcause 4·6 예외, 큰 코어는 하드웨어로 두 번 접근(흔한 선택) |
| 정렬 예외 mtval | 정렬 안 된 유효 주소(QEMU 점프: 잘못된 목적지) |
fence |
순서대로 하나씩 접근하면 nop, 스토어 버퍼가 있으면 비우기. 예약 조합은 일반 fence |
ecall·ebreak |
mepc = 명령어 자신. mcause 8·9·11, 3 |
로드 크기 줄이 디코더를 간단하게 한다. lb=000, lh=001, lw=010, lbu=100, lhu=101이라 funct3의 아래 두 비트는 크기, 맨 윗비트는 "부호 확장 끄기"로 바로 쓸 수 있다. 스토어도 sb=000, sh=001, sw=010으로 같은 크기 인코딩이다. 그래서 로드 정렬기(읽은 워드에서 바이트를 골라 확장)와 스토어 레인 생성기가 같은 크기 신호를 함께 쓴다.
정리
- 분기 6종은 두 레지스터를 직접 비교한다. 거리는 ±4 KiB이고, 범위 밖이면 어셈블러가 조건을 뒤집은 분기 +
j로 바꿨다(+4094는 그대로, +4096은 바뀜). jal은 pc 기준 ±1 MiB,jalr은 rs1 기준이고 목적지의 최하위 비트를 지운다(0x80000021→0x80000020). 둘 다 rd에 pc+4를 남기고,ret·call·tail·꼬리 호출이 모두 이 조합이다.- 로드는
u유무로 부호/영 확장이 갈린다. 정렬 안 된 데이터 접근은 실행 환경에 맡겨져 있고, QEMU는 트랩 없이 처리했다. 명령어 목적지가 어긋나면 C가 없을 때 mcause 0 예외가 점프 명령어에서 났다. fence는 pred·succ 4비트씩으로 순서를 적고,ecall·ebreak는mepc에 자기 주소를 남긴다. 실행 결과 56개가 기준 모델과 모두 일치했다.
다음 글: 5편에서는 RV64I로 넘어간다. 레지스터가 64비트가 되면서 ld·sd·lwu가 생기고, addw·subw·sllw 같은 W 명령어가 32비트 결과를 부호 확장해 64비트 레지스터에 둔다. W 명령어가 왜 필요한지(C의 int), lui·auipc가 64비트에서 어떻게 부호 확장되는지, 64비트 상수를 만드는 데 명령어가 몇 개나 드는지를 QEMU와 objdump로 확인한다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 2.5 제어 이동 명령어(RAS 힌트 표 포함), 2.6 로드·스토어(정렬 안 된 접근), 2.7 메모리 순서 명령어(FENCE), 2.8 환경 호출과 브레이크포인트. https://github.com/riscv/riscv-isa-manual
- The RISC-V Instruction Set Manual, Volume II: Privileged Architecture, Version 20240411. 3.1.14
mepc, 3.1.15mcause, 3.1.16mtval, 3.3.1 ECALL·EBREAK - RISC-V Profiles (RVA22·RVA23, Zicclsm). https://github.com/riscv/riscv-profiles
- D. Patterson, A. Waterman, The RISC-V Reader: An Open Architecture Atlas, 2017. 2장 RV32I
- GCC RISC-V 함수 속성
interrupt. https://gcc.gnu.org/onlinedocs/gcc/RISC-V-Function-Attributes.html - QEMU
virt보드 문서. https://www.qemu.org/docs/master/system/riscv/virt.html