이 글의 핵심 3줄
- 즉시값 생성기는 2편의 선택기 표를 출력 비트 묶음별 선택기 일곱 개로 옮긴 회로다. 무작위 명령어 20만 개 × 형식 5가지, 100만 경우에서 형식별로 비트를 이어 붙인 계산과 모두 같았다.
- 단일 사이클 데이터패스는 PC·명령어 메모리·레지스터 파일(읽기 2, 쓰기 1)·ALU·데이터 메모리에 선택기 다섯 개(ALU 입력 A·B, 쓰기 되돌림, 다음 pc, 즉시값 형식)를 더하면 RV32I 전체가 돈다.
lw·bltu·ret이 이 길을 지나가는 모습을 실제 값으로 따라갔다. - 이 모델로 컴파일한 프로그램 5개(명령어 1,076,364개)를 실행해 QEMU와 UART 출력·명령어 단위 pc 열·최종 레지스터가 모두 같았다. 실행한 명령어의 20.0%가 분기, 6.1%가 점프였고 분기의 58.5%가 실제로 갔다. 이것이 17편 CPI 분석의 바탕이다.
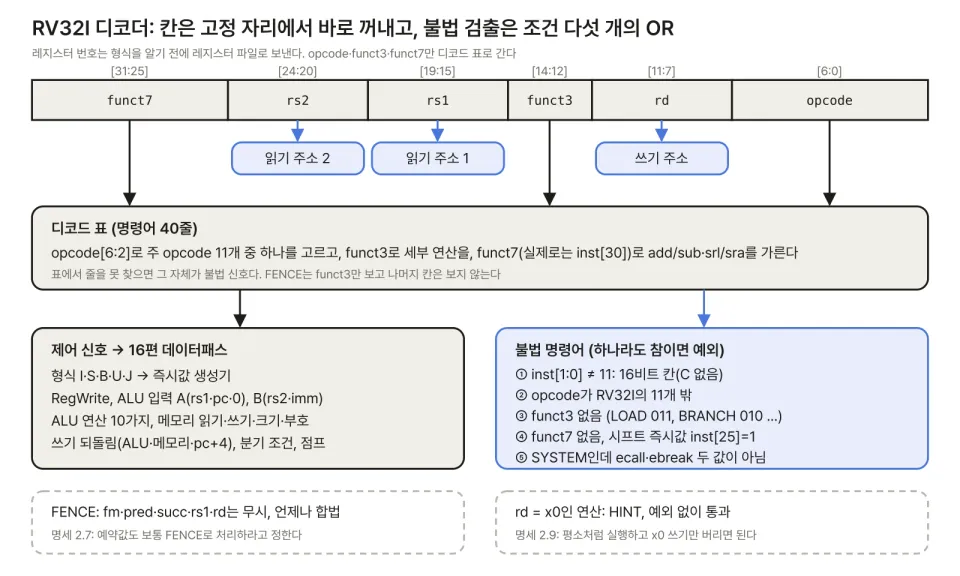
15편에서 디코더가 명령어 한 줄을 받아 레지스터 번호, 형식, 제어 신호, 불법 표시를 내놓게 만들었다. 이번 편은 그 출력을 받아 실제로 계산을 하는 부분, 데이터패스(datapath)를 만든다. 먼저 2편에서 표로만 봤던 즉시값 배치를 회로로 옮기고, 그다음 한 사이클에 명령어 하나를 끝내는 가장 단순한 코어, 단일 사이클(single-cycle) 데이터패스를 조립한다. 단일 사이클 코어는 느리지만 "명령어 하나가 무엇을 거쳐 가는가"가 가장 잘 보이고, 17편 파이프라인은 이 그림을 다섯 토막으로 자른 것일 뿐이다.
1. 즉시값 생성기: 2편의 표를 회로로
2편에서 즉시값 출력 비트마다 "형식에 따라 명령어의 몇 번 비트를 가져오나"를 표로 만들었다. 출처가 같은 비트끼리 묶으면 출력은 일곱 묶음이고, 묶음마다 선택기 하나다.
| 출력 비트 | 선택 규칙 | 입력 수 |
|---|---|---|
| imm[31] | 언제나 inst[31] | 1 |
| imm[30:20] | U면 inst[30:20], 아니면 부호 | 2 |
| imm[19:12] | U·J면 inst[19:12], 아니면 부호 | 2 |
| imm[11] | B: inst[7], J: inst[20], U: 0, 그 밖: 부호 | 4 |
| imm[10:5] | U면 0, 아니면 inst[30:25] | 2 |
| imm[4:1] | I·J: inst[24:21], S·B: inst[11:8], U: 0 | 3 |
| imm[0] | I: inst[20], S: inst[7], 그 밖: 0 | 3 |
여기서 "부호"는 inst[31]을 그 폭만큼 복사한 것이다. 선택 신호는 디코더가 내는 형식 신호 다섯 개(I·S·B·U·J)뿐이다. R 형식에는 즉시값이 없으니 출력이 무엇이든 상관없다. 모델에서는 이 표를 그대로 옮겼다.
def imm_gen(w, fmt):
    s = w >> 31                       # 부호는 언제나 inst[31]
    fill = lambda n: ((1 << n) - 1) if s else 0
    I, S, B, U, J = (fmt == f for f in 'ISBUJ')
    i30_20 = bits(w, 30, 20) if U else fill(11)
    i19_12 = bits(w, 19, 12) if (U or J) else fill(8)
    i11 = (bits(w, 7, 7) if B else bits(w, 20, 20) if J
           else 0 if U else s)
    i10_5 = 0 if U else bits(w, 30, 25)
    i4_1 = (bits(w, 24, 21) if (I or J)
            else bits(w, 11, 8) if (S or B) else 0)
    i0 = bits(w, 20, 20) if I else bits(w, 7, 7) if S else 0
    return (s << 31 | i30_20 << 20 | i19_12 << 12
            | i11 << 11 | i10_5 << 5 | i4_1 << 1 | i0)
RTL로 옮길 때도 줄 하나가 assign 하나다. 2편 방식(형식마다 비트를 이어 붙인 뒤 부호 확장)과 이 회로 모양을 무작위 명령어 20만 개에 형식 다섯 가지를 모두 적용해 비교했다(시드 16). 100만 경우가 모두 같았다.
손으로 하나 확인해 보자. bltu a5, a0, +24는 0x00a7ec63이다. B 형식이니 imm[11]=inst[7]=0, imm[10:5]=inst[30:25]=000000, imm[4:1]=inst[11:8]=1100, imm[0]=0, 위쪽은 부호 inst[31]=0으로 채운다. 합치면 1100 뒤에 0 하나, 즉 24다.
2. 데이터패스 블록
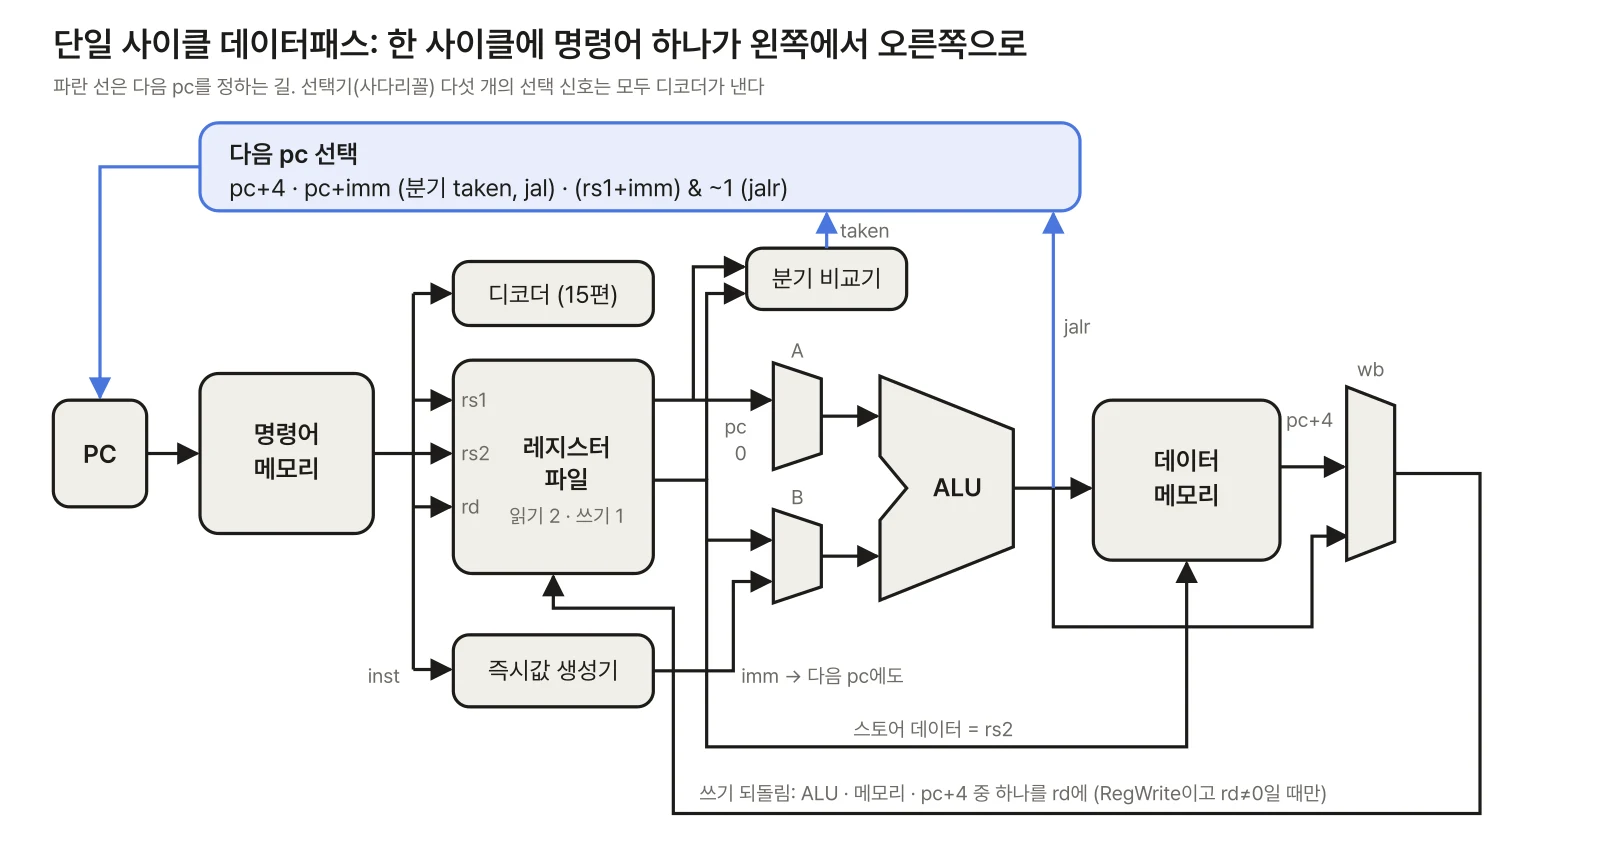
블록마다 하는 일과 크기를 정리한다.
| 블록 | 입력 → 출력 | 비고 |
|---|---|---|
| PC | 다음 pc → pc | 32비트 레지스터 하나 |
| 명령어 메모리 | pc → inst | 읽기 전용, 조합 읽기로 가정 |
| 레지스터 파일 | rs1·rs2·rd·쓰기값 | 읽기 포트 2, 쓰기 포트 1, x0은 0 |
| ALU | A·B·연산 → 결과 | 3편의 10가지 연산 |
| 분기 비교기 | rs1·rs2·조건 → taken | 6가지 조건 |
| 데이터 메모리 | 주소·쓰기값 → 읽은 값 | 바이트·하프워드·워드 |
ALU와 분기 비교기를 나눈 이유가 있다. beq 계열을 ALU의 뺄셈과 "결과가 0인가"로 판단하는 교과서식 설계도 가능하다(DDCA 7.3). 그런데 blt·bge·bltu·bgeu까지 넣으면 ALU에 플래그 출력이 몇 개 더 붙고, 분기 목적지 pc+imm은 어차피 별도 덧셈기가 계산해야 한다(ALU가 비교에 쓰이고 있으니까). 비교기를 따로 두면 ALU는 "값을 만드는 일"만 하고, 18편에서 분기 판단을 ID 단으로 옮길 때 비교기만 떼어 옮기면 된다.
선택기는 다섯 개다.
| 선택기 | 입력 | 고르는 신호 |
|---|---|---|
| ALU 입력 A | rs1 · pc · 0 | auipc=pc, lui=0 |
| ALU 입력 B | rs2 · imm | R 형식과 분기만 rs2 |
| 쓰기 되돌림 | ALU · 메모리 · pc+4 | 로드=메모리, jal·jalr=pc+4 |
| 다음 pc | pc+4 · pc+imm · (rs1+imm)&~1 | taken 분기·jal / jalr |
| 즉시값 형식 | I·S·B·U·J | 1절의 회로 안 |
ALU 입력 A에 0을 넣는 것은 lui를 "0 + imm"으로 계산하기 위해서다. 0 대신 lui만을 위한 선택기 입력을 쓰기 되돌림 쪽에 다는 방법도 있다. 어느 쪽이든 입력이 하나 느는 것은 같다.
3. 형식별로 데이터패스를 넓혀 가는 순서
데이터패스를 처음부터 다 그리면 왜 그 선이 있는지 놓치기 쉽다. 명령어 종류를 하나씩 더하면서 필요한 선만 늘려 가는 순서가 이해하기 좋다(DDCA 7.3이 lw에서 시작하는 것과 같은 방식).
| 순서 | 명령어 | 새로 생기는 것 |
|---|---|---|
| 1 | lw |
PC, 두 메모리, 레지스터 읽기 1·쓰기, I 즉시값, ALU 덧셈 |
| 2 | sw |
레지스터 읽기 2, S 즉시값, 메모리 쓰기 |
| 3 | R 형식 | ALU 입력 B 선택기(rs2/imm), ALU 연산 10가지, 쓰기 되돌림 선택기 |
| 4 | I 연산 | 없음(1~3의 조합) |
| 5 | 분기 | 비교기, B 즉시값, pc+imm 덧셈기, 다음 pc 선택기 |
| 6 | jal |
J 즉시값, 쓰기 되돌림에 pc+4 |
| 7 | jalr |
다음 pc에 ALU 결과 & ~1 |
| 8 | lui·auipc |
U 즉시값, ALU 입력 A 선택기(rs1/pc/0) |
4번이 비어 있는 것이 재미있다. addi·slti·xori 같은 즉시값 연산은 lw의 "rs1 + I 즉시값" 길과 R 형식의 ALU 연산을 섞은 것이라 새 선이 필요 없다. RV32I 명령어 40개 중 데이터패스를 실제로 넓히는 것은 이 여덟 단계뿐이다. 마지막으로 lb·lh·lbu·lhu·sb·sh를 위해 데이터 메모리 앞뒤에 바이트 선택과 부호 확장 회로가 붙는다.
4. 명령어 한 줄씩 손으로 따라가기
모델로 컴파일한 fib 함수를 돌리면서 처음 나온 lw·bltu·ret의 실제 값을 찍었다. GCC가 만든 코드는 다음과 같다(앞부분).
80000020: addi sp,sp,-16
80000024: sw   ra,12(sp)
80000028: sw   s0,8(sp)
8000002c: mv   s0,a0
80000030: li   a5,1
80000034: bltu a5,a0,8000004c
80000038: mv   a0,s0
8000003c: lw   ra,12(sp)
80000040: lw   s0,8(sp)
80000044: addi sp,sp,16
80000048: ret
bltu a5, a0, 8000004c (pc=0x80000034). 레지스터 파일이 a5=1, a0=20(0x14)을 읽는다. 즉시값 생성기가 B 형식으로 24를 만든다(1절). 분기 비교기가 부호 없는 비교 1 < 20을 참으로 판정하고, pc+imm 덧셈기가 0x80000034 + 24 = 0x8000004c를 만든다. 다음 pc 선택기는 taken이니 pc+imm을 고른다. RegWrite=0, 메모리 접근 없음. ALU는 이 사이클에 쓸모없는 값을 계산하지만 아무 데도 쓰이지 않는다.
lw ra, 12(sp) (pc=0x8000003c). 레지스터 파일이 sp=0x80003fc0을 읽는다. 즉시값 생성기가 I 형식으로 12를 만들고, ALU 입력 A=rs1, B=imm으로 덧셈해 주소 0x80003fcc가 나온다. 데이터 메모리가 그 주소의 워드 0x80000058을 읽고, 쓰기 되돌림 선택기가 "메모리"를 골라 ra(x1)에 쓴다. 다음 pc는 pc+4. 이 한 사이클 안에 명령어 메모리 → 레지스터 파일 → ALU → 데이터 메모리 → 레지스터 파일 쓰기 준비가 모두 들어간다. 단일 사이클 코어의 클록 주기를 정하는 가장 긴 경로가 보통 이 lw의 길이다.
ret = jalr x0, 0(ra) (pc=0x80000048). 레지스터 파일이 ra=0x80000058을 읽고, ALU가 ra + 0을 계산한다. 다음 pc 선택기가 "ALU 결과 & ~1"을 골라 0x80000058로 간다. 쓰기 되돌림은 pc+4(0x8000004c)를 고르지만 rd=x0이라 버려진다. 다음 pc가 레지스터 값에 달려 있다는 점이 jal과 다르고, 18편에서 리턴 주소 스택이 필요해지는 이유다.
명령어별 제어 신호를 모으면 다음과 같다(15편의 표에서 대표만).
| 명령어 | A / B | wb | 다음 pc |
|---|---|---|---|
add |
rs1 / rs2 | ALU | pc+4 |
addi |
rs1 / imm | ALU | pc+4 |
lw |
rs1 / imm | 메모리 | pc+4 |
sw |
rs1 / imm | 쓰지 않음 | pc+4 |
bltu |
쓰지 않음 | 쓰지 않음 | taken이면 pc+imm |
jal |
쓰지 않음 | pc+4 | pc+imm |
jalr |
rs1 / imm | pc+4 | (rs1+imm)&~1 |
lui |
0 / imm | ALU | pc+4 |
auipc |
pc / imm | ALU | pc+4 |
5. 실습: 실제 프로그램을 돌려 QEMU와 대조
모델(16/single.py)은 위 그림을 거의 줄 단위로 옮긴 것이다. 핵심은 step() 한 함수다.
def step(self):
    pc, x, mem = self.pc, self.x, self.mem
    d = decode(mem.fetch(pc))                 # 15편 디코더
    if d.illegal: raise Trap(('illegal', pc, d.w))
    rs1v, rs2v = x[d.rs1], x[d.rs2]            # 읽기 포트 2개
    srcA = rs1v if d.a == 'r' else pc if d.a == 'p' else 0
    srcB = rs2v if d.b == 'r' else d.imm
    y = alu(d.op, srcA, srcB)
    taken = d.br is not None and br_taken(d.br, rs1v, rs2v)
    if d.mem == 'r': res = mem.load(y, d.sz, d.us)
    elif d.wb == '4': res = (pc + 4) & 0xFFFFFFFF
    else: res = y
    if taken or d.j == 'jal': nxt = (pc + d.imm) & 0xFFFFFFFF
    elif d.j == 'jalr': nxt = y & ~1
    else: nxt = pc + 4
    if (taken or d.j) and nxt & 3:
        raise Trap(('misaligned', pc, nxt))
    if d.mem == 'w': mem.store(y, d.sz, rs2v)
    if d.rw and d.rd: x[d.rd] = res           # x0 쓰기는 버림
    self.pc = nxt
시험 프로그램은 C로 다섯 개를 짰다. 재귀 퀵 정렬(정수 300개), 비트 단위 CRC-32(2 KiB), 재귀 피보나치 fib(20), 16×16 정수 행렬 곱, 바이트 배열 에라토스테네스의 체(8000 미만)다. riscv64-elf-gcc 16.2로 -march=rv32i -mabi=ilp32 -O1로 컴파일했다. RV32I에는 곱셈이 없어서 행렬 곱의 *는 libgcc의 __mulsi3 호출이 되므로 -lgcc를 붙였다. 시작 코드와 링커 스크립트는 3편부터 쓰는 공용 베어메탈 환경을 그대로 썼다.
모델에는 QEMU virt 보드에서 쓰는 장치 두 개만 흉내 냈다. 0x10000000(UART)에 바이트를 쓰면 출력에 붙이고, 0x100000(종료 장치)에 쓰면 멈춘다. 그리고 QEMU 11.1.3에서 세 가지를 받아 비교했다.
- UART 출력 문자열
- 명령어 단위 pc 열:
-accel tcg,one-insn-per-tb=on -d exec,nochain으로 명령어마다 한 줄씩 기록되게 하고, 리셋 ROM(0x1000대) 6개와 종료 뒤의 반복을 뺐다 - 시작과 끝의 레지스터 32개:
-d cpu -dfilter로 첫 명령어와 종료sw직전만 덤프. 모델은 시작 레지스터를 QEMU에서 받아 같은 상태로 출발한다(QEMU의 리셋 ROM이 a1·t0에 값을 남긴다)
| 프로그램 | 명령어 수 | UART | pc 열 | 레지스터 |
|---|---|---|---|---|
| qsort | 38,733 | 같음 | 같음 | 같음 |
| crc32 | 143,474 | 같음 | 같음 | 같음 |
| fib | 339,394 | 같음 | 같음 | 같음 |
| matmul | 420,568 | 같음 | 같음 | 같음 |
| sieve | 134,195 | 같음 | 같음 | 같음 |
pc 열이 같다는 것은 분기·점프가 한 번도 어긋나지 않았다는 뜻이다. QEMU와 모델이 함께 틀리는 경우도 막으려고 crc32·fib·sieve의 답은 Python으로 따로 계산해 맞췄다(zlib.crc32, 6765, 소수 1007개).
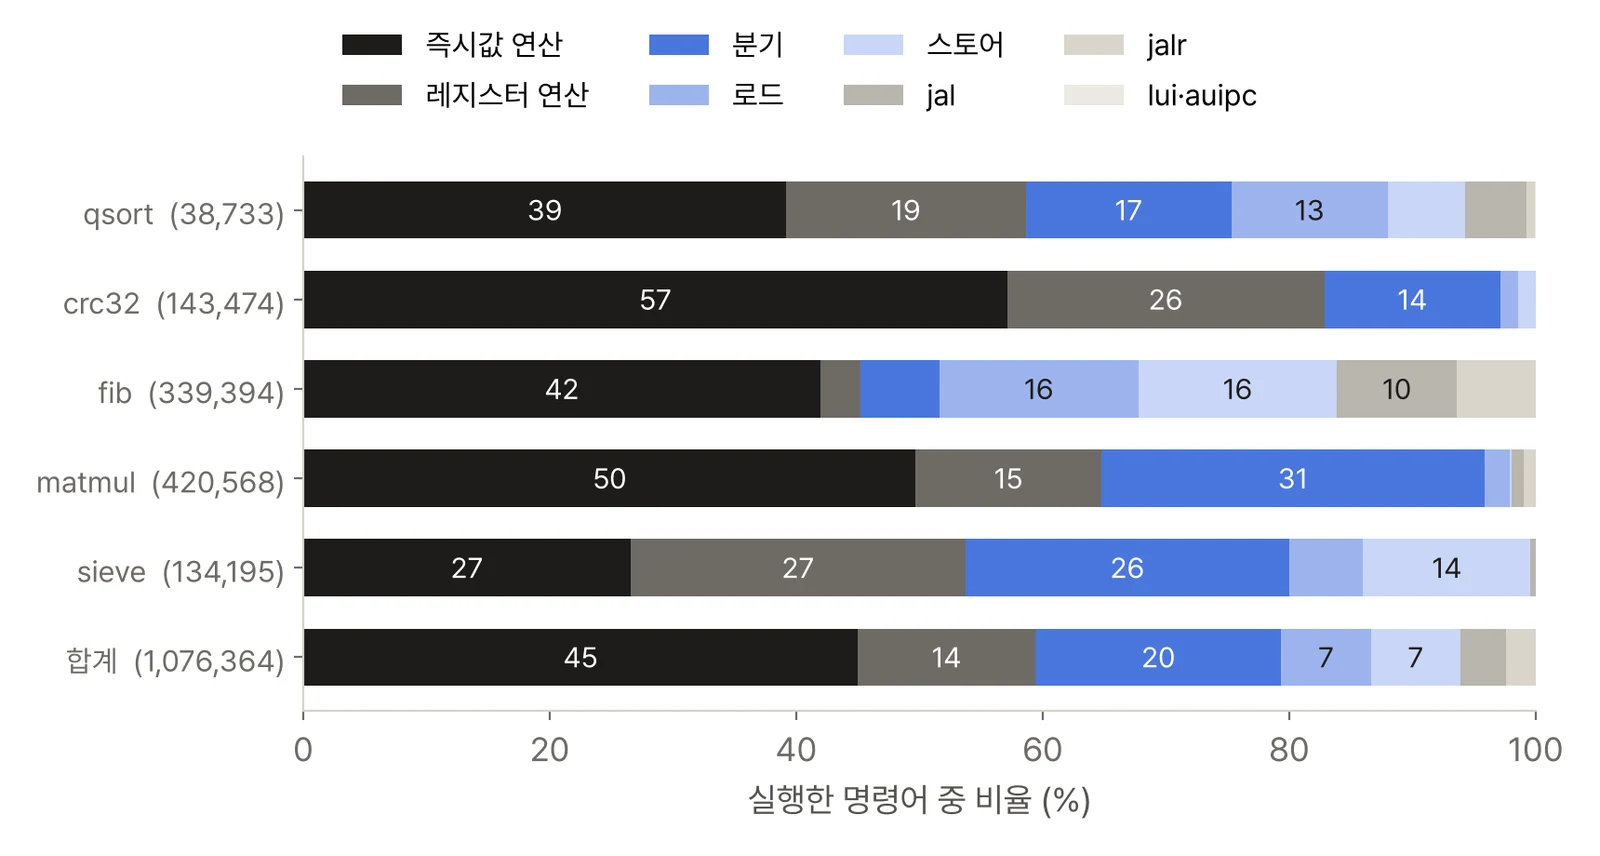
명령어 종류별 비율은 프로그램마다 꽤 다르다. 합계로는 즉시값 연산 45.0%, 분기 20.0%, 레지스터 연산 14.4%, 로드 7.3%, 스토어 7.3%, jal 3.7%, jalr 2.4%였다. lui·auipc는 76개뿐이었다(주소를 처음 한 번 만들 때만 쓰인다). 눈에 띄는 것 두 가지가 있다.
- matmul의 분기 31%. 곱셈이 없으니
__mulsi3가 시프트-덧셈 반복문으로 곱한다. 내부 루프 반복마다 분기가 둘씩 나온다. 19편 M 확장이 이 비율을 바꾼다. - fib의 로드·스토어 16%씩과 점프 16.1%. 호출마다 ra·s0·s1을 스택에 저장하고 되살린다.
jal(호출)과jalr(복귀)이 합쳐 54,729개다.
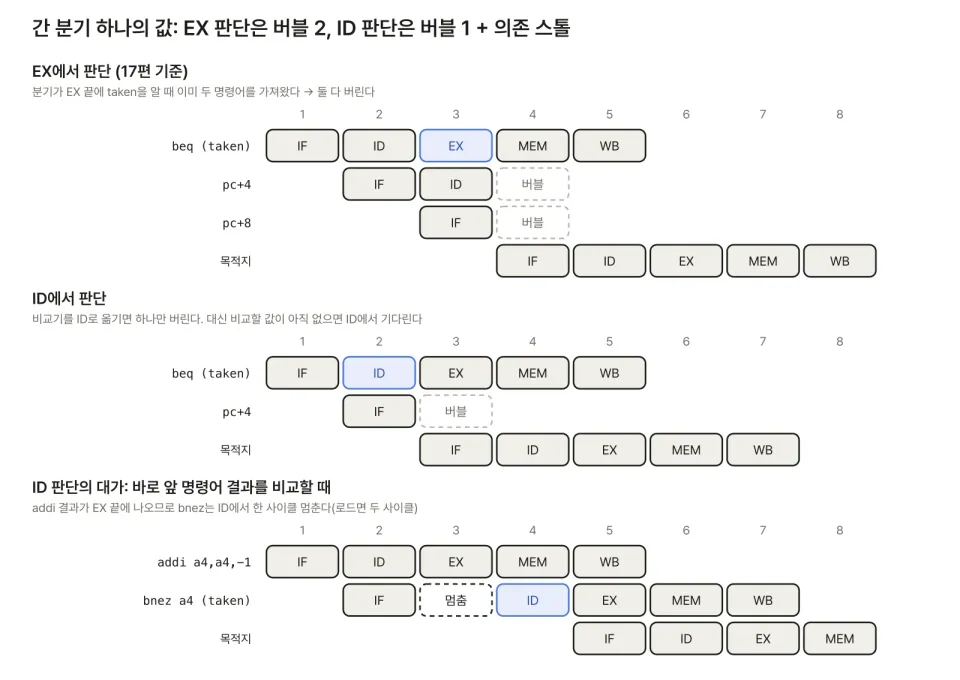
분기 215,007개 중 125,866개(58.5%)가 실제로 갔다. 단일 사이클 코어에서는 이것이 아무 비용도 없다. 다음 pc를 같은 사이클에 고르기 때문이다. 17편에서 파이프라인으로 자르면 "간 분기"마다 사이클을 잃게 되고, 그 손실의 크기가 바로 이 숫자들에서 나온다.
6. 설계 체크리스트: 즉시값 생성기와 단일 사이클 데이터패스
| 항목 | 규칙 |
|---|---|
| 즉시값 부호 | 형식과 무관하게 inst[31]. imm[31]에는 선택기가 필요 없다 |
jalr 즉시값 |
B·J와 달리 2배 하지 않는다(I 형식 그대로). 목적지는 더한 뒤 최하위 비트를 0으로 |
| 분기 목적지 | 그 분기 명령어의 pc 기준. pc+4 기준이 아니다 |
auipc |
그 auipc 자신의 pc를 더한다 |
| x0 | 읽기 0, 쓰기 무시. RegWrite와 rd≠0을 함께 본다 |
| 로드 rd=x0 | 값은 버려도 메모리 접근과 예외는 그대로 일어나야 한다(명세 2.6) |
| 정렬 안 된 목적지 | taken 분기·jal·jalr의 목적지가 4의 배수가 아니면 그 점프 명령어에서 예외(C 없을 때). 레지스터를 쓰기 전에 검사 |
| 안 간 분기 | 목적지가 정렬 안 됐어도 예외 없음 |
| 정렬 안 된 로드·스토어 | 명세는 EEI에 맡긴다. 하드웨어로 처리하거나 예외를 낸다(모델은 그냥 처리) |
| 다음 pc 선택기 | 입력 셋: pc+4, pc+imm, (rs1+imm)&~1. 트랩을 넣으면 mtvec이 하나 더 늘어난다(25편) |
정렬 줄은 18편에서 QEMU와 직접 대조한다. 정렬 안 된 로드·스토어는 명세 2.6이 실행 환경(EEI)에 맡겨 두었다. 작은 코어는 대개 예외를 내고 소프트웨어로 처리하게 한다.
정리
- 즉시값 생성기는 출력 비트 일곱 묶음의 선택기다. 선택 신호는 형식 다섯 개뿐이고, 100만 경우에서 직접 계산과 같았다.
- 단일 사이클 데이터패스는 PC, 명령어·데이터 메모리, 레지스터 파일(2R1W), ALU, 분기 비교기와 선택기 다섯 개로 RV32I 전체를 실행한다. 데이터패스를 넓히는 명령어 종류는
lw부터lui·auipc까지 여덟 단계다. - 모델로 컴파일한 프로그램 5개, 명령어 1,076,364개를 돌려 QEMU와 UART·pc 열·최종 레지스터가 모두 같았다.
- 실행한 명령어의 20.0%가 분기(그중 58.5%가 taken), 6.1%가 점프였다. 파이프라인에서 이 비율이 CPI를 정한다.
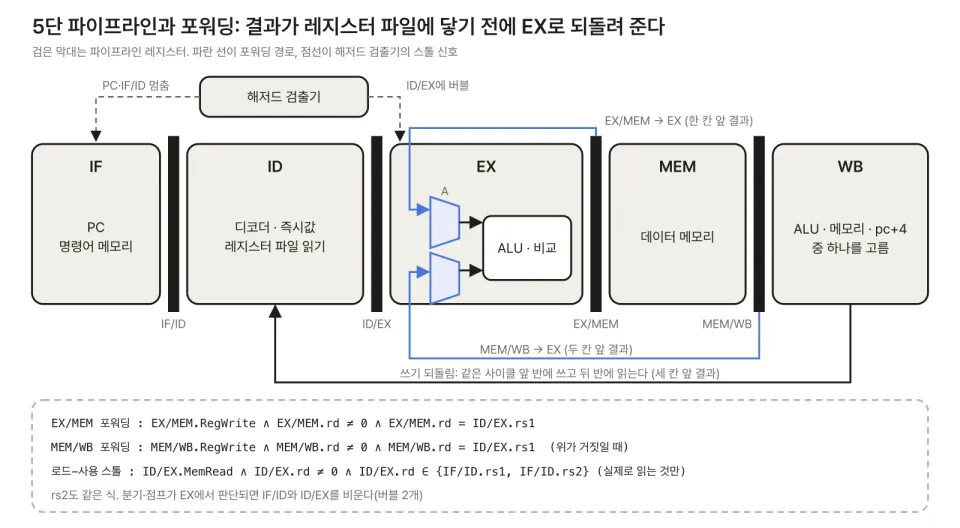
다음 글: 17편에서는 이 데이터패스를 IF·ID·EX·MEM·WB 다섯 단으로 자른다. 파이프라인 레지스터에 무엇을 담는지, 데이터 해저드를 EX/MEM·MEM/WB 포워딩으로 푸는 조건식과 그 식에 rd≠x0이 왜 들어가야 하는지, 로드-사용 스톨과 레지스터 파일의 같은 사이클 쓰기·읽기를 사이클 단위 모델로 확인한다. 같은 프로그램 다섯 개로 포워딩을 켜고 끌 때 CPI가 어떻게 달라지는지도 잰다.
참고 문헌
- The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture, Version 20240411. 2.3 즉시값 인코딩, 2.4 정수 연산(
lui·auipc), 2.5 제어 이동(분기·jal·jalr, 정렬 예외), 2.6 로드·스토어(rd=x0 로드, 정렬). https://github.com/riscv/riscv-isa-manual - D. Harris, S. Harris, Digital Design and Computer Architecture: RISC-V Edition, 2021. 7.3 단일 사이클 프로세서(데이터패스를
lw부터 넓혀 가는 방식, 즉시값 확장) - D. Patterson, J. Hennessy, Computer Organization and Design: RISC-V Edition, 2판, 2020. 4.3 데이터패스 구성, 4.4 간단한 구현 방식
- QEMU
virt보드와 로그 옵션(-d exec,cpu,-dfilter,one-insn-per-tb). https://www.qemu.org/docs/master/system/riscv/virt.html